Úplné zarovnání do bloku je sazba, díky níž se sloupec textu zarovná na levý i pravý okraj, což je vzhled, jaký očekáváte od tištěné knihy nebo formální zprávy. Je snadné jej popsat a překvapivě snadné jej pokazit, protože odpověď na otázku „kam se přidá mezera navíc“ není stejná pro angličtinu jako pro japonštinu, a protože naivní způsob měření každého řádku promění rychlou stránku v pomalou. HotPDF vám prostřednictvím jediného volání pro rozvržení do rámečku poskytuje zarovnání s ohledem na písmo, a pod povrchem tohoto volání se skrývá učebnicová oprava výkonu, které stojí za to porozumět samostatně
Tento článek se věnuje oběma tématům. Zaprvé typografickému pravidlu, které určuje, jak se volný prostor rozděluje u písem s mezerami mezi slovy oproti písmům bez nich. Zadruhé změně v měření, jež snížila náklady na zarovnávání na stránku zhruba osmdesátkrát bez jakéhokoli viditelného rozdílu ve výstupu. Na obojím záleží, pokud generujete dokumenty ve velkém množství a chcete, aby působily jako skutečná sazba, a ne jako neproporcionální výstup uměle roztažený do šířky
Co úplné zarovnání do bloku skutečně vyžaduje
Řádek textu vykreslený ve své přirozené šířce téměř nikdy nedosáhne pravého okraje sloupce. Vždy zůstane zbytek, volný prostor, mezi místem, kde končí poslední glyf, a hranicí sloupce. Zarovnání doleva ponechá tento volný prostor napravo. Zarovnání doprava jej přesune doleva. Zarovnání na střed jej rozdělí. Úplné zarovnání do bloku jej odstraní rozšířením samotného řádku, dokud se oba okraje nedotknou rámečku, a jediný poctivý způsob, jak toho dosáhnout, je rozestoupit glyfy zevnitř
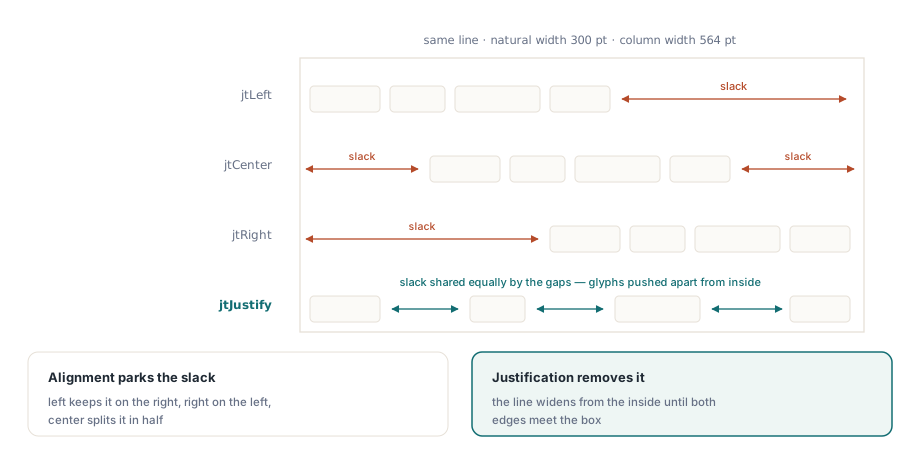
Pravidlo, které odlišuje dobré zarovnání od špatného, je to, kam volný prostor umístíte. Písmo, které zapisuje slova s mezerami mezi nimi, jako je angličtina a zbytek latinkové rodiny, má přirozené švy při každé mezislovní mezeře. Rozšiřování těchto mezer je pro oko neviditelné, protože čtenáři už tak akceptují, že se mezery mezi slovy liší. Písmo, které píše bez mezer mezi slovy, jako čínské znaky Han, japonská kana nebo korejský hangul, takové švy nemá. Tam se musí volný prostor rozložit rovnoměrně mezi sousední glyfy, což je princip, který japonští sazeči nazývají kintou-waritsuke, rovnoměrné mezerování. Umístění latinkového roztahování mezislovních mezer na CJK řádek, nebo natlačení celého volného prostoru na jediné místo, kde CJK řádek náhodou obsahuje mezeru, vytváří řeky a proluky, které prozrazují amatérský výstup
Jak HotPDF rozhoduje, kam mezera patří
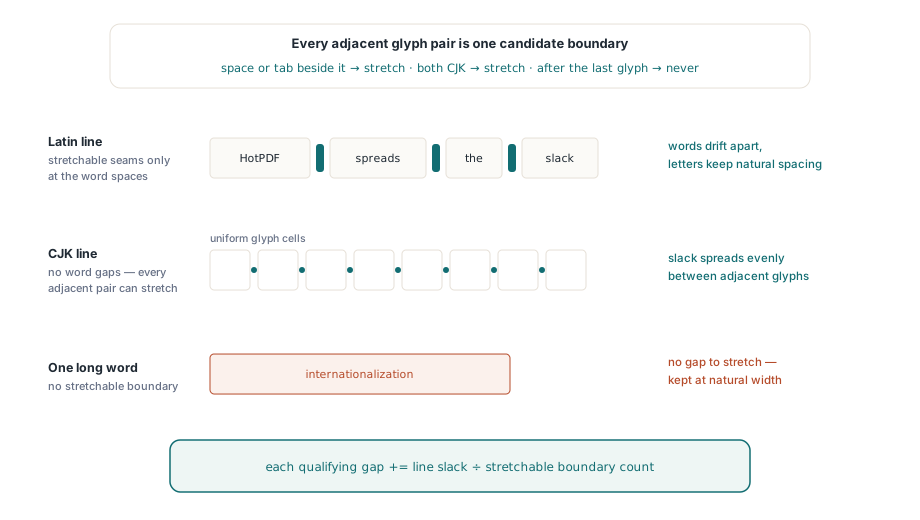
HotPDF toto rozhodnutí dělá pro každou mezeru zvlášť, ne pro celý řádek. Když zarovnává řádek, prochází každou sousední dvojici glyfů a ptá se, zda mezi nimi leží roztažitelná hranice. Hranice je roztažitelná, pokud je na jedné ze stran mezera nebo tabulátor, případ latinky, nebo pokud jsou na obou stranách znaky rozdělitelné v CJK písmu, případ rovnoměrného mezerování. Spočítá tyto hranice, rozdělí volný prostor řádku rovnoměrně mezi ně a přidá tento podíl ke každé kvalifikované mezeře
Důsledek vyplývá zcela přirozeně. Anglický řádek má roztažitelné hranice pouze na mezerách mezi slovy, takže veškerý volný prostor přistane právě tam a slova se od sebe oddálí, zatímco písmena uvnitř každého slova si zachovají přirozenou mezeru. Řádek s písmem Han nebo kana má roztažitelnou hranici mezi téměř každou dvojicí glyfů, takže se volný prostor rovnoměrně rozloží po celém řádku, přesně to rovnoměrné mezerování mezi glyfy, jaké tato písma vyžadují. Řádek, který je jediné dlouhé latinkové slovo bez jakékoli vnitřní mezery, nemá žádnou roztažitelnou hranici vůbec, takže jej HotPDF ponechá v přirozené šířce, místo aby slovo roztrhal písmeno po písmenu. Stejná logika zvládá smíšené latinkové a CJK úseky v jednom řádku bez zvláštního ošetřování, protože rozhodnutí je lokální pro každou hranici
Jedna hranice je záměrně vyloučena vždy a všude. Pozice za posledním glyfem řádku se nikdy nepovažuje za mezeru, protože roztažení na tomto místě by jen znovu zavedlo zbytek na pravé straně, což je pravý opak zarovnání do bloku
Proč se poslední řádek nechává na pokoji
Poslední řádek odstavce je zvláštní a jeho špatné zpracování je nejčastější chybou u zarovnávání do bloku. Poslední řádek odstavce bývá obvykle krátký, často jen několik slov, a jeho roztažení na plnou šířku sloupce rozvleče tato slova přes celou stránku do řídkého, rozbitého řádku. Správná typografie ponechá poslední řádek v jeho přirozené šířce, zarovnaný doleva
HotPDF poslední řádek rozpozná podle pozice. Zatímco zalamuje text do řádků, ví, kdy řádek, který právě oddělil, dosahuje konce zadaného řetězce. Tento poslední řádek se vykreslí s obyčejným zarovnáním doleva a zachová si přirozenou šířku. Každý řádek před ním je zarovnán do bloku na oba okraje. Ruční zalomení řádků, která zapíšete do textu, se respektují tak, jak jsou napsána, takže se ani záměrně krátký řádek nikdy neroztahuje. Čtenář vidí čistý obdélníkový blok textu, jehož poslední řádek přirozeně končí, což je přesně to, co oko očekává
Náklady na měření, které zpomalily zarovnávání
Abyste mohli zarovnat řádek do bloku, musíte znát jeho přesnou šířku a musíte znát posun každého glyfu, abyste mohli přesně umístit dodatečný prostor. První implementace tato čísla získávala zjevným způsobem. Změřila celý řádek úplným Unicode dotazem na šířku, poté měřila prefix za prefixem, aby rozdílem získala posun každého glyfu. Pro řádek o N glyfech to je N+1 volání do měřicího mechanismu, a každé volání je celý GDI výlet tam a zpět, který žádá operační systém, aby text tvaroval a změřil a vrátil odpověď
Na jeden řádek to zní levně. Na celou stránku už ne. Vezměte hustou stránku A4 s běžným textem, zhruba čtyřicet pět řádků o přibližně osmdesáti znacích. Při N+1 výletech tam a zpět na řádek je to kolem 81 výletů pro každý řádek a zhruba 3 645 pro celou stránku, přičemž téměř všechny z nich stráví čas přeměřováním textu, na který se mechanismus díval už před chvílí. U dávkové úlohy, která produkuje tisíce stránek, tato režie dominuje času potřebnému na rozvržení, a každý výlet tam a zpět přechází hranici mezi vaším procesem a grafickým podsystémem
Jedno volání místo N plus jedna
Oprava je typem změny, která vypadá malá, ale přináší velký přínos. GDI už dokáže v jediném dotazu nahlásit celkovou šířku řetězce a pozici každého glyfu. HotPDF to zpřístupňuje přes GetWideCharAdvances, která naplní pole přirozeným posunem každého glyfu, včetně kerningu, a vrátí celkovou šířku, v jednom volání místo N+1. Rutina pro zarovnávání, interně _HPDFEmitJustifiedWideLine, si jednou vyžádá všechny posuny, spočítá volný prostor, rozdělí jej mezi roztažitelné hranice a vykreslí řádek
U téže stránky A4 klesne měření na řádek z asi 81 výletů tam a zpět na jeden, takže stránka klesne ze zhruba 3 645 výletů na asi 45, což je téměř osmdesátinásobné snížení. Výstup je identický bajt po bajtu, protože se na měření nezměnilo vůbec nic kromě toho, kolikrát se o něj žádá. Stejný GDI mechanismus, stejné metriky fontu, stejný kerning dávají stejná čísla. Klesl pouze počet výletů tam a zpět. Když je měření už správné, správná optimalizace spočívá v tom, přestat se na něj ptát opakovaně, ne ho aproximovat
Jak se řádek dostane na stránku
Jakmile je volný prostor rozdělen, HotPDF vykreslí řádek pomocí ExtTextOut a pole posunů pro každý glyf, pole Dx. Každá položka je vzdálenost od počátku jednoho glyfu k dalšímu, což je přirozený posun tohoto glyfu plus jeho podíl volného prostoru, pokud za ním následuje roztažitelná hranice. To se přímo mapuje na zobrazovací model PDF. Umístěný text se zapisuje operátorem TJ, polem, které prokládá běhy glyfů explicitními vodorovnými úpravami, a hodnoty Dx se stanou přesně těmito úpravami. Proto dodatečný prostor přistává mezi glyfy na přesných podbodových pozicích, místo aby byl předstírán výplňovými znaky, a proto zarovnaný řádek HotPDF správně měří, pokud jej následně čte jiný nástroj
Pro zarovnané odstavce nevoláte ExtTextOut sami. Vstupním bodem je WideTextOutBox, která zabalí Unicode řetězec do rámečku a použije zarovnání, o které požádáte. Rozdělí text na řádky, které se vejdou do šířky rámečku, umístí každý řádek dolů po výšce rámečku a vrátí počet znaků, které se jí podařilo vejít, než došel svislý prostor. Zarovnání se volí pomocí výčtového typu pro zarovnání
type
  THPDFJustificationType = (jtLeft, jtCenter, jtRight, jtJustify);
První tři jsou samovysvětlující: zarovnání doleva, na střed a doprava. Čtvrtá, jtJustify, je úplné zarovnání do bloku na oba okraje popsané zde, a je to hodnota, kterou WideTextOutBox čte, aby zapnula mezerování s ohledem na písmo
Zarovnávání odstavce v praxi
Kompletní příklad vytvoří dokument, nastaví font a vlije odstavec do rámečku s úplným zarovnáním do bloku. Stejný kód zarovnává latinkový i CJK text bez změny příznaku, protože povědomí o písmu žije pod úrovní API
uses
  HPDFDoc;

procedure JustifyParagraph;
var
  Pdf: THotPDF;
  Body: WideString;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'Justified.pdf';
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', 11);

    Body :=
      'Full justification spreads the slack on each filled line so both ' +
      'edges meet the column, while the last line keeps its natural width. ' +
      'For scripts with word gaps the space lands between words; for ' +
      'scripts without them it spreads evenly between glyphs.';

    // X, Y, řádkování, šířka rámečku, výška rámečku, text, zarovnání
    Pdf.CurrentPage.WideTextOutBox(72, 72, 4, 380, 240, Body, jtJustify);

    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
Abyste stejný blok nakreslili zarovnaný doleva, na střed nebo doprava, změňte jen poslední argument na jtLeft, jtCenter nebo jtRight. Zalamování, umístění řádků a návratová hodnota zůstávají stejné. Změřená šířka, která pohání všechny čtyři cesty, pochází z GetWideTextWidth, dotazu na šířku s ohledem na Unicode, který správně změří WideString, zatímco starší bajtové měření by špatně změřilo cokoli za Latin-1, což je přesně to, co umožňuje rámečku od začátku správně zalamovat CJK text a text se surogátními páry
Zarovnávání do bloku je jedna vrstva většího zásobníku pro tvarování textu. Když řádek obsahuje písma, která přeuspořádávají nebo spojují své glyfy, rozhodnutí o mezerování zde navazují na práci popsanou v našem článku o tvarování textu pro složitá písma, a když font nese typografické varianty, které chcete vybrat, podívejte se, jak ovládat stylistické alternativy OpenType GSUB. To vše je součástí HotPDF Delphi komponenty pro Delphi a C++Builder, spolu s širšími API pro text, rozvržení a dokumenty popsanými napříč tímto blogem
