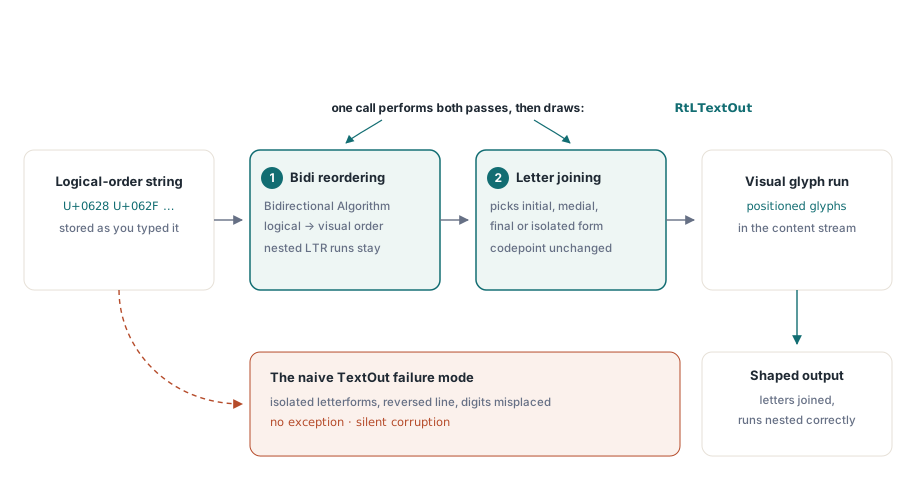
Předejte arabskou frázi يوضح ملف PDF funkci TextOut a otevřete výsledek. Písmena běží nesprávným směrem a každé z nich stojí ve své izolované podobě s viditelnou mezerou před dalším, jako by někdo psal anglicky pozpátku a mezi každým znakem stiskl mezerník. Nebyla vyvolána žádná výjimka. Nevypsalo se žádné varování. Výstup je jednoduše špatně a je špatně, protože dvě oddělené transformace, na kterých arabština závisí, nikdy neproběhly. Znalost toho, jaké tyto dvě transformace jsou a které volání je provádí, je většinou tím, o čem výstup PDF pro komplexní písma (complex-script) ve skutečnosti je
HotPDF je nativní VCL PDF komponenta pro Delphi a C++Builder a vykonává práci směrem zprava doleva (right-to-left) za vás prostřednictvím odlišného volání. Také se ale zastaví na několika specifických místech, o kterých byste měli vědět předtím, než dané locale slíbíte. Tento článek proto mapuje koncepty a poctivé hranice; praktické nastavení pro samotné volání najdete v referenčním článku o RtLTextOut
Proč se i správný řetězec vytiskne chybně
Unicode uchovává text v logickém pořadí, v jakém jej píšete a čtete nahlas. Vykreslovač (renderer) musí naopak umístit piktogramy (glyphs) ve vizuálním pořadí. Pro písma psaná zleva doprava se tato pořadí shodují a nikdo nad tím nepřemýšlí. U arabštiny a hebrejštiny se neshodují, a když se v jednom řádku smíchají směry (např. arabská věta nesoucí latinkový token "PDF" nebo cena zapsaná číslicemi), algoritmus Unicode Bidirectional Algorithm (UAX #9) přesně rozhoduje o tom, jak se fragmenty psané zleva doprava zanoří do řádku zprava doleva. To je první transformace, takzvané přeřazení (reordering), a její vynechání je důvodem, proč se řádek převrátí
Druhým bodem je kontextuální formování (contextual shaping). Arabské písmeno se kreslí odlišně v závislosti na tom, kde se ve slově nachází: počáteční, střední, koncová nebo samostatně stojící podoba. Samotný bod kódu (codepoint) zůstává v celém textu stejný, mění se pouze tvar písmene (glyph). Datová pipeline, která každý kód předá rovnou na jeho výchozí glyph, vyprodukuje přesně onen nespojitý výstup izolovaných forem popsaný v úvodním odstavci. Hebrejština tento krok přeskakuje, protože její písmena se nespojují, ale stále potřebuje přeřazení (reordering). Arabština potřebuje obojí, a to je ten důvod, proč byste měli testovat arabštinu, a ne hebrejštinu
Na desktopu nic z toho není váš problém. Když VCL formulář vykreslí arabštinu do prvku TEdit, textový zásobník operačního systému ji tiše přeřadí a zformuje. A to je přesně ten důvod, proč řetězec, který vypadá na obrazovce perfektně, vyjde v naivním PDF rozbitý. Záznam obsahu (content stream) v PDF neukládá editovatelný text. Ukládá pozičně umístěné glyphy, takže ten, kdo záznam obsahu generuje, dědí práci formování textu (shaping), kterou dříve zvládal operační systém. RtLTextOut je volání, které si tuto práci bere zpět
Co za vás zformuje RtLTextOut
HotPDF udržuje cestu pro latinku a cestu pro složitá písma (complex-script) jako dvě odlišné metody. TextOut vytiskne, co mu předáte, přesně v pořadí, v jakém mu to předáte. RtLTextOut provede nejprve obě transformace – obousměrné (bidirectional) přeřazení přes celý řádek a kontextuální analýzu pro spojující se písma – a poté text vytiskne. Která pravidla písma se uplatní, je určeno pomocí znakové sady písma (charset) místo samotného volání, takže směr je explicitní volbou při každém volání (call site) a ne pouhým odhadem znaků. Nastavení parametr po parametru, hodnoty znakových sad, kroky pro registraci fontů a kompletní zkompilovatelný příklad jsou obsaženy v referenčním článku o RtLTextOut. Zde se zaměříme na to, co dané transformace znamenají, kde končí a jak ověřit, že zafungovaly
Jedno pravidlo použití má zásadní význam i na této úrovni: vstupní text musí být v logickém pořadí. To proto, že RtLTextOut provádí obrácení textu sám. Pokud byste vložili řetězec, který jste již ručně otočili, vyjde dvojnásobně převrácený. Referenční článek prochází tuto past a způsoby její nápravy. Důvod, proč o této pasti padla zmínka zde, je skutečnost, proč tak snadno projde testováním. Dvojnásobně převrácený čistě arabský řetězec může vypadat naprosto správně a rozpadne se, až když je na řádku latinkové slovo nebo číslo. Tyto vložené znaky se pak totiž nezanořují tak, jak diktuje standard UAX #9. Problém v tomto případě není ve vykreslování, ale v podstrčení algoritmu textu, který už byl z poloviny zpracován
Stejné chování s kombinovaným směrem plete recenzenty častěji než kód. Uvnitř řádku psaného zprava doleva se číslice a vložená latinská slova stále čtou zleva doprava. Někdo, kdo nepracoval s obousměrným rozložením, se podívá na vygenerovanou fakturu, uvidí číslo účtu zobrazené „špatným“ směrem vzhledem k arabštině kolem něj a nahlásí to jako chybu. Jde přitom o výsledek přesně podle specifikací (spec-correct). Krátká poznámka do kritérií přijetí, sepsaná před první kontrolou rodilým mluvčím, ušetří tento oboustranný problém
Kdy přeřazování a spojování stačí a kdy ne
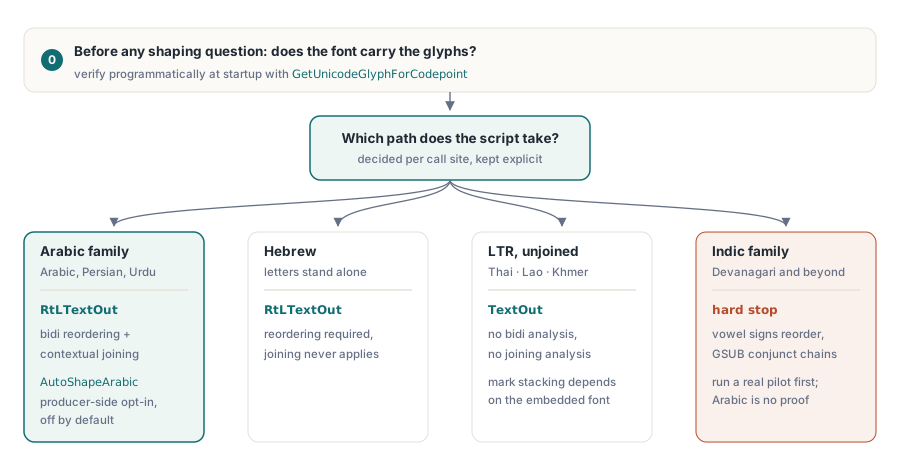
U arabského a hebrejského běžného textu (running text) – sestavy, faktury, smlouvy, dopisy – jsou přeřazování a kontextové spojování celou prací, kterou musí program odvést, a funkce RtLTextOut ji zvládne sama. Hranice se objeví ve chvíli, kdy typografie vyžaduje něco víc než jen spojování (joining). Odpovědí knihovny HotPDF na straně arabštiny je možnost zapnutí tvarovače (shaper) na straně producenta. Pokud nastavíte parametr AutoShapeArabic := True, komponenta přepíše běh textu logického pořadí (logical-order run) do tvarů Unicode Presentation Forms, a to před průchodem obousměrného procesu. K zjišťování tvarů napojení tak dochází podle logických sousedů a spojování ligatur (ligature folds) je zapsáno rovnou do kódových bodů (codepoints), jež s sebou PDF nese, namísto toho, aby to zbylo k vyřešení až na prohlížeči. Přepínač je výchozím nastavením vypnut a v případě jeho vypnutí je datový výstup bytově stabilní. K jeho zapnutí se uchýlíte podle rozhodnutí (document pipeline), ne v podobě obecného nastavení aplikace. Stejný model opt-in možností platí pro další spojovaná zprava-doleva-psaná písma, jež HotPDF zvládá formovat. Syrština (Syriac), N'Ko, adlamské písmo (Adlam) a haniacké rohingské písmo (Hanifi Rohingya) mají každý svůj vlastní přepínač na automatické tvarování (auto-shape), které slouží jako ekvivalent arabského přepínače
Volitelné vlastnosti OpenType jsou znovu jiným mechanismem. Volitelné ligatury a podobné vlastnosti typu jednoduché substituce procházejí přes GetSingleSubstituteGlyph(GID, 'liga'), který vyřeší jednu substituci najednou – nejprve vstupní ID glyphu, poté značka vlastnosti – a vrátí vstupní glyph nezměněný, když se vlastnost neuplatní. To stačí k obsluze známého, konečného seznamu ligatur, který si udržujete sami. Není to plný engine GSUB a rozdíl je přesně tam, kde velkolepé lokalizační plány selhávají: pipeline, která bezchybně formuje arabštinu, prokázala přeřazení a spojování, nic víc
Pokrytí písem
Arabština cvičí obě transformace, proto je to řetězec, se kterým se má testovat, a proto je úspěšný arabský test nejsilnějším jednotlivým důkazem, že pipeline funguje. Hebrejština potřebuje přeřazení, ale ne spojování, protože její písmena stojí osamoceně; pokud se hebrejština vykreslí správně a arabština vyjde nespojená, obousměrná polovina je v pořádku a kontextuální polovina se nikdy nespustila. Perština a urdština jedou na arabském písmu a dědí jeho chování, jenže urdská obliba stylu Nastaliq je rozhodnutím o fontu s důsledky pro čitelnost, které by měl posoudit rodilý mluvčí
Thajština leží zcela na druhé straně hranice. Běží zleva doprava, takže nepotřebuje žádnou obousměrnou práci, a její písmena se nespojují, takže nepotřebuje kontextuální analýzu; thajské řetězce procházejí běžnou cestou TextOut jako latinka. Co thajština má, jsou skládané znaky – samohlásky a tónové značky nad i pod základní souhláskou – a to, zda sedí správně, závisí na tom, zda font staví své kombinované značky tak, aby se skládaly bez pomoci formovacího enginu. Většina vyhrazených thajských fontů to umí. Testujte s přesným fontem, který budete vkládat, ne s něčím podobným
Devanágarí a zbytek indické rodiny jsou poctivá tvrdá hranice. Jejich znaky samohlásek se přeřazují kolem shluků souhlásek a jejich konjunkce vznikají řetězci kontextově závislých substitucí, což je plné území GSUB, za hranicí přeřazování a spojování. Pokud je indické locale na plánu, spusťte skutečný pilot na reálných zákaznických řetězcích dříve, než jej slíbíte – fungující arabština není důkazem, že bude fungovat devanágarí. Řetězce CJK, vietnamština se svými skládanými diakritikami a smíšený evropský text berou všechny obyčejnou cestu bez obousměrné analýzy a vyplatí se udržovat tyto dvě cesty v reportovacím kódu fyzicky oddělené, jedna rutina pro RTL běhy a druhá pro vše ostatní, takže logika locale je vidět na místě volání, místo aby se skrývala za příznakem, který někdo zapomene nastavit
O pokrytí glyphů je rozhodnuto ještě před spuštěním formování
Formování vybírá glyphy z fontu. Pokud je font nenese, není z čeho vybírat, a proto je klasické selhání nasazení – bezvadné na stroji vývojáře, prázdné čtverečky na serveru zákazníka po tichém nahrazení fontu – problémem pokrytí, nikoliv formování. Praktický lék, registrace fontu, který dodáte s aplikací, místo důvěry v to, co má cílový stroj náhodou nainstalované, je rozveden krok za krokem v referenčním článku. Koncepční pointa zní, že pokrytí musí být stanoveno dříve, než má vůbec nějaká otázka formování smysl, a že je lze stanovit programově, místo odhadování z výstupu okem
// Po RegisterUnicodeTTF ověřte pokrytí pro
// kódové body, které vaše data skutečně používají
GID := Pdf.GetUnicodeGlyphForCodepoint($0628);  // U+0628 ARABIC LETTER BEH
LogGlyphAudit($0628, GID);
Samotná registrace nese dvě omezení – spodní hranici PDF 1.5 pro vkládané zpracování Unicode a bity oprávnění fontu ke vkládání – obě popsané vedle kroků nastavení v referenčním článku o RtLTextOut. Sem patří návyk auditu: GetUnicodeGlyphForCodepoint je váš systém včasného varování. Projděte rozsahy kódových bodů, které vaše data skutečně používají, při startu služby a zalogujte, jaká ID glyphů se vrátí. Mezera v pokrytí se pak ukáže jako řádek ve startovacím logu během nasazování, a ne jako chybějící znaky ve faktuře, která už zákazníka došla
Směr čtení patří dokumentu, nikoliv glyphům
Mít každý glyph správně stále něco ponechává nevyřešené. ISO 32000-1 §12.2 definuje předvolbu prohlížeče zvanou /Direction, která vyjadřuje celkový směr čtení dokumentu. Nedotýká se žádných glyphů. Říká prohlížeči, jak uspořádat dvoustránkové roztěžení, kterou stranou má začít rozvržení protilehlých stránek a kterým směrem se má naklánět čtecí rozhraní. Nic z toho není na jedné stránce vidět, což je přesně důvod, proč se to zapomíná
// Deklarujte směr čtení zprava doleva na úrovni dokumentu
Pdf.Direction := RightToLeft;  // přidává vpDirection do ViewerPreferences
Nastavení Direction je celá práce: setter vlastnosti přidá vpDirection do ViewerPreferences dokumentu, takže jediný řádek ponese předvolbu do souboru. Pokud text vychází přes RtLTextOut, máte to zdarma, protože volání přepíná směr dokumentu jako vedlejší efekt – referenční článek popisuje, kdy to smíšený dokument potřebuje zrušit. Případ, kdy si to musíte nastavit sami, je dokument psaný zprava doleva vyrobený jakýmkoli jiným způsobem, třeba ze vstupu, který jste předformovali v předcházející vrstvě a nakreslili běžnou cestou. Vynechejte to tam a jednostránkový důkaz, na který se díváte, bude vypadat v obou případech stejně; pak někdo vytiskne oboustrannou brožuru, roztěžení vyjde zrcadlově převrácené a příčinou bude chybějící jednořádkový zásah z týdnů zpátky
Ověření zformovaného výstupu
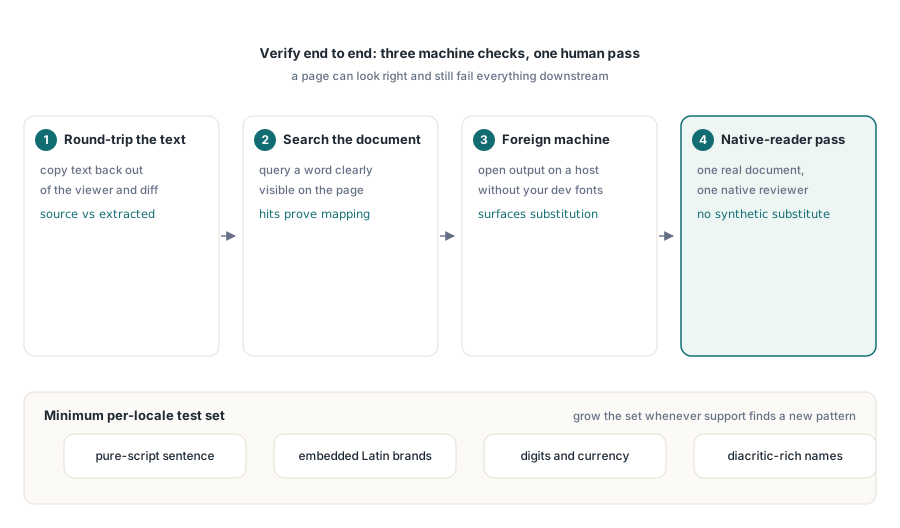
Ověřujte od začátku do konce, protože stránka může vypadat správně a přesto být nepoužitelná pro všechno dál v řadě. Tři kontroly odhalí většinu problémů. Zkopírujte text z Acrobatu zpět ven a porovnejte kódové body proti zdrojovému řetězci. Spusťte vyhledávání v dokumentu ve prohlížeči pro slovo, které na stránce vidíte. A otevřete výstup na stroji, který nemá vaše vývojové fonty – ten nejsprawpodobněji odhalí substituci. Nic z toho nenahradí rodilého mluvčího, který se podívá na jeden skutečný dokument a chytí věci, které žádný syntetický korpus nechytí. Naplánujte si tuto revizi do kalendáře dříve, než formát vyjde
Vyberte testovací řetězce záměrně, místo recyklace toho, co loni poslal překladatel. Zvládnutelné minimum na locale: věta v čistém písmu, věta s vloženými latinskými názvy značek, řádek nesoucí číslice a měnu a jména s diakritikou nebo kombinovanými značkami. Skutečná zákaznická jména rozbijí předpoklady, které výplňový text nechá netknuté, takže nechte regresní sadu růst o jeden řetězec pokaždé, když podpora odhalí vzorec, který jste dosud neviděli
Registrace fontů, vytváření podskupin (subsetting) a každodenní API pro kreslení textu jsou popsány v článku o reportovacím výstupu, fontech a obrázcích s HotPDF. Když musí tytéž dokumenty splňovat i přístupnostní profily, jazykové značkování a pravidla struktury z článku o validaci PDF/A a PDF/UA stojí na vrcholu formovací práce popsané zde
API pro směr zprava doleva a Unicode fonty popsaná výše se dodávají s komponentou HotPDF pro Delphi a C++Builder; produktová stránka odkazuje na plnou referenci výstupu textu