HotPDF převádí HTML do stránek PDF pomocí THPDFHTMLImporter.RenderHTML5, verzovaného profilu pro stránkovaná média se skutečným DOM, skutečnou kaskádou CSS, tabulkami, zalomením stránek a volitelným generováním AcroForm z prvků HTML formulářů. Běží zcela v procesu: žádný prohlížečový engine, žádný Chromium, žádný externí konvertor a ve výchozím nastavení žádný přístup k souborům ani síti
Důvod, proč existuje samostatný vstupní bod místo vylepšené metody RenderHTML, je kompatibilita. Starší metoda vykresluje faktury a dopisy v produkčních aplikacích už léta a tolerantní DOM s plnou kaskádou by změnil výstup dokumentů vyladěných na starší chování. Starší metoda si proto zachovává přesně svou sémantiku a vše nové žije za metodou RenderHTML5, jejíž verzi profilu hlásí HTML5ProfileVersion a jejíž podporované milníky vypisuje HTML5ProfileMilestones
Co profil HTML5 skutečně přidává?
V praxi mají význam čtyři schopnosti. Strukturální DOM, kde jsou html a body kontejnery, nikoli textové uzly. Kaskáda CSS se správnou prioritou. Rozvržení tabulek. A explicitní řízení zalomení stránek, což je přesně to, co znamená "stránkovaná média": HTML bylo navrženo pro posuvné zobrazení a rozdělení na stránky vyžaduje rozhodnutí, kde smí obsah zlomit
Bod o kontejnerech zní jako implementační detail, přitom je to rozdíl mezi tím, zda to funguje, nebo ne. Pokud se kořenové elementy chovají jako textové kontejnery, celý DOM se v okamžiku parsování zhroutí do jednoho textového bloku a každé pravidlo stylu, zalomení stránky, tabulka a podstrom formuláře se pak aplikuje na nic. Jakýkoli renderer HTML, který ze strukturovaného dokumentu vyprodukuje jednu nerozlišenou stěnu textu, udělal přesně tuto chybu
Pořadí kaskády, vysvětlené krok za krokem
Priorita CSS není jedno jediné třídění. HotPDF aplikuje normální deklarace z odpovídajících pravidel v pořadí podle specifičnosti a pak podle pořadí ve zdroji, poté aplikuje vloženě normální deklarace navrch, dále deklarace !important z odpovídajících pravidel a nakonec vložené !important. Čtyři průchody v tomto pořadí
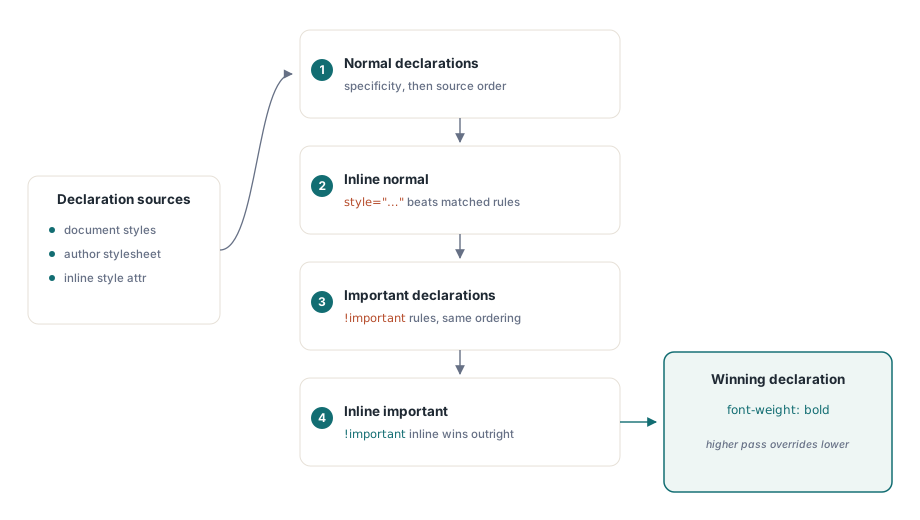
Implementace, které toto zjednoduší na "vyhrává poslední", zvládnou běžné případy správně a zajímavé případy špatně, což je horší než chybovat všude stejně, protože chyba se projeví jen u šablon, které používají !important k přepsání základního stylopisu — přesně u šablon psaných lidmi, kteří očekávají, že kaskáda bude fungovat:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // body
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // vykreslit ovládací prvky, ne vytvářet pole

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
Druhý argument je autorský stylopis aplikovaný vedle toho, co nese samotný dokument, což je čistý způsob, jak vynutit firemní pravidla, jako jsou okraje stránky a kontrola sirotků, aniž byste upravovali každou šablonu
Proč importér nikdy nic nestahuje?
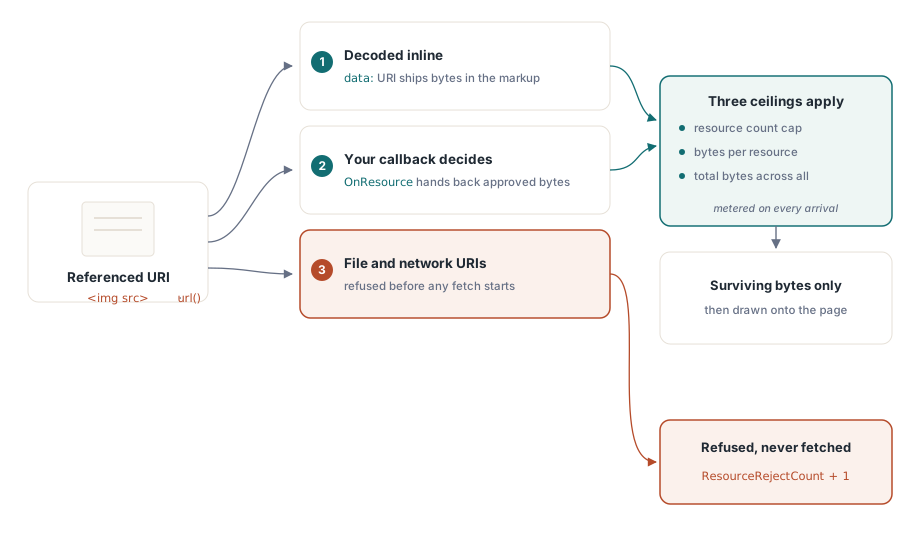
Konvertor HTML do PDF, který řeší externí odkazy, je server-side request forgery engine v převleku za nástroj na generování dokumentů. Namiřte ho na uživatelem dodaný markup a rád stáhne http://169.254.169.254/ nebo file URL z vašeho aplikačního serveru a vloží výsledek do PDF, které si někdo stáhne
HotPDF proto ve výchozím nastavení nečte ani soubory, ani síť. Obrázky a další zdroje přicházejí přesně dvěma způsoby: jako data: URI uvnitř markupu, nebo přes callback OnResource, kde váš kód rozhodne, co URI znamená, a dodá bajty:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // Poskytujte pouze z adresáře lokálních assetů na povoleném seznamu.
  // Nikdy nepředávejte URI HTTP klientovi a nikdy ho nepřipojujte
  // k cestě bez předchozí validace
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
Každý zdroj, který skutečně dorazí, se stále počítá proti třem samostatným stropům: kolik zdrojů, kolik bajtů má každý z nich a kolik bajtů celkem. Callback, který věrně vrací cokoli, o co je požádán, nelze donutit k vyčerpání paměti dokumentem, který odkazuje na stejný 50MB obrázek dvě stě krát
Čtyři rozpočty, jeden způsob selhání
Uzly parseru, pravidla CSS, operace rozvržení a zdroje se měří nezávisle, protože selhávají nezávisle. Dokument může být malý a přitom patologicky nákladný na rozvržení; jiný může být mělký se stylopisem navrženým tak, aby explodoval porovnávání selektorů. Vyčerpání kteréhokoli z nich vyvolá EHPDFHTMLImportBudget, vyhrazenou třídu výjimky, aby bylo možné vyčerpání rozpočtu odchytit odděleně od poškozeného vstupu
Statistiky se resetují na začátku každého volání RenderHTML5, takže čísla popisují jeden import, nikoli celou životnost objektu importéru. Ve službě, která vykresluje nedůvěryhodné šablony, logujte na dokument ParsedNodeCount, LayoutOperationCount a ResourceRejectCount: rostoucí počet odmítnutí obvykle znamená, že autor šablony odkazuje na assety, které váš callback nerozpozná, a počet operací rozvržení blízko stropu znamená, že příští o něco větší dokument selže
Výběr mezi importem HTML a layout API
Import HTML vyhrává, když obsah autorizují jako HTML lidé, kteří nejsou vývojáři v Delphi, když se šablony mění častěji než kód, nebo když stejný obsah musí být také odeslán e-mailem. Deklarativní strom rozvržení popsaný v článku deklarativní rozvržení PDF se značkovaným výstupem vyhrává, když je dokument generován z dat vaším vlastním kódem, když potřebujete automaticky emitovanou strukturu PDF/UA, nebo když na přesné kontrole stránkování záleží víc než na pohodlí autorizace
Nejsou vzájemně vylučující. Běžný vzor je import HTML pro tělo reportu, s hlavičkou, patičkou a podpisovými bloky vykreslenými přímo, protože jde o pevnou geometrii, kterou by neměla vlastnit žádná šablona. Tabulky jsou jedna oblast, kde se vyplatí měřit obojí: složité finanční tabulky se někdy stránkují lépe přes vyhrazenou cestu pro tabulky popsanou v článku generování tabulek v PDF
Nastavte CreateAcroForms vědomě. Vypnuto, ovládací prvky formulářů HTML se vykreslí jako statická grafika, což je to, co chce tištěný výpis. Zapnuto, stanou se skutečnými interaktivními poli AcroForm, což je to, co chce vyplnitelný formulář, a navazující chování polí popisuje článek přidávání polí formuláře do načteného PDF
Import HTML, deklarativní rozvržení a API pro přímé kreslení cílí v Delphi a C++Builder na stejný objekt dokumentu; úplný seznam funkcí najdete na stránce komponenty HotPDF Delphi PDF component