PDF Library for Delphi zapisuje rozsahy page labels přes AddPageLabels a od v3.539.10 tohle volání funguje i na načtených souborech, jejichž /PageLabels number tree se dělí na uzly /Kids: kořen se zploští na jediný list /Nums, než nový rozsah vstoupí, takže label se v prohlížeči skutečně ukáže, místo aby byl potichu ignorován. Typická oběť je knižní PDF z layoutového nástroje, s římskými čísly v úvodu, arabskou numerací v těle a přílohou označenou A-1, A-2, kde jste chtěli přejmenovat jen přílohu a nic se nezměnilo
Co jsou PDF page labels a jak se ukládají?
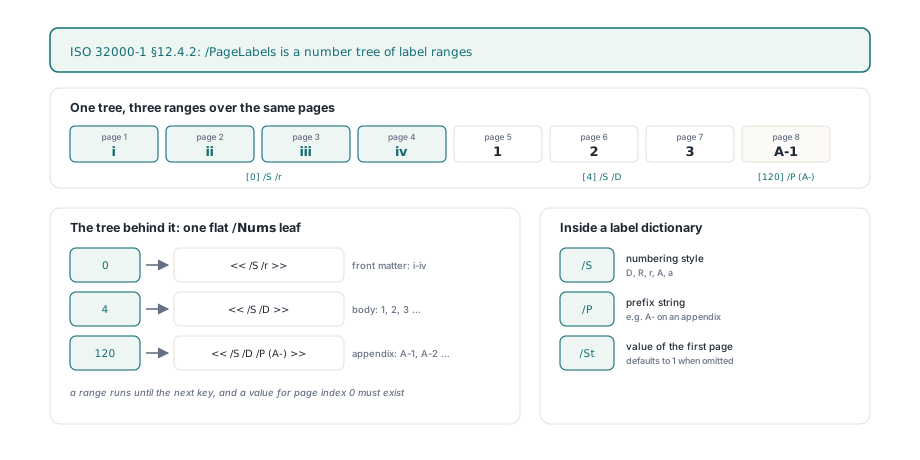
Page labels jsou řetězce, které prohlížeč ukazuje ve svém políčku stránek místo fyzického indexu stránky, a ISO 32000-1 §12.4.2 je ukládá jako number tree pod catalog klíčem /PageLabels. Každý klíč je 0-based index stránky, který otevírá labeling rozsah, a každá hodnota je page label slovník s nejvýše třemi položkami: /S pro styl číslování (D, R, r, A nebo a), /P pro prefixový řetězec a /St pro číselnou hodnotu první stránky v rozsahu, která defaultně stojí na 1. Rozsah běží do dalšího klíče a specifikace vyžaduje, aby strom obsahoval hodnotu pro index stránky 0, takže každá stránka spadá do nějakého rozsahu
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Stránky 1-4: i, ii, iii, iv (římské malé)
    Lib.AddPageLabels(1, 3, 1, '');
    // Stránky 5-120: 1, 2, 3 ... (desítkové)
    Lib.AddPageLabels(5, 1, 1, '');
    // Stránky 121 dál: A-1, A-2 ... (desítkové s prefixem)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) namapuje své argumenty na tenhle slovník bez překvapení, jakmile znáte tři pravidla. Start je 1-based jako každý jiný page argument v knihovně a do stromu se zapisuje jako Start - 1. Style běží od 0 do 5, kde 0 znamená jen prefix a 1 až 5 se stanou hodnotami /S D, R, r, A a a; cokoli mimo tenhle rozsah vrátí 0 a nic nedotkne. Offset se stane /St jen když je větší než nula, takže 0 prostě klíč vynechá a prohlížeč spadne zpátky na defaultní 1. Protože page labels přišly s PDF 1.3, volání navíc spustí EnsureMinVersion('1.3', '/PageLabels'), které zvýší výstupní verzi staršího souboru, pokud jste si save verzi explicitně nezamkli
Proč nové page labels zmizí, když strom má /Kids?
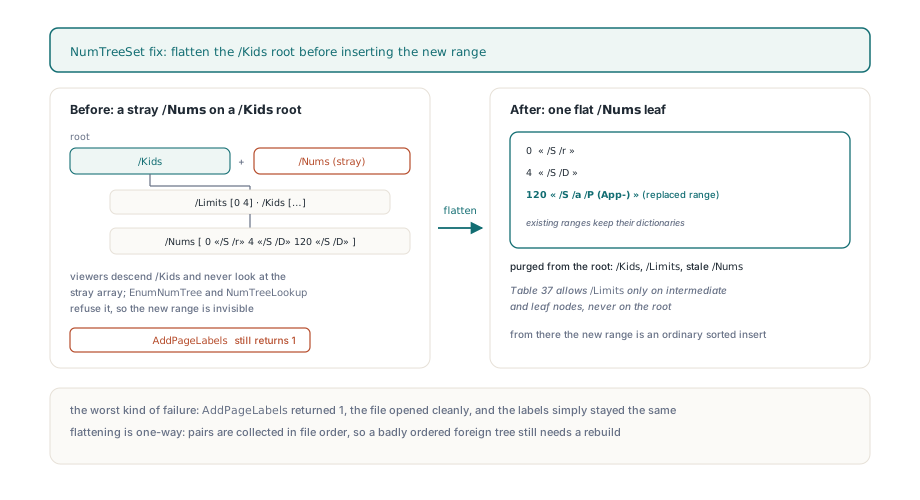
Nové labely mizí proto, že ISO 32000-1 §7.9.7 (Table 37) dovoluje kořeni number tree nést buď /Kids, nebo /Nums, nikdy obojí, a starší helper NumTreeSet uměl hledat jen /Nums. Producenti dlouhých dokumentů často dělí strom do mezilehlých uzlů, každý s párem /Limits, a věší je na kořen, který má jen /Kids. Starý kód na tom kořeni žádné /Nums nenašel, vytvořil čerstvé vedle existujících /Kids a vložil nový rozsah tam. Výsledkem byl kořen se dvěma vzájemně výlučnými vstupy. Prohlížeče sestupují přes /Kids a o zbloudilém poli se nikdy nezajímají, vlastní EnumNumTree knihovny taky kontroluje nejdřív /Kids a NumTreeLookup odmítá uzel, kde HasKids xor HasNums neplatí. AddPageLabels pořád vrátilo 1 a uložený soubor se pořád čistě otevřel, což je ta nejhorší varianta selhání: nic si nestěžuje, labely se prostě nezmění
Oprava v NumTreeSet převede kořen na list, než cokoli vloží. Když kořen nese /Kids, EnumNumTree projde každý list v pořadí a sesbírá každý pár klíč–hodnota, z toho seznamu se postaví nové ploché pole /Nums a /Kids, /Limits a případné zastaralé /Nums se z kořene vyčistí, než se ploché pole připojí. Upuštění /Limits není kosmetika, protože Table 37 dovoluje tu položku jen na mezilehlých a listových uzlech, nikdy na kořeni. Od té chvíle je vkládání obyčejným setříděným insertem do jednoho pole a existující rozsahy přežijí se svými původními label slovníky. Ten kompromis je záměrný: strom se potom znovu nestaví do vyvážených uzlů /Kids. U page labels to nic nestojí, protože i velká referenční příručka má málokdy víc než pár desítek rozsahů a jediný list píše stejně většina producentů
// Přejmenovat přílohu v souboru, jehož /PageLabels kořen používá /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // např. A-1
  // Nahradit rozsah začínající na stránce 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Existující římské a desítkové rozsahy jsou pořád ve zploštělém listu
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, nezměněno
end;
Jak se může pole /Nums špatně číst jako klíče?
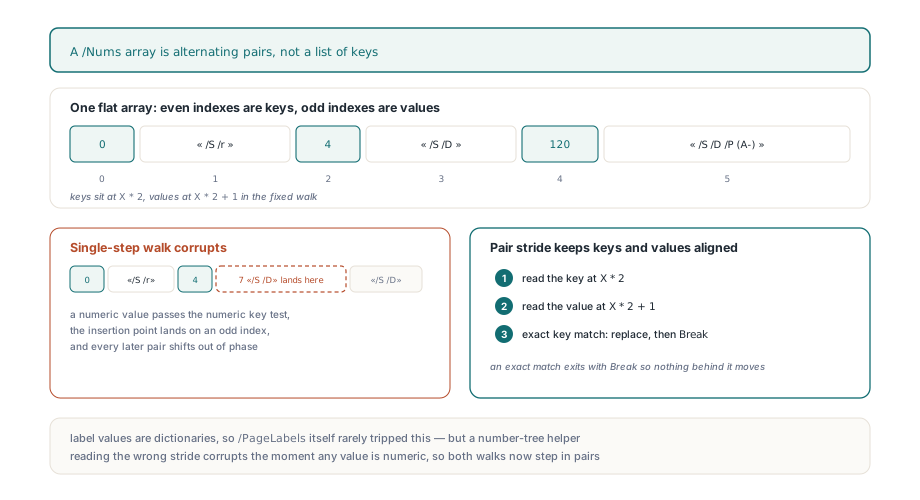
Pole /Nums se čte špatně, když ho kód projíždí po jednom prvku, protože pole je plochý běh střídajících se párů [key0 value0 key1 value1 ...] a za klíče platí jen sudé pozice. Stará smyčka NumTreeSet testovala na numerický typ každý prvek, takže hodnota, která náhodou byla číslo, se srovnávala, jako by byla klíč; zásah menší může dát bod vložení na lichý index a upustit nový pár doprostřed existujícího, čímž se všechny pozdější páry vychýlí z fáze. EnumNumTree měla tentýž průchod po jednom kroku. Obě teď iterují páry s krokem dva, čtou klíč na X * 2 a hodnotu na X * 2 + 1 a přesná shoda klíče nahradí hodnotu a vystoupí přes Break. Spravedlnost berme: hodnoty page labels jsou slovníky, takže tenhle druhý bug se na /PageLabels samotných spouštěl zřídka, ale helper number tree, který čte špatný krok, je zkažený v momentě, kdy je kterákoli hodnota číslo, a opravilo se to v témže tahu
Čtení labelů zpět a jejich round trip
TPDFlib.GetPageLabel(Page) vrací label pro 1-based stránku a má dvě zálohy, které stojí za znalost. Bez jakékoli položky /PageLabels vrací desítkové číslo stránky, takže volající ho může použít bez podmínek. Se stromem přítomným, ale bez rozsahu pokrývajícího stránku vrací prázdný řetězec, což je přesně to, co se stane, když soubor vynechá povinnou položku indexu 0; referenční dokumentace říká, že aby se labely zobrazovaly správně, musí existovat rozsah začínající na stránce 1, a kód dělá tenhle požadavek viditelným. Letter styly následují specifikaci, ne sloupce tabulkového procesoru: po Z přijde AA, pak BB, písmeno se opakuje místo přenášení
var
  P: Integer;
  Data: WideString;
begin
  // Rychlá revize toho, co prohlížeč ukáže ve svém políčku stránek
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Hodnota volby 4 exportuje jen label rozsahy jako záznamy PageLabelBegin
  Data := Lib.ExportDocumentData(4);
  // Import je přehraje přes ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
Pro hromadné úpravy zapisuje ExportDocumentData s hodnotou volby 4 každý rozsah jako blok PageLabelBegin s řádky PageLabelNewIndex, PageLabelStart, PageLabelPrefix a PageLabelNumStyle a ImportDocumentData bere první label záznam, který uvidí, jako plnou náhradu: jednou zavolá ClearPageLabels a pak podstrkává každý záznam AddPageLabels. Textový round trip je díky tomu deterministický i když původní soubor používal strom /Kids, protože čištění sune celou catalog položku pryč a znovu postavený strom je od začátku jediný list
Co oprava pořád negarantuje?
Zploštění je jednosměrné a věří pořadí, které najde. EnumNumTree sesbírá páry v pořadí souboru a GetPageLabel aplikuje poslední rozsah, jehož klíč je menší nebo roven indexu stránky, takže cizí soubor s listy mimo pořadí, což §7.9.7 zakazuje, ale což běžně koluje, může pořád dávat špatné labely, dokud rozsahy nepostavíte znovu přes ClearPageLabels a čerstvá volání AddPageLabels. Labely jsou taky vázané na indexy stránek, ne na page objekty, takže jakákoli operace měnící počet nebo pořadí stránek nechá rozsahy tam, kde byly. In-place výměna, jako nahrazování stránek se zachováním čísel objektů, drží počet a tím i labely v souladu, kdežto merge, jako slučování prokládaných duplex skenů, produkuje novou sekvenci stránek, která si zaslouží čerstvě napsanou sadu rozsahů
Volání page labels, obsluha number tree a export a import dokumentových dat popsané tady všechny jsou součástí PDF Library for Delphi pro Delphi, C++Builder a Lazarus, s referenční položkou AddPageLabels, která dokumentuje hodnoty stylů a návratové kódy