CollateDocumentsEx v knihovně PDF Library for Delphi pro Delphi slučuje několik otevřených dokumentů do jednoho prokládaného dokumentu. Připojuje GroupSize stránek z každého zdroje na kolo, přijímá seznam rozsahů stránek pro každý zdroj a sestupný rozsah, jako je 3-1, chápe jako obrácení tohoto zdroje. Jedno volání promění přední stoh a obrácený zadní stoh v pořadí pro čtení
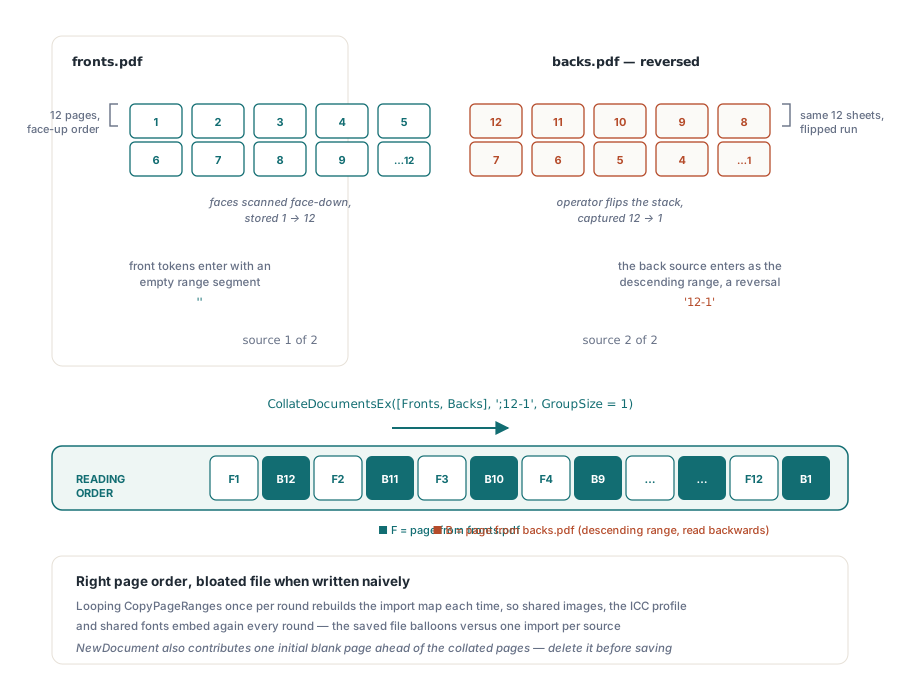
Scénář za tímto API je všední a nesmírně běžný. Skener s podavačem listů a jednostrannou cestou projede celý stoh lícem dolů, poté operátor stoh obrátí a projede jej znovu. Skončíte se dvěma PDF: přední strany v pořadí, zadní strany v obráceném pořadí. Výstup, který uživatel chce, je jeden soubor, stránka 1 přední, stránka 1 zadní, stránka 2 přední, a tak dále. Tento článek je o problému pořadí a pasti duplikace zdrojů, která leží pod ním. Pokud vás zajímá spíš surová propustnost konkatenace, viz rychlé sloučení PDF přes posun referencí na úrovni bajtů; pokud jsou vstupy příliš velké na to, aby se vešly do paměti, viz slučování a dělení gigabajtových PDF s přímým přístupem
Skener vyprodukuje dva stohy, jeden z nich pozpátku
Kompletace není slučování. Sloučení konkatenuje rozsahy stránek; kompletace je prokládá, a vzor prokládání je vlastnost fyzického zařízení, které vstup vyprodukovalo. Uděláte-li vzor špatně, soubor není mírně chybný, je nečitelný: každá druhá stránka patří k jinému listu. Téměř každý reálný případ popisují tři proměnné: kolik zdrojů je v rotaci, kolik stránek přichází z každého zdroje na kolo, a zda je potřeba některý zdroj číst pozpátku. CollateDocuments pokrývá první dvě obyčejným polem handlů dokumentů a celým číslem GroupSize. CollateDocumentsEx přidává třetí přijetím seznamu rozsahů stránek odděleného středníky, jeden segment na zdroj, kde prázdný segment znamená všechny stránky tohoto zdroje a sestupný rozsah jej obrátí. Obě funkce připojují na konec aktuálně vybraného dokumentu a vrací 1 při úspěchu, 0 při jakémkoli odmítnutí
Proč naivní kompletace znásobí velikost souboru?
Protože mapa importu, která mapuje čísla zdrojových objektů na čísla cílových objektů, se přestavuje při každém volání kopírování, a cokoli dosažitelné z více než jednoho kusu se importuje jednou za kus. Uvnitř PDF Library for Delphi TPDFDocument.CopyPagesFromDoc resetuje svůj NewIndObjList na začátku každého vyvolání. Tento seznam je jediná paměť, kterou kopírovač má o tom, co už přenesl. Zavolejte jej jednou s desetistránkovým rozsahem a font sdílený všemi deseti stránkami se vloží jednou. Zavolejte jej desetkrát, po jedné stránce, a tentýž font se vloží desetkrát. To má mnohem větší význam u skenů než u textových dokumentů, protože skenovaná stránka je jediný velký obrazový XObject a sdílené objekty jsou ty se skutečnou váhou: vložený profil ICC, sdílený řetěz /DecodeParms, razítko nebo vodoznak form XObject aplikovaný na každý list, font textové vrstvy OCR. Zjevný způsob, jak napsat kolovou kompletaci, je smyčka přes kola, a tato smyčka je přesně patologický případ
// Toto nedělejte. Každé volání CopyPageRanges přestavuje mapu importu,
// takže cokoli oba zdroje sdílejí interně, se importuje jednou za kolo
// místo jednou za zdroj.
var
  RoundIndex: Integer;
begin
  for RoundIndex := 1 to 12 do
  begin
    PDF.CopyPageRanges(Fronts, IntToStr(RoundIndex));
    PDF.CopyPageRanges(Backs, IntToStr(13 - RoundIndex));
  end;
end;
Dvanáct kol, dva zdroje, dvacet čtyři map importu. Nic vás nevaruje. Pořadí stránek je správné, každá stránka se vykreslí, a jediným příznakem je soubor několikrát větší než součet svých vstupů. U dávkové úlohy o 300 stránkách není násobitel zaokrouhlovací chybou, je to rozdíl mezi archivem, který se vejde do rozpočtu retence, a takovým, který se nevejde
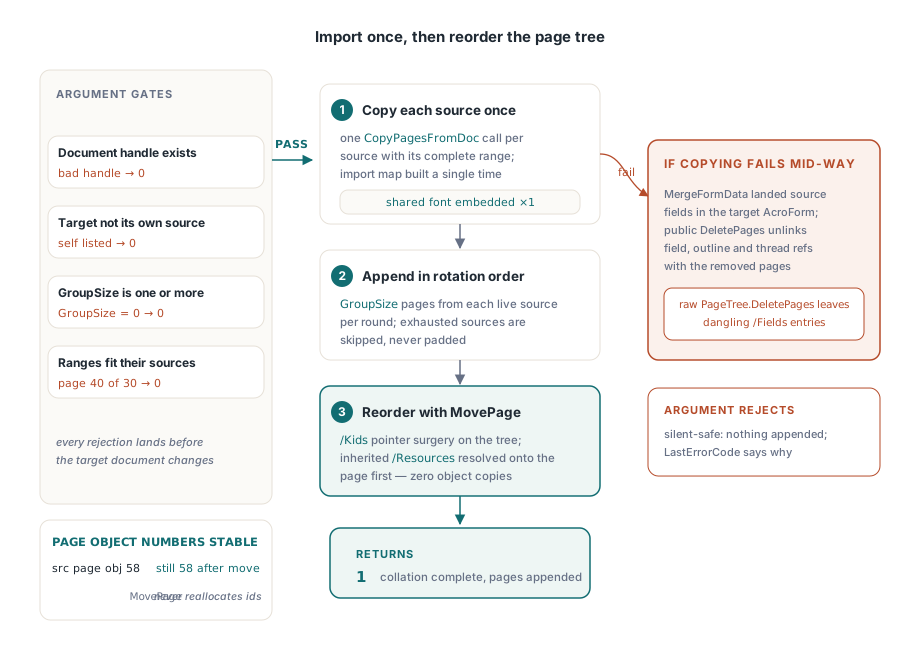
Importovat jednou, pak přeuspořádat strom stránek
Oprava spočívá v oddělení dvou zájmů, které naivní smyčka sloučila. Kopírování rozhoduje, které objekty v cíli existují; pořadí rozhoduje, kde stránky sedí ve stromu stránek. CollateDocumentsEx kopíruje každý zdroj přesně jednou, v jediném volání CopyPagesFromDoc s celým rozsahem tohoto zdroje, takže každý zdroj dostane jednu mapu importu a sdílené zdroje se zapíšou jednou. Teprve poté, co všechny zdroje přistanou, dojde k proložení, a to se děje výhradně přes TPDFPageTree.MovePage
Přesuny stránek jsou zdarma v tom smyslu, na kterém zde záleží. ISO 32000-1 §7.7.3 definuje strom stránek jako vyváženou strukturu slovníkových uzlů, jejichž pole /Kids nesou nepřímé odkazy, s /Count nesoucím celkový počet listů na každém uzlu. Přemístit stránku znamená odstranit jeden nepřímý odkaz z jednoho pole /Kids, vložit jej do jiného, upravit obě hodnoty /Count a přesměrovat /Parent stránky. Žádný content stream se nedotkne, žádný zdroj se neduplikuje, žádný objekt se nevytvoří. Objekt stránky si ponechá své číslo objektu, což je také důvod, proč čísla objektů zůstávají stabilní stejným způsobem jako v nahrazení stránek zachovávajícím čísla objektů. Existuje ještě jeden detail, který naivní přesun stránky udělá špatně a MovePage ne. ISO 32000-1 §7.7.3.4 dovoluje, aby /Resources, /MediaBox, /CropBox a /Rotate byly zděděny od předchůdce místo uvedeny na stránce. Stránka, která dědí své zdroje od uzlu A a je pak přesunuta pod uzel B, tiše zdědí něco jiného, nebo nic. MovePage proto vyhodnotí zděděnou hodnotu a zapíše ji do slovníku stránky ještě před přemístěním, takže stránka nese své vlastní atributy napříč přesunem
Co skutečně dělá průchod přeuspořádáním?
Provádí selection sort proti sémantice vlož-na-pozici. Požadované pořadí relativní vůči bloku se spočítá nejprve: projděte zdroje v rotaci, vezměte až GroupSize indexů z každého, přeskočte zdroj, který je vyčerpaný, opakujte, dokud není umístěna každá stránka. To vyprodukuje permutaci nad připojeným blokem. Aplikace je ta neohrabaná část, protože MovePage je vložení, ne prohození, takže každý přesun posune vše mezi starou a novou pozicí o jedna
Implementace udržuje pole Current modelující, kde každá připojená stránka aktuálně sedí, prohledává vpřed od pozice K stránku, která patří na K, vydá přesun, poté posune položky pole tak, aby zrcadlily, co přesun udělal se stromem. Je to O(n na druhou) v operacích s polem a nula v kopiích objektů, což je správný kompromis pro tuto zátěž: kompletace 500 stránek je čtvrt milionu prohození celých čísel a ani jeden bajt duplikovaných obrazových dat. Sestupné rozsahy a opakované stránky nepotřebují v tomto průchodu žádné speciální zacházení, protože PLParsePageRangeList se volá s vypnutým řazením a povolenými duplicitami, takže požadované pořadí přežije parsování nedotčené
Obrácené rozsahy a jednovolání duplex sloučení
S obrácením vyjádřeným jako rozsah se scénář dvouprůchodového plochého skeneru zhroutí do jediného volání. Přední strany chtějí přirozené pořadí a zadní strany chtějí 12-1, a prázdný první segment před středníkem říká, že první zdroj přispívá všemi svými stránkami
var
  PDF: TPDFlib;
  Target, Fronts, Backs: Integer;
begin
  PDF := TPDFlib.Create;
  try
    Target := PDF.NewDocument;
    if PDF.LoadFromFile('fronts.pdf', '') <> 1 then
      Exit;
    Fronts := PDF.SelectedDocument;
    if PDF.LoadFromFile('backs.pdf', '') <> 1 then
      Exit;
    Backs := PDF.SelectedDocument;
    PDF.SelectDocument(Target);
    // přední strany 1..12 v pořadí, zadní strany skenované obráceně: F1 B12 F2 B11 ...
    if PDF.CollateDocumentsEx([Fronts, Backs], ';12-1', 1) = 1 then
      PDF.SaveToFile('duplex.pdf');
  finally
    PDF.Free;
  end;
end;
Dvě chování v tomto úryvku stojí za otevřené vyjádření. Kompletované stránky se připojují k vybranému dokumentu, takže dokument vytvořený pomocí NewDocument přispívá svou počáteční prázdnou stránkou před nimi, a měli byste ji odstranit, pokud ji nechcete. A zdroje mohou být nevyrovnané: s GroupSize 2 nad třístránkovým a pětistránkovým zdrojem vyjdou kola A1 A2 B1 B2, pak A3 B3 B4, jakmile je A téměř vyčerpáno, pak B5 samotná, protože vyčerpaný zdroj se prostě přeskočí místo doplnění
Rollback, pole formulářů a co se nepřenese
Každý argument se validuje ještě předtím, než se cíl dotkne. Chybějící handle dokumentu, vybraný dokument uvedený jako vlastní zdroj, GroupSize pod jedna, počet segmentů, který neodpovídá počtu zdrojů, rozsah pojmenovávající stránku, kterou zdroj nemá: to vše vrací 0 s cílem nezměněným. Selhání během kopírování je obtížnější případ, a je zpracováváno přes veřejné DeletePages místo přes syrové PageTree.DeletePages. Důvod je konkrétní. Kopírování běží se zapnutým MergeFormData, takže pole formuláře zdroje už byla připojena do pole /AcroForm /Fields cíle v okamžiku, kdy pozdější zdroj selže. Odstranění stránek na úrovni stromu stránek by odstranilo stránky s widgety a ponechalo tyto odkazy na pole visící; veřejná cesta odpojí odkazy na pole, osnovu a vlákna článků spolu se stránkami
if PDF.CollateDocumentsEx([Fronts, Backs], ';12-1', 1) = 0 then
  // Nic nebylo připojeno a cíl je bajtově identický jako předtím.
  // 412 je chyba kopírování; 0 znamená, že argumenty byly odmítnuty
  // během validace, ještě než se dotklo jakékoli stránky.
  Log(Format('collate rejected, LastErrorCode=%d', [PDF.LastErrorCode]));
Buďte ke svým uživatelům upřímní ohledně hranic. Kompletace nese stránky, jejich anotace a jejich pole formuláře, a slučuje seznam polí AcroForm, pole pořadí výpočtu a slovník výchozích zdrojů. Nenese zdrojové záložky: strom osnovy skenovaného předního stohu je téměř vždy prázdný, takže v případě duplexu se nic neztratí, ale pokud kompletujete dva autorsky vytvořené dokumenty, jejich osnovy zůstanou pozadu a navigaci si musíte přestavět sami. Pojmenované cíle, které žily jen v katalogu zdroje, jsou ve stejné pozici. Naplánujte si to ještě předtím, než zákazníkovi slíbíte bezeztrátovou kompletaci
PDF Library for Delphi dodává funkce kompletace spolu se zbytkem svého povrchu pro sestavování stránek, takže pracovní postup skeneru, extrakce založená na rozsahu a cesty pro velké soubory sedí všechny za jednou komponentou v Delphi a C++Builder. Kompletní referenci API a zkušební build najdete na stránce produktu losLab Delphi PDF library