PDFlibPas, PDF knihovna losLab pro Delphi, prochází name trees a number trees PDF od v3.539.45 s explicitním stackem a množinou navštívených, takže cyklické /Kids, sdílení potomků a stromy tisíců úrovní hluboko už nevyčerpají call stack ani nezduplikují položky. Od v3.539.51 chybějící, deformovaná nebo přehozená dvojice /Limits nikdy neskrývě větev, která klíč drží. Named destinations, page labels, přílohy i JavaScript na úrovni dokumentu se čtou přes tyhle dvě kódové cesty, což z nich dělá část attack surface jakéhokoli PDF, které jste si nevyrobili sami
Spuštěč není zřídkakdy exotický. Fuzzer, nepřátelský upload nebo rozbitý inkrementální save zapíše položku /Kids ukazující zpátky na předka a rekurzivní walker umře stack overflow na souboru o dvou kilobajtech. Tišším selháním je vyhledání, které věří rozbitému array /Limits a hlásí „not found“ u cíle, který tam očividně je
Kde se v PDF objevují name trees a number trees?
Name trees a number trees se objevují všude tam, kde PDF mapuje velkou množinu klíčů na objekty, a PDFlibPas jich čte přes veřejná API nejméně čtyři. ISO 32000-1 §7.9.6 definuje name tree (řetězcové klíče, Table 36) a §7.9.7 number tree (celočíselné klíče, Table 37). Obě jsou spíš vyvážené stromy, jejichž kořen a prostřední uzly nesou /Kids, jejichž listy nesou setříděné páry klíč/hodnota v /Names nebo /Nums a jejichž nekořenové uzly nesou dvojelementový array /Limits s nejmenším a největším klíčem pod nimi
| Strom | Kde sídlí | Specifikace | Čtecí API PDFlibPas |
|---|---|---|---|
| Named destinations | /Dests ve jmenném slovníku | §12.3.2.3 | GetNamedDestination, pak GetDestPage / GetDestType |
| Page labels | /PageLabels v katalogu (number tree) | §12.4.2 | GetPageLabel |
| Přílohy | /EmbeddedFiles ve jmenném slovníku | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript na úrovni dokumentu | /JavaScript ve jmenném slovníku | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Dva detaily v té tabulce se dají snadno přehlédnout. Named destinations mají také starší formu z PDF 1.1, obyčejný slovník /Dests v katalogu s klíči jako name objekty, a GetNamedDestination ten slovník kontroluje první, než sestoupí do name tree z PDF 1.2. A GetDocJavaScript vůbec není čtečka name tree: vrací skripty připojené k triggerům dokumentu ve slovníku /AA katalogu (WS, DS, WP, DP, DC), zatímco pojmenované balíčky skriptů, které běží při otevření dokumentu, bydlí v name tree /JavaScript
Každý bajt těchhle struktur přichází ze souboru. Specifikace říká, co má zapisovač vyrábět; nedokáže zastavit čtečku od přijetí něčeho jiného — tutéž lekci nese otužování Pascal PDF parseru proti zlomyslným souborům, tady aplikované na tvar stromu místo velikostí bufferů
Proč cyklický array /Kids zabije rekurzivního procházeče stromu?
Cyklický array /Kids zabije rekurzivního walker proto, že si nic v rekurzi nevšimne, že uzel už viděla, takže potomek odkazující na vlastního předka změní konečný soubor v nekonečný sestup. Před v3.539.45 si NameTreeLookup, NumTreeLookup, EnumNumTree i interní TPDFNameTree.ProcessNode volaly samy sebe jednou na potomka. Jediný odkaz na sebe sám stačil proces ukončit a legitimní, ale velmi hluboký strom dokázal totéž bez jediného cyklu
Mírnější varianta kazí výsledky místo padání. Když dvě položky /Kids odkazují na tentýž list, naivní enumerace ho navštíví dvakrát a počet příloh nebo seznam balíčků skriptů hlásí položky, které neexistují
Oprava mění rekurzi za explicitní last-in, first-out stack na heapu a množinu navštívených klíčovanou identitou slovníku. Uzel se označí, když se vytahuje, ne když se vkládá, takže cyklická reference může na stacku chvíli sedět, ale zahodí se v okamžiku, kdy vyleze zpátky. Každý různý uzel rozbalí své potomky přesně jednou, což omezuje celkovou práci počtem různých slovníků plus celkovou délkou jejich array /Kids. Hloubka přestane hrát roli: řetěz 4 096 úrovní je jen 4 096 iterací smyčky a 4 096 položek v hash množině
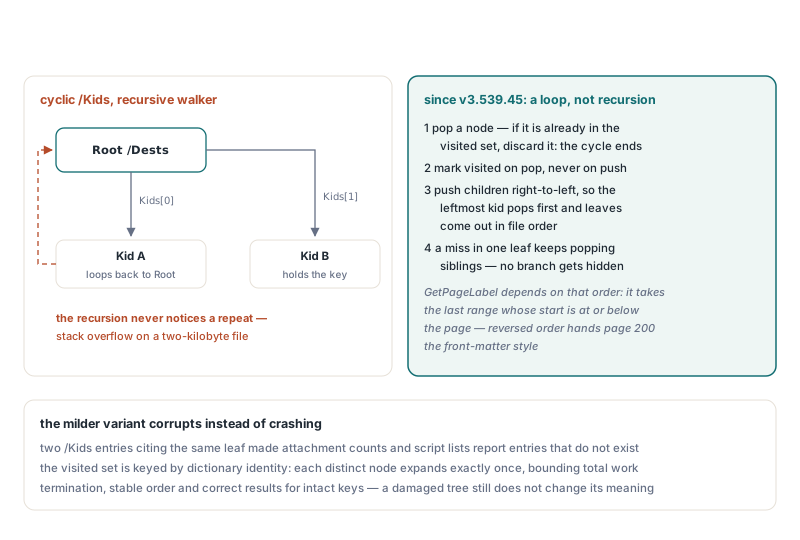
Pořadí ale pořád hraje roli a stack se musí naplňovat pozpátku, aby se drželo. Potomci se vkládají od posledního indexu k prvnímu, takže nejlevější potomek se vytahuje první a listy vycházejí ve stejném pořadí zleva doprava, v jakém je zapisovač napsal. GetPageLabel na tom závisí: projde každý vyenumerovaný rozsah a aplikuje poslední, jehož startovní index je na stránce nebo pod ní, takže obrácená enumerace by potichu dala stránce 200 styl úvodních stran. Kostra níže ukazuje pattern na abstraktním typu uzlu, nezávislém na jakémkoli PDF object modelu
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // prázdné na listu
    Keys: TArray<string>;      // klíče listu, setříděné korektním zapisovačem
    Values: TArray<Integer>;   // rovnoběžné s Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits je tip: větev může seříznout jen korektní, uspořádaná dvojice
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // cyklus nebo sdílený potomek: už viděno
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Vkládejte zprava doleva, aby se nejlevější potomek vytáhl první
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Mimo v tomhle listu není verdikt: dál tahajte sourozence
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Proč nemůže vyhledání zastavit na první sedící větvi?
Vyhledání nemůže zastavit na první větvi, jejíž rozsah sedí, protože rozsahy /Limits v reálném souboru se mohou překrývat nebo lhat a větev, která si klíč nárokuje, není nutně větev, která ho drží. Vyhledávání před v3.539.45 nastavila příznak Found na prvním potomkovi, jehož /Limits pokryl klíč, sestoupila do něj a na dalšího sourozence se už nikdy nepodívala. Pokud ten potomek vyšel prázdný, zastaralý nebo jako smyčka zpátky ke kořeni, odpovědí bylo nil, i když klíč držel hned další sourozenec
Přepsané FindTreeValue, které teď pohání jak NameTreeLookup, tak NumTreeLookup, vkládá každého potomka, jehož rozsah klíč nevylučuje, a vytahuje dál, dokud nenajde match nebo nevyprázdní stack. Mimo uvnitř jednoho listu je jen mimo uvnitř jednoho listu. V korektním stromu to nic nestojí navíc; v poškozeném to stojí pár dalších návštěv uzlů a vrátí správnou odpověď
Hledání v listu drží tutéž filozofii. ISO 32000-1 vyžaduje, aby klíče v array /Names byly setříděné podle bajtové hodnoty, takže list se hledá nejdřív binárním vyhledáváním. Když to selže, PDFlibPas sáhne po lineárním průchodu páry, protože list v špatném pořadí by jinak učinil přítomný klíč neviditelným. Třídění je rychlá cesta, ne filtr
Vyhledání se taky odmítá domnívat u jedné strukturální rozpory. Table 36 dovoluje uzlu nést buď /Kids, nebo /Names, nikdy obojí, a vyhledávací cesta bere uzel nesoucí obojí jako deformovaný a přeskočí ho místo výběru jedné interpretace. Enumerační cesty jako EnumNumTree jsou shovívavější a při obou následují /Kids
K čemu smí čtečka věřit /Limits?
Čtečka smí věřit /Limits jen k přeskočení práce, nikdy k rozhodnutí, že klíč chybí, a jen když je dvojice korektní. Table 36 říká, že prostřední uzly a listy mají nést /Limits jako dvojelementový array nejmenšího a největšího klíče, ale v praxi položka zmizí po ručních úpravách, drží čísla v name tree nebo přijde s přehozenými mezemi. PDFlibPas v3.539.45 a v3.539.51 vyřizují každý případ stejně: pokud se rozsah nedá číst jako uspořádaná dvojice správného typu, potomek zůstává prohledávatelný
- Chybějící
/Limits: stará kontrola rozsahu vrátila False a potomek se přeskočil úplně, takže zapisovač, který položku zapomněl, učinil celý svůj podstrom nedosažitelným. Od v3.539.45 se potomek prohledává - Špatný typ nebo špatná délka, třeba čísla v name tree nebo jednoelementový array: od v3.539.45 bráno přesně jako chybějící položka
- Přehozené meze jako
[(Z) (A)]nebo[9 0]: v3.539.45 je pořád používalo a žádný klíč nemůže splnitLo <= Key <= Hi, kdyžLo > Hi, takže větev byla vyloučená u každého vyhledání. Od v3.539.51 se rozsah používá k seřezávání jen tehdy, když jeho spodní mez nepřekračuje horní - Korektní, uspořádaná a správná: použije se k přeskočení větve, což je celý smysl té položky
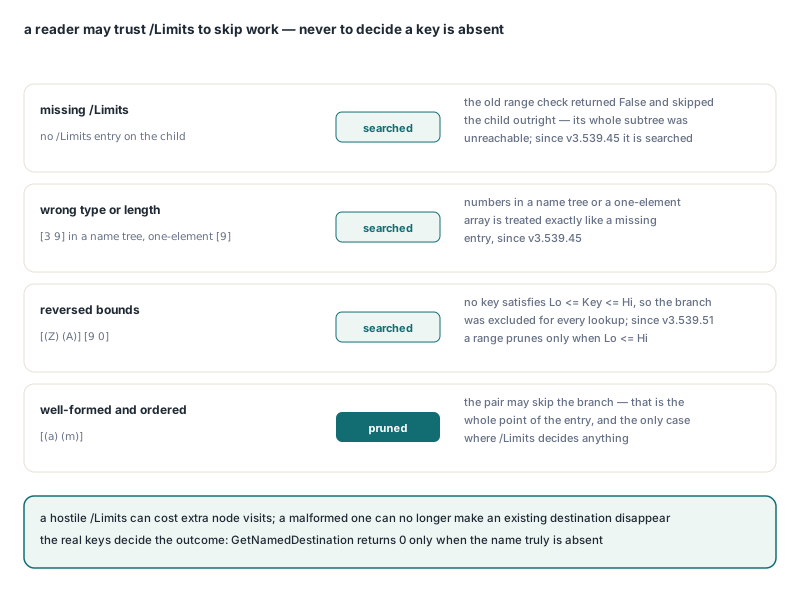
O výsledku v každém případě rozhodují skutečné klíče. Nepřátelské /Limits může donutit PDFlibPas navštívit víc uzlů, než je nutné, ale deformované už nedokáže nechat zmizet existující cíl. Z pohledu volajícího se nic nemění: GetNamedDestination vrací 0, když název opravdu chybí, a jinak destination ID, a funkce cíle to berou odtamtud
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Nejdřív Catalog /Dests (PDF 1.1), pak name tree /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Spuštěno proti ručně postavenému souboru, jehož kořen /Dests má jednoho potomka smyčkou zpátky ke kořeni pod rozsahem [(a) (z)] a druhého potomka držícího skutečnou položku pod přehozenými mezemi [(z) (a)], vyřeší tahle procedura cíl na stránku 2 s view typem 2 (Fit). Před v3.539.45 vrátila tentýž lookup 0, protože smyčkující potomek si klíč nárokoval první a hledání se ke svému sourozenci nikdy nedostalo; samotné v3.539.45 vracelo pořád 0, protože přehozený rozsah vyloučil skutečný list. Pokud si pak přečtete outline ukazující na tyhle cíle, o akční straně píše článek o čtení akcí záložek a anotací PDF v Delphi
Jak list s 32 769 názvy rozbil TPDFNameTree?
List s 32 769 páry název/hodnota rozbil TPDFNameTree, protože jeho interní FindIndex sbalil dvě čísla do jednoho 32bitového Integer: pozici listu v interním seznamu arrayů do horních 16 bitů a offset položky uvnitř array /Names toho listu do dolních 16 bitů. Každý pár zabírá dvě sloty array, takže 32 769. pár, pár s indexem 32 768, začíná na offsetu 65 536, což je $10000. Tahle hodnota přeteče do horní poloviny a dekodér si ji přečetl zpátky jako offset 0 v dalším listu
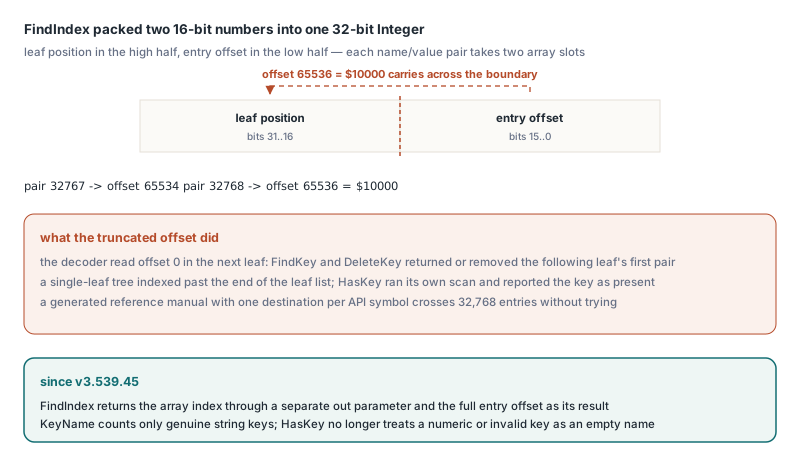
TPDFNameTree je třída za přílohami, globálními balíčky JavaScriptu a zápisy pojmenovaných cílů, což z toho dělá konkrétní důsledky. V jedno-listovém stromu žádný další list není, takže FindKey a DeleteKey indexovaly za konec seznamu listů; ve stromu s více listy vrátily nebo smazaly první pár následujícího listu místo toho požadovaného. Mezitím HasKey běžel vlastní sken a hlásil klíč jako přítomný, takže třída odporovala sama sobě. Generovaný referenční manuál s jedním named destination na API symbol překročí 32 768 položek, aniž by se snažil, a někteří zapisovače píší všechny do jediného plochého listu
Od v3.539.45 vrací FindIndex index array přes oddělený parametr out a plný offset položky jako svůj výsledek, takže žádná z hodnot se neusekne. Tamtéž vydání přituhuje na dva sousedy. KeyName počítá a vrací jen opravdové řetězcové klíče a vrací prázdný řetězec pro index 0 a níž, kde dřív přetypovala cokoli, co následovalo po neplatném klíči. HasKey už nebere numerický nebo jinak neplatný klíč jako prázdný název. Pro list jako [(Valid) 42 123 456] je HasKey('') teď False a KeyName(2) vrací prázdný řetězec
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // Number tree /PageLabels; soubory bez něj vracejí obyčejná čísla stránek
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // Name tree /EmbeddedFiles; indexy od 1, neřetězcové klíče se přeskočí
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // název, MIME typ
    // Name tree /JavaScript: vypsat názvy balíčků, nic nespouštět
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Na témže ručně postaveném souboru, jehož kořen /PageLabels uvádí jeden list dvakrát a odkazuje sám na sebe, vytiskne tenhle audit i a A-1 pro dvě stránky, každý rozsah jednou, a jediný balíček skriptů ze stromu /JavaScript, který taky ukazuje zpátky na vlastní kořen. Zápisová strana page labels má s kořeny /Kids vlastní historii, pokrytou v opravě PDF page labels uložených v number trees /Kids; AddPageLabels takový kořen před vložením zploští a spoléhá na tutéž enumeraci EnumNumTree popsanou tady
Co tohle otužování pořád negarantuje?
Otužování garantuje ukončení, stabilní pořadí a správné výsledky pro stromy, jejichž skutečné klíče jsou v pořádku; nedokáže z poškozeného stromu udělat to, co jeho autor zamýšlel. Pár mezí stojí za to znát, než na tom postavíte
- Množina navštívených pracuje na identitě objektů. Dva různé slovníky se stejným obsahem jsou dva uzly, takže zapisovač, který list zkopíruje místo odkazu, stále vytvoří duplicitní položky
- Korektní, uspořádaný, ale špatný
/Limitspořád seřezává. Čtečka, která používá rozsahy jako optimalizaci, nemůže být zároveň imunní vůči rozsahu, který věrohodně lže; jediná alternativa je ignorovat/Limitsúplně a projít každý list - Enumerace zachovává pořadí souboru, ale netřídí.
GetPageLabelaplikuje poslední vyenumerovaný rozsah na stránce nebo pod ní, takže zapisovač, který píše rozsahy v špatném pořadí, dostává sémantiku pořadí souboru - Paměť roste s počtem různých uzlů a položek. Průchod přidává seznam a hash množinu, nic víc, ale 100MB name tree je po naparsování pořád 100MB name tree
- Duplicitní klíče uvnitř jednoho listu se nehlásí. Binární vyhledávání vrátí první pár, na který narazí; lineární záloha drží poslední match, který projde
Rychlá reference: čtení PDF stromů z nedůvěryhodných souborů
- Přejděte na v3.539.45 a novější pro průchod name trees a number trees bezpečný vůči cyklům i stacku a na v3.539.51 a novější, aby přehozené
/Limitsuž neskrývaly klíče - Vrácenou 0 od
GetNamedDestinationberte jako „nenachází se“ a 0 odGetDestPagejako „přítomný, ale nepoužitelný“ - Pro name tree
/JavaScriptpoužívejteGlobalJavaScriptCountaGlobalJavaScriptPackageName;GetDocJavaScriptčte místo toho triggery/AAkatalogu - Indexujte přílohy a balíčky skriptů od 1 do počtu, který knihovna hlásí; neplatné klíče se nepočítají
- Ve vlastním kódu stromů označujte uzly jako navštívené při vytahování, vkládejte potomky pozpátku a nechte
/Limitsseřezávat jen tehdy, když je správně typovaná, uspořádaná dvojice
Pre-flight nástroje, archivátoři a prohlížeče čtou tyhle stromy, ještě než se vyrenderuje jakákoli stránka, takže musí přežít cokoli, co dorazí do upload fronty. Čtečky stromů popsané výš lodí se s PDFlibPas, PDF Library for Delphi, které se sestavuje jak v Delphi, tak ve Free Pascalu