HotXLS, нативната Excel библиотека за Delphi и C++Builder, парсва XLSX работните листове върху няколко нишки чрез зареждане в три фази: XML на листа се декомпресира серийно, парсва се паралелно, а малките части се четат серийно след това. Първото издание на тази функция спечели едва 12–25%, защото ключалката на подразбиращия се мениджър на паметта в Delphi сериализираше работните нишки. Свалянето на заделянията в хийпа от около 20 на 9.1 на клетка вдигна паралелното ускорение до ×1.90 при осем нишки. Тази статия минава през измерванията, погрешните завои и двете поправки, които наистина проработиха
Как HotXLS парсва XLSX работни листове паралелно?
HotXLS разделя Open на три фази и само средната работи върху работни нишки. Причината е zip контейнерът: zip архивът е един споделен входен поток с една inflate машина на състоянията, а тази машина не може да бъде четена от две нишки едновременно. Да я обвиете в ключалка би било безсмислено, защото inflate е серийно по своята същност за всеки запис, така че ключалката просто би възпроизвела серийното изпълнение с допълнителни разходи. Затова фаза A декомпресира XML на всеки работен лист в собствен TMemoryStream, докато все още е еднонишкова; във файла ни за сравнителен тест това отне около 4 ms за осем части на листове, така че тя изобщо не е тясното място. Фаза B изпълнява ParseWorksheetXml за всеки лист върху пул от работни нишки и точно там живее почти цялото време за зареждане. Фаза C се връща серийно към zip за малките части: коментари, чертежи, диаграми и таблици
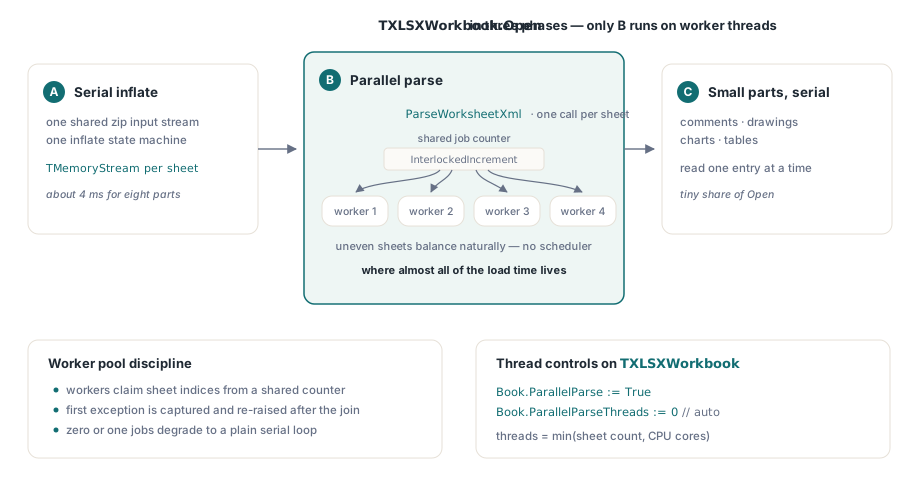
Самият пул от работни нишки е нарочно опростен. Нишките теглят индекси на задачи от споделен брояч с InterlockedIncrement, така че листове с неравен размер се балансират естествено без никакъв планировчик. Броят нишки е min(sheet count, CPU cores), първото изключение в работна нишка се улавя с AcquireExceptionObject и се повдига отново в главната нишка след присъединяването, а диспечерът се сваля до обикновен сериен цикъл, когато задачите са нула или една. Две свойства на TXLSXWorkbook управляват функцията: ParallelParse отваря пътя към пула, а ParallelParseThreads ограничава броя нишки, като 0 означава автоматично. Работните книги с много листове са формата, която печели, включително онези, които произвеждате, като дублирате шаблонен работен лист десетки пъти
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // включване на паралелния пул от нишки
    Book.ParallelParseThreads := 0;  // 0 = автоматично: min(листове, ядра)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('open failed');
    // ... четете клетките както обикновено; работната книга е напълно материализирана ...
  finally
    Book.Free;
  end;
end;
Защо добавянето на нишки прави XLSX парсването по-бавно в Delphi?
Защото подразбиращият се мениджър на паметта в Delphi пази своя хийп с глобална ключалка, а парсването на работен лист е гъсто на заделяния: клетки, Variant стойности и WideString низове по милиони. Всяка работна нишка, която докосне хийпа, се нарежда на опашка пред тази ключалка, така че нишки, които изглеждат независими в изходния код, на практика се изпълняват почти една по една. Първият ни сравнителен тест направи това болезнено конкретно. Върху работна книга с 8 листа по 5000 реда и 4 колони на лист, измерена на i5-11600K (6 ядра, 12 нишки) под Win64, паралелният Open се подобри едва с 12–25% срещу планова оценка от поне 40%. Обхождането на броя нишки през 2, 3, 4, 6 и 8 даде плоска крива, а в по-късни измервания с инструментация конфигурацията с 2 нишки беше всъщност 26% по-бавна от серийната — класическият подпис на две нишки, които си подмятат оспорвана ключалка
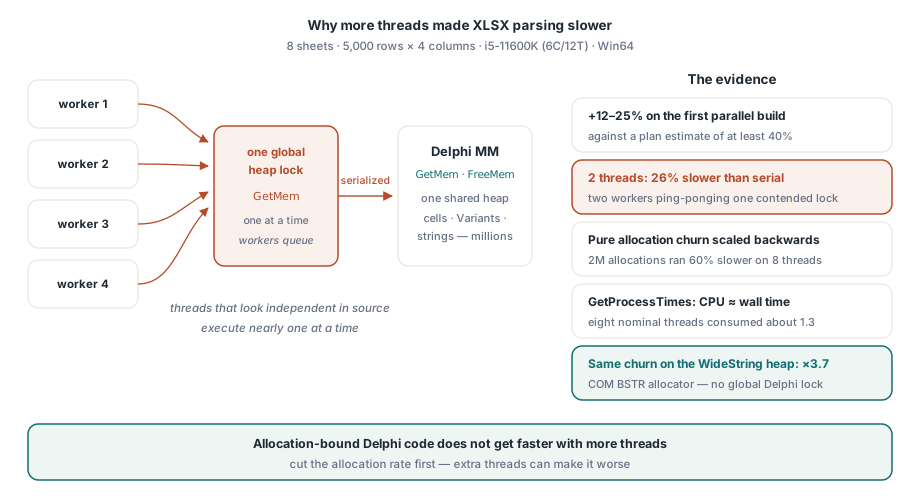
Три измервания приковаха диагнозата и всяко от тях обърна предишната интуиция. Първо, мъничък файл (8 листа по 1 ред) се отвори за 1.2 ms, което доказа, че парсването е практически 100% от Open и няма скрит фиксиран разход, върху който да хвърлим вината. Второ, микротест на чисто заделяне показа, че мениджърът на паметта в Delphi се мащабира наобратно: същият общ обем от 2 милиона заделяния на обекти и AnsiString низове се изпълни с 60% по-бавно върху 8 нишки, отколкото върху една, докато същият товар срещу хийпа на WideString, който е COM BSTR разпределителят, а не Delphi MM, се мащабира до ×3.7. Това, че HotXLS използва WideString навсякъде, се оказа историческа случайност, работеща в наша полза. Трето, GetProcessTimes показа, че по време на паралелен Open процесорното време горе-долу се изравнява с реалното: осем номинални нишки изяждаха процесорно време колкото около 1.3 нишки. Работните нишки не се въртяха на празни обороти; те спяха в пътя на съперничество на мениджъра на паметта, блокирани, а не заети
Практическата поука се обобщава далеч отвъд електронните таблици. Ако едно Delphi натоварване заделя много, вдигането на броя нишки не прави нищо, докато честотата на заделянията не спадне, и лесно може да влоши нещата. Преди тази поправка казвахме на потребителите, които настройваха ParallelParseThreads, честната истина: при файлове, ограничени от заделянията, повече нишки не купуваха почти нищо
Откъде идват 20 заделяния в хийпа на клетка?
Броящ обвиващ слой, инсталиран със SetMemoryManager, отговори на този въпрос точно: около 20 заделяния през Delphi-MM на клетка, като 2.87 милиона от тях са с размер 32 байта или по-малко. Виновникът изобщо не бяха обектите на клетките. TXMLScaner.GetTokenValue материализираше нов AnsiString при всяко извикване, а той се вика приблизително 15–20 пъти на клетка: по веднъж за имена на елементи, имена на атрибути, стойности на атрибути и текстово съдържание. Отгоре на това маршрутът UTF8ToWideString от RTL произвеждаше временен междинен UnicodeString при всяко преобразуване. Обектите на клетките дадоха едва 160 хиляди заделяния, около 8% от общото, което уби първоначалния ни план на място: бяхме възнамерявали да построим пул от обекти за клетки, а числата казваха, че той никога няма да се изплати
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // дребните заделяния, които ни интересуват
  Result := OldMM.GetMem(Size);
end;

// инсталирайте преди Open, възстановете след това
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
Тази десетминутна диагностика си струва да бъде заимствана за всяко изследване на производителността в Delphi. Броенето на заделянията по размерни кофи почти нищо не струва за построяване и ви казва откъде наистина идва натискът върху мениджъра на паметта, който в нашия случай беше два навика на ниво RTL вътре в XML скенера, а не нещо в обектния модел. Профайлърите продължаваха да сочат парсера като цяло; обвиващият слой посочи два конкретни реда
Поправката: интерниране на токени и UTF-8 декодер без междинни стойности
Две прицелени промени в четеца на XML премахнаха повече от половината заделяния на клетка, без да пипат структурата на парсера. Първата е интерниране на имената на елементи. XML на работния лист повтаря безкрайно мъничък речник: row, c, v, r, t, s и шепа имена на атрибути. InternTokenName държи кеш от 64 слота с вече видени имена и сравнява буфера на скенера с кеширан запис чрез TokenEqualsAnsi — пряко сравнение по байтове, което не заделя нищо. При попадение връща кешираната AnsiString стойност и тук изборът на тип има значение: AnsiString се брои по референции, така че връщането на кеширан екземпляр струва едно увеличение на брояча и нулев трафик към хийпа. WideString няма брояч на референции и всяко присвояване минава през SysAllocString, така че интернирането на WideString низове не би спестило нищо. Интернирането си струва само при типа низ с броене на референции
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // само refcount++, без заделяне
  else
  begin
    Result := GetTokenValue;        // материализиране веднъж, после кеширане
    FInternNames[Slot] := Result;
  end;
end;
Втората промяна атакува текста в клетките. Старият път изграждаше AnsiString токен, подаваше го на UTF8ToWideString, който изграждаше междинен UnicodeString, а той накрая се преобразуваше в WideString стойността, която клетката съхранява: две заделяния през Delphi-MM на текстов токен преди истинското. Заместителят, XmlUtf8ToWide(TokenPtr, TokenLen), е чист Pascal UTF-8 декодер на две преминавания, който чете направо от буфера за сканиране: първото преминаване измерва дължината в UTF-16, второто декодира в WideString, заделен веднъж. Нетна цена на текстов токен: едно COM заделяне, нула заделяния през Delphi-MM. Една семантична бележка за предпазливите: при неправилни UTF-8 последователности новият декодер пропуска байтовете наготово, вместо да ги замества със заместващи знаци, както прави RTL, което засяга само как деградират повредените файлове; при валиден вход изходът е байт по байт идентичен. XML знаковите референции никога не стигат до декодера, защото скенерът вече ги е превърнал в UTF-8 в буфера за токени
Какво спечелихме и къде паралелното парсване пак няма да помогне
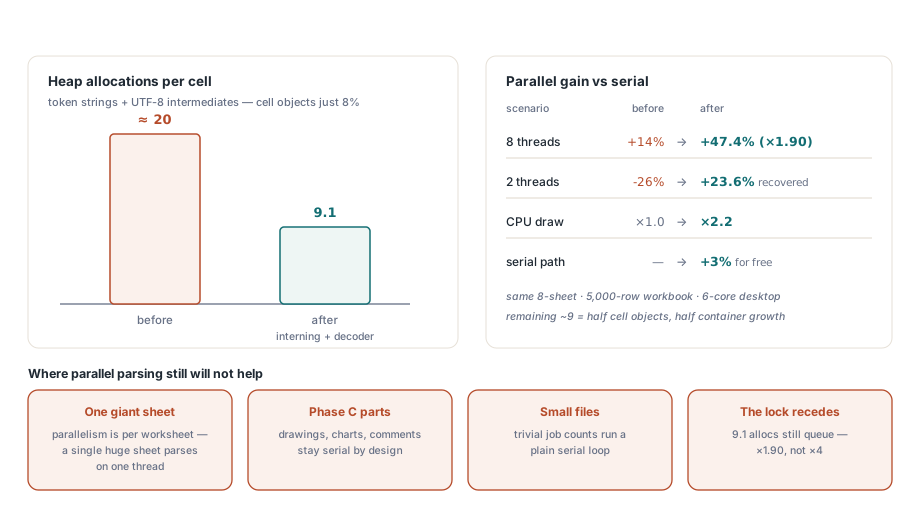
Двете поправки свалиха заделянията на клетка от около 20 на 9.1 и паралелните числа се задвижиха така, както теорията предричаше. На същия сравнителен тест с 8 листа по 5000 реда и на същата машина 6C12T подобрението при 8 нишки скочи от 14% на 47.4% — ускорение от ×1.90 спрямо серийното. Случаят с 2 нишки се обърна от 26% по-бавно на 23.6% по-бързо, а измереното използване на процесора се вдигна от ×1.0 на ×2.2. Серийният път стана около 3% по-бърз като бонус, защото по-малкото заделяния помагат и на една нишка. Останалите ~9 заделяния на клетка са грубо наполовина обекти на клетки и наполовина амортизиран растеж на контейнери; измерихме ги, преценихме, че възвръщаемостта намалява, и спряхме, като обвиващият слой на MM остава готов да вземе нови проби по място на извикване, ако бъдещо натоварване оправдае още един кръг
Границите си струва да бъдат изказани също толкова открито, колкото и печалбите. HotXLS паралелизира на ниво работен лист, така че работна книга, която е един огромен лист, се парсва върху една нишка, каквото и да казва ParallelParseThreads; за тази форма поточният директен четец е по-добрият инструмент, защото изобщо избягва материализирането на работната книга. Файловете, чието време отива в частите от фаза C — чертежи, диаграми и коментари — печелят по-малко, защото тази фаза остава серийна по замисъл. Малките файлове изобщо не си струва да се разпределят по нишки, затова диспечерът тихо минава серийно при тривиален брой задачи. А таванът на мениджъра на паметта не е изчезнал, само се е отдръпнал: при 9.1 заделяния на клетка глобалната ключалка още облага работните нишки, което е причината осем нишки да дават ×1.90, а не ×4. За по-широкия инструментариум за съкращаване на времената за зареждане и запис, включително стилове, пулове и групови обратни извиквания по редове, вижте нашето ръководство за производителност при големи работни книги в Delphi
Паралелното XLSX парсване, свойствата ParallelParse и ParallelParseThreads и описаният тук пестелив откъм заделяния четец на XML се доставят като стандартни части от HotXLS Delphi Excel компонента, който чете и записва XLS, XLSX и ODS нативно от Delphi и C++Builder без никаква Excel автоматизация