Когато експорт на 300 000 реда надхвърли лимита си на памет, обикновено се обвинява броят на редовете. Броят на редовете обикновено е невинен. Скъпите части на голяма работна книга са тези, които се създават като страничен ефект: пул от стилове, който нараства с по един запис на клетка, защото форматирането е добавено вътре в цикъла, XML на работния лист, сглобен като един гигантски низ по време на запис, и милион идентични формули, записани една по една. HotXLS, оригиналната библиотека на losLab за Delphi за XLS и XLSX файлове, ви дава конкретен лост за всеки от тези разходи. Никой от тях не е активиран по подразбиране, тъй като всеки променя определен баланс, така че познаването на това кой лост съответства на кой симптом е същинското умение за оптимизиране на производителността
Къде една голяма работна книга изразходва памет
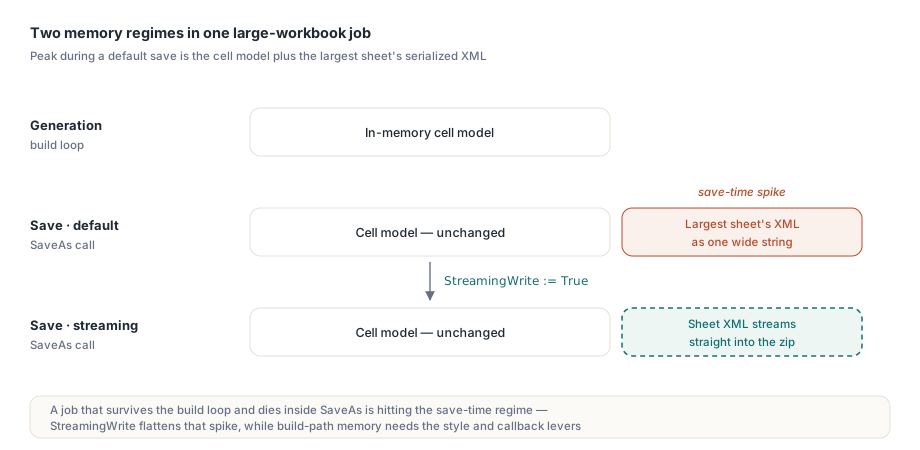
Има два отделни режима на паметта, върху които да разсъждаваме. По време на генериране, моделът на клетките в паметта нараства с всяка клетка, която докоснете: стойности, формати и формули стават обекти или записи в пулове. По време на запис, пътят по подразбиране за XLSX допълнително рендира XML на всеки работен лист в широк низ (wide string), преди да го компресира в zip контейнера, така че пиковото потребление е моделът плюс сериализираната форма на най-големия лист. Задача, която оцелява в цикъла на изграждане и след това умира вътре в SaveAs, попада във втория режим, а не в първия, и решението за единия не помага за другия
Размерът на файла следва сходно правило: клетките са само един от участниците, наред със стиловете, споделените низове, формулите, изображенията и коментарите. Проверка с ForEachCell и броя на колекциите за всеки лист ви казва кой ресурс действително доминира в проблемния файл, преди да оптимизирате грешния. Една тънкост при измерването: Sheet.Cells.Count от страна на XLSX отчита броя на инстанцираните клетки в разреденото хранилище, а не областта на използвания диапазон. Лист, чиито данни заемат правоъгълник 1000 на 50 с наполовина празни клетки, отчита приблизително 25 000, а не 50 000. Тази разлика е от значение, когато сравнявате "огромен" файл на клиент с вашите тестови шаблони, тъй като областта на използвания диапазон и реалният брой клетки могат да се различават с порядък при разредени финансови оформления
StreamingWrite коригира пътя за запис, а не пътя за изграждане
Задаването на TXLSXWorkbook.StreamingWrite := True превключва SaveAs към стрийминг сериализатор, който записва XML на работния лист директно в zip потока, елиминирайки междинния низ за всеки лист. Той е False по подразбиране за съвместимост на поведението, а активирането му е промяна на един ред:
Book := TXLSXWorkbook.Create;
try
  Sheet := Book.Sheets.Add('Bulk');
  for R := 1 to 100000 do
  begin
    Sheet.Cells[R, 1].Value := R;
    Sheet.Cells[R, 2].Value := 'Row ' + IntToStr(R);
    Sheet.Cells[R, 3].Value := R * 1.5;
  end;
  Book.StreamingWrite := True;   // XML на листа се стриймва в контейнера на zip
  Book.SaveAs('bulk.xlsx');
finally
  Book.Free;
end;
Бъдете точни относно това какво носи това: моделът на клетките, изграден от цикъла, заема точно толкова памет, колкото и преди. StreamingWrite изравнява пика по време на запис, което е разликата между пакетно задание, което завършва успешно, и такова, което се проваля на 95-ия процент. Ако самият цикъл за изграждане изчерпи паметта, лостовете, от които се нуждаете, са следващите два
Пулове от стилове: добавете веднъж, използвайте повторно индекса
Форматирането на XLSX в HotXLS е базирано на пулове: Book.Fonts.Add(...), Fills.AddSolid(...) и Borders.Add(...) връщат 0-базиран индекс на пул, към който клетките реферират. Извикването на Fonts.Add с идентични параметри вътре в цикъл се дедуплицира, така че губи време, а не пространство. Alignments.Add се държи различно: той връща нов обект при всяко извикване, така че създаването на подравняване за всяка клетка кара пула да расте линейно с броя на редовете. Един навик покрива и двата случая. Разрешете всеки индекс на пул веднъж, извън цикъла, и присвоете индексите вътре в него
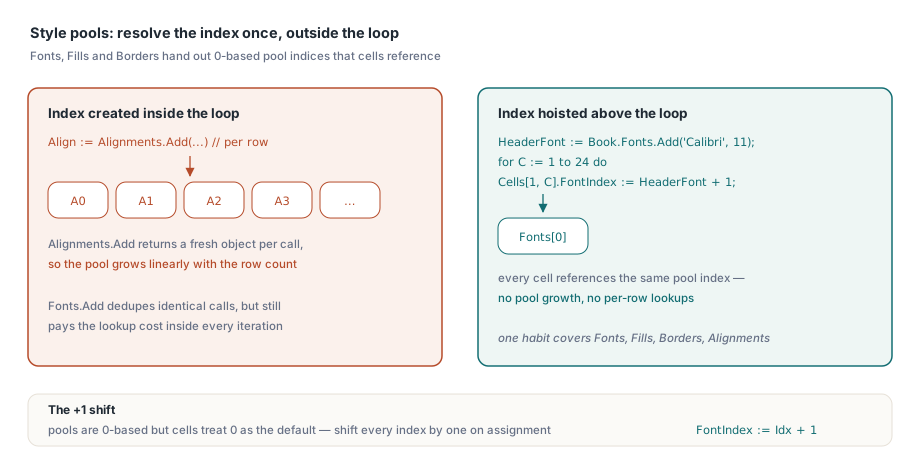
// извадете търсенията в пуловете от горещия цикъл
HeaderFont := Book.Fonts.Add('Calibri', 11, True, False);   // 0-базиран индекс на пул
for C := 1 to 24 do
  Sheet.Cells[1, C].FontIndex := HeaderFont + 1;            // клетките съхраняват 1-базирано; 0 = по подразбиране
Увеличението с + 1 не е правописна грешка и забравянето му е класическият бъг тук: пуловете раздават 0-базирани индекси, докато свойствата от страна на клетките третират 0 като "по подразбиране", така че всеки индекс на пул трябва да бъде изместен с едно при присвояване. Ако сгрешите поради пропуск, вашите заглавия тихо ще се рендират с шрифта по подразбиране на работната книга - дефект, който никой не забелязва до прегледа на брандирането
Заменете трафика на Variant за всяка клетка с обратни извиквания за редове
Всяко Sheet.Cells[R, C].Value := X включва търсене или създаване на клетка плюс присвояване на Variant. При няколкостотин хиляди клетки, това допълнително натоварване при всеки достъп става измеримо в профилите за производителност. HotXLS предоставя групови callback API на двете фасади (ForEachCell и ForEachRow за четене, WriteCells и WriteRows за запис), които преместват итерацията вътре в двигателя и подават на вашия код цели редове наведнъж:
procedure TLedgerExport.FillRow(Sender: TObject;
  SheetIndex, Row, FirstCol, LastCol: Integer;
  var Values: Variant; var Skip: Boolean; var Cancel: Boolean);
begin
  if Row > FCount then
  begin
    Cancel := True;     // спрете целия запис
    Exit;
  end;
  Values := VarArrayOf([FRows[Row - 1].Account,
                        FRows[Row - 1].PostedOn,
                        FRows[Row - 1].Amount]);
end;

// едно извикване на двигателя вместо стотици хиляди обръщения към свойства
Sheet.WriteRows(1, 1, FCount, 3, FillRow);
Флагът Skip на обратната функция оставя ред недокоснат, без да прекъсва процеса, а Cancel прекратява операцията по-рано, което е полезно, когато източникът е четец, чиято дължина откривате в движение. Комбинирайте WriteRows за изграждането със StreamingWrite за записа и в пътя на генериране няма да остане критична точка (hot spot) на ниво клетка
Лостове от страната на четенето във фасадата XLS
Големите остарели .xls файлове имат свой собствен набор от инструменти. _DisableGraphics := True преди Open пропуска изцяло парсването на графичния слой, което ускорява зареждането на работни книги, съдържащи натрупани през годините фигури и вградени картини. Ограничението е строго: тогава графичният слой липсва в модела, така че записването на такава работна книга записва файл без неговите рисунки. Резервирайте този флаг за задачи за анализ, които изискват само четене. SetTempDir пренасочва временните файлове на BIFF писателя, което е важно на сървъри, където местоположението за временни файлове по подразбиране има квота или се намира на бавно дисково пространство. UseSharedFormulas групира повтарящи се формули в споделени записи за формули, което намалява размера на файловете, при които колона с формула се повтаря надолу в шестдесет хиляди реда
Циклите за четене на XLS данни имат капан с индексирането, който си струва да бъде отбелязан, тъй като удвоява работата, когато се обработва дефанзивно, и поврежда резултатите, ако бъде пропуснат: UsedRange отчита границите си FirstRow, LastRow, FirstCol и LastCol като 0-базирани, докато Cells.Item[Row, Col] е 1-базиран. Сканиране, което обхожда използвания диапазон, трябва да добави едно към всяка координата при достъп до клетката, както в Cells.Item[Row + 1, Col + 1], в противен случай чете мрежа, изместена диагонално с една клетка, като тихо изпуска последния ред и колона и включва фантомен първи такъв. Обратното извикване ForEachCell напълно избягва това несъответствие, което е още една причина да го предпочитате при сканиране на целия лист
Проучване на файлове преди зареждането им
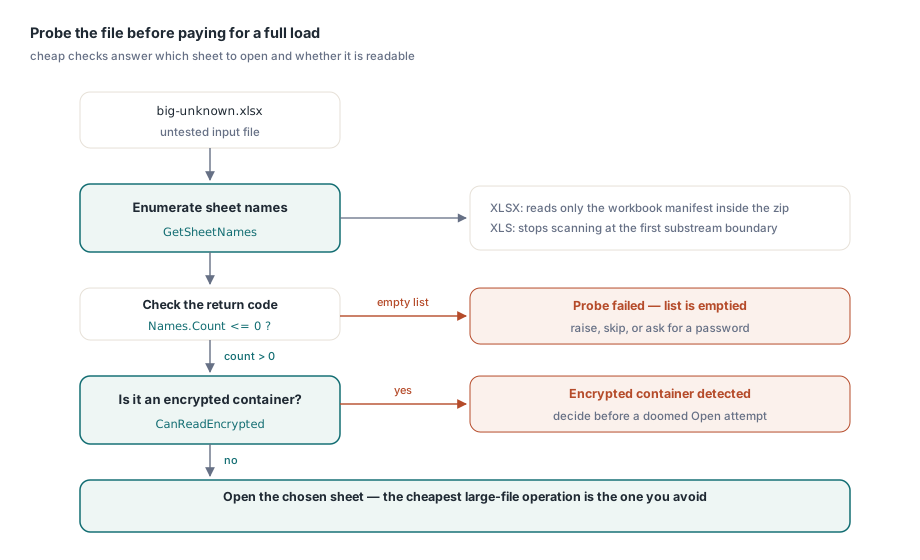
Най-евтината операция с голяма работна книга е тази, която избягвате. GetSheetNames на двете фасади списва работните листове на файла без зареждане на данните от клетките. Реализацията на XLSX чете само манифеста на работната книга вътре в zip архива и изрично оставя инстанцията на работната книга празна, а XLS фасадата спира сканирането при първата граница на подпоток. Това го прави правилната предварителна проверка за това "кой лист трябва да бъде цел на тази импортна задача", а CanReadEncrypted отговаря дали контейнерът е криптиран преди неуспешен опит за Open
Names := TStringList.Create;
Book := TXLSXWorkbook.Create;
try
  if Book.GetSheetNames('big-unknown.xlsx', Names) <= 0 then
    raise Exception.Create('cannot enumerate sheets');   // неуспехът изчиства списъка
  // изберете целевия лист, след което решете дали пълното Open си заслужава
finally
  Book.Free;
  Names.Free;
end;
Обърнете внимание на конвенцията за кодовете за връщане: тези функции за проучване сигнализират за неуспех със стойности, равни или по-малки от нула, и изпразват изходния списък, така че тествайте за <= 0, вместо да сравнявате с една конкретна стойност за успех
Определяне на подхода според задачата
За автоматизирани процеси, които генерират много големи файлове последователно, още два навика допълват картината. Обектите на работната книга не са нишково безопасни (thread-safe) за споделяне, но нищо не пречи да има по една независима работна книга на работен поток (worker thread), което паралелизира пакетното преобразуване чисто. И когато изходът отива към HTTP вместо на диск, претоварванията за запис в TStream се комбинират със StreamingWrite, така че големият отговор никога не се материализира като временен файл. Прилага се една оперативна бележка под линия: записът в поток пише от текущата позиция без превъртане назад, така че задайте Position := 0 преди да предадете потока на рамката за отговори. Статията за поточно записване и пакетни задачи развива този модел от страна на сървъра, а статията за експортиране на бази данни показва къде се вписват тези механизми в отчет, базиран на набор от данни
И накрая, поддържайте по един най-лош тестов шаблон за всяка фамилия отчети и измервайте времето му в CI. Регресиите в производителността при генериране на документи рядко се обявяват сами. Стил, добавен вътре в цикъл, или проучване, заменено с пълно Open, не променя нищо функционално, а пакетното задание просто отнема четиридесет минути повече. Времево измерван тест върху представителен шаблон с половин милион клетки превръща това отклонение в червен билд, вместо в инцидент при поддръжката
Оценъчни билдове, демо проекти с пример за масово генериране и пълният справочник за API са налични на страницата за компонента HotXLS