在剛產生的 PDF 裡搜尋 "two-x",結果可以是零筆命中,而頁面上明明看得到這五個字元。把抽出來的字串以碼位傾印,原因就在眼前:連字符回傳成 U+00AD SOFT HYPHEN,它後面的空格回傳成 U+00A0 NO-BREAK SPACE。兩者在螢幕上看起來一模一樣。差別藏在 ToUnicode CMap——閱讀器把字元碼轉回 Unicode 時查的那張表——而它來自同一個字型字形被兩個碼位共用
純字串工具會把不一致放大。CSV 匯出的切分不一樣,diff 工具標出兩行在每個檢視器裡讀起來都相同的內容,拼字檢查把帶軟性連字號的 "two-x" 當成生詞。Unicode 正規化只能救一半:NFKC 會把 U+00A0 摺疊成普通空格,因為 NBSP 帶相容分解;U+00AD 卻完全沒有分解,所以軟性連字號在任何正規化形式下都活得好好的
抽取出來的空格為什麼會變成 U+00A0?
當 ToUnicode CMap 以字形為鍵、而同一個字形可以從兩個碼位抵達時,抽出來的空格就變成 U+00A0。在 Arial 裡,字形 3 同時服務 U+0020 與 U+00A0,連字符字形同時服務 U+002D 與 U+00AD。從字形那一側建出來的 CMap 對 CID 0003 總得說點什麼,而 FPDFText_LoadFont 裡 PDFium 的產生器最後說了兩件事:一條把 CID 0003 映射到 U+0020 的 bfchar 項目,和一條把同一個 CID 映射到 U+00A0 的陣列形式 bfrange
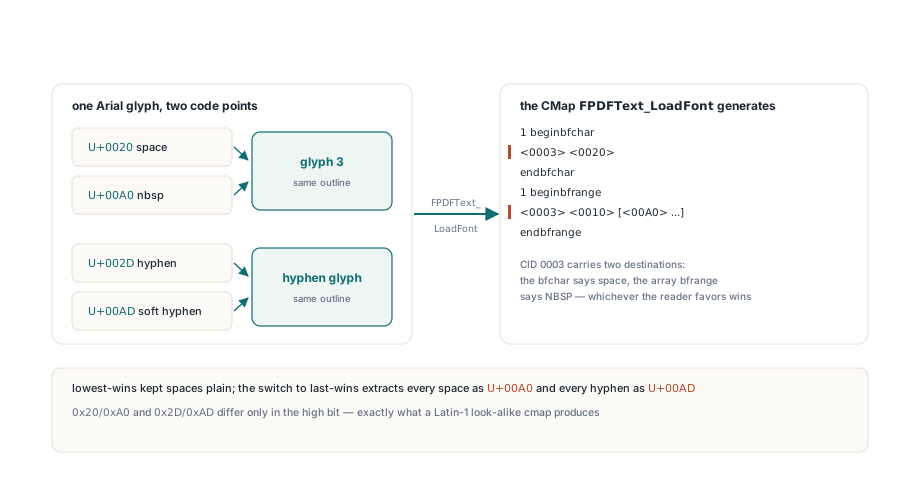
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 描述 bfchar 與 bfrange 怎麼把碼映射到 Unicode,卻沒說兩條記錄認領同一個 CID 時誰贏。讀取器各自挑一條優先權規則。保留最小或第一個映射的讀取器抽出普通空格;PDFium 的讀取器保留最後一條,而陣列範圍排在 bfchar 區塊之後,於是每個經以字形為鍵的 CMap 寫出的空格都抽出成 NBSP、每個連字符都抽出成軟性連字號。同一份文字因此在兩個檢視器裡可能抽出不同結果
這些成對的碼位有跡可循。0x20/0xA0 與 0x2D/0xAD 只差最高位元,這正是字型的 cmap 把 Latin-1 的相似字送到 ASCII 字元已在使用的輪廓時會出現的結果。希臘大寫 Omega(U+03A9)與歐姆符號(U+2126)在 Arial 裡也共用字形。如果過去正常的萃取程式碼突然在看不見的字元上失敗,請把碼位印出來,別相信除錯器的字串檢視;從頁面讀出文字的基礎,見用 Delphi 的 PDFium 從 PDF 文件萃取文字
PDFium Component 如何以碼位為系統字型建立索引
對自帶 Unicode cmap 的系統字型,PDFium Component 從不叫引擎產生那種 CMap。TPdf.AddText 需要字型時,元件讀字型自己的 sfnt cmap 表,偏好 format 12 子表、退回 format 4。碼位排序、去重之後,CID k+1 指派給第 k 個碼位,CID 0 留給 .notdef;一個明確的 CIDToGIDMap 把每個 CID 送到它的字形。於是 U+0020 與 U+00A0 拿到兩個畫同一個輪廓的不同 CID,而元件寫出的 ToUnicode CMap 把每個 CID 只映射到一個碼位
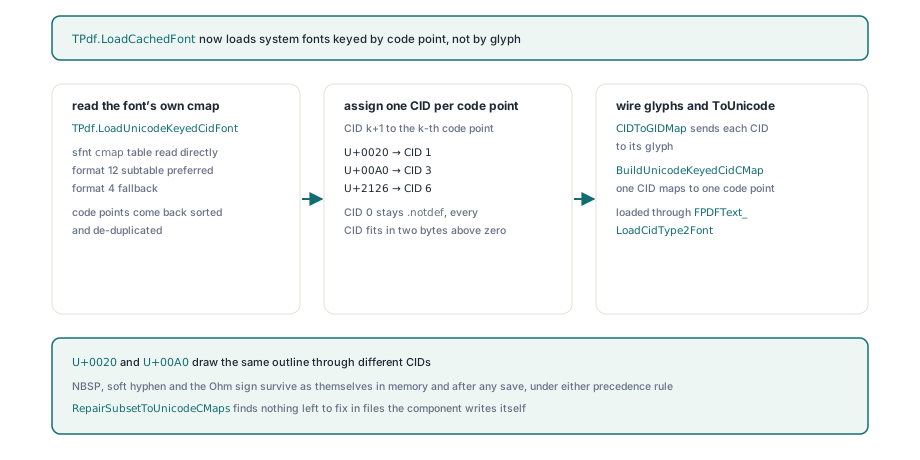
字型透過 FPDFText_LoadCidType2Font 載入,也就是以明確 CID 對 GID 映射內嵌 CID Type 2 字型一文裡字形層級寫入背後的同一個進入點。之後 FPDFText_SetText 寫字串時,反向查找落在每個字元單一的 CID 上。這一切不依賴讀取器的優先權規則,因為根本沒有第二條映射讓規則去選。存出的檔案也帶著元件自己的 ToUnicode 串流,所以重新載入後的萃取,看到的是活文件用過的同一張一對一表
代價是更大的 CIDToGIDMap:字型涵蓋的每個碼位兩位元組。假設某字型映射約 3,000 個碼位,映射就差不多 6 KB,每個字型交給引擎一份。這筆交易每次都值得:幾 KB 買到的萃取結果,在 PDFium、在保留第一個映射的檢視器、以及在客戶明年換上的任何索引器裡都讀起來相同
下面的來回測試寫入一個包含每組麻煩字元的字串,從未存檔的文件抽出、存檔、重新載入、再抽出。兩個字串都應與輸入完全一致;CodePoints 輔助函式只是為了讓不一致看得懂:
uses
  SysUtils, PDFium;

const
  // 空格/U+00A0 與連字符/U+00AD 共用一個 Arial 字形,
  // 希臘 Omega(U+03A9)與歐姆符號(U+2126)也是
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // 活的、尚未存檔的文件
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // 完整存檔再重新載入之後
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
就算您的文件很少出現 NBSP 與軟性連字號,也請把它們留在範例字串裡。只寫 ASCII 的測試對以字形為鍵的 CMap 照樣通過,因為裡面沒有任何東西要求讀取器在兩條映射之間做選擇
為什麼一條 bfrange 能滅掉整個區塊?
單一 bfrange 的 CID 連續段跨過 xxFF 邊界,會讓 PDFium 丟棄它所在的整個區塊。ISO 32000-1 §9.10.3 只允許目的端的最後一個位元組在範圍內變動,而 CID 這邊在 PDFium 的解析器裡有個對應的陷阱:它把高位 CID 推導成 (low and $FFFFFF00) or (high and $FF)。從 CID 00FE 到 0101 的連續段被讀成 00FE 到 0001,低大於高,整個區塊被標成無效。SetText 成功、頁面渲染正確,萃取卻對那個區塊裡的每個字元回傳 U+0000
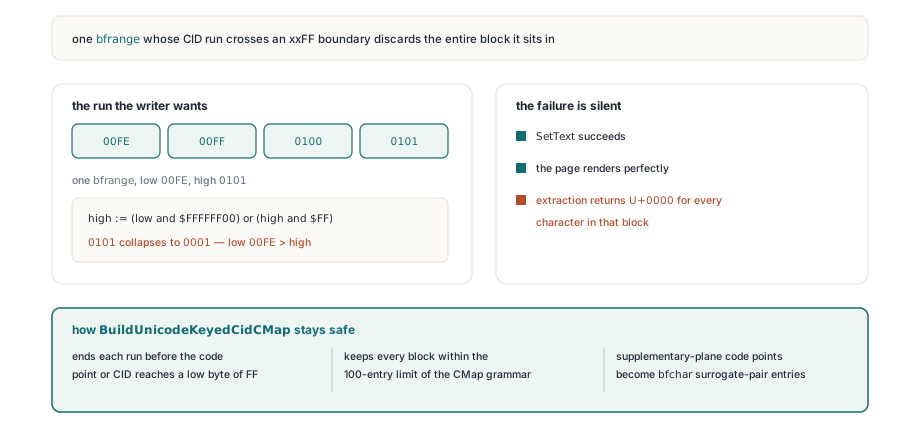
以碼位為鍵的字型正是被咬的地方。CID 密集而連續,所以碼位超過 255 的任何字型,其 CID 連續段只要寫入端直接合併相鄰項目,就會跨過 00FF、01FF 等邊界。PDFium Component 寫出的 CMap 在碼位或 CID 任一邊抵達低位元組 FF 之前結束連續段,並把項目拆成至多 100 個的區塊——那是 CMap 文法給每個 beginbfrange 與 beginbfchar 區段的上限
U+FFFF 以上的碼位拿到個別的 bfchar 項目、目的端是 UTF-16 代理對,因為在範圍內遞增代理對沒有定義的意義。代理對那部分的故事見Delphi 裡的 emoji、CJK 與代理對處理。純 bfchar 的 CMap 可以完全繞開邊界問題,代價是體積大上好幾倍,所以範圍仍是主要形式,由拆分規則扛起責任
修復其他工具產生檔案裡的 ToUnicode 衝突
FPdfCompress 單元裡的 RepairSubsetToUnicodeCMaps 修復元件沒寫過的檔案裡以字形為鍵的衝突。TPdf.SaveAs 在每次完整、非增量存檔時執行它,您也可以對任何串流直接呼叫。對帶兩個目的端的 CID,bfchar 項目勝出;CID 沒有 bfchar 時,只差最高位元的一對解析成較小的基本 Latin 碼位。其他衝突保留第一個映射
修復以等長替換就地編輯衝突的十六進位值。區塊版面、CID 覆蓋範圍與串流的其他每個位元組都保持原樣,所以 CMap 仍維持 PDFium 的讀取器已經接受的形狀。乾淨重建的 CMap 在十六進位傾印裡好看一些,但也會改變一條嚴格讀取器已經接受的串流的結構——當只有少數幾個目的端值出錯時,這是毫無回報的賭博
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // 只做等長編輯;沒有可修復衝突的檔案,
      // 還有交叉參照串流與物件串流的檔案,原樣複製
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.這個常式重建傳統交叉參照表,所以使用交叉參照串流、混合參照或物件串流的文件逐位元組原樣通過。增量存檔(saIncremental)依設計跳過修復,因為增量修訂必須保持只附加。對元件自己寫的文字,兩種情況都無關緊要:它以碼位為鍵的字型從不產生讓修復找到的衝突
以碼位為鍵的路徑適用到哪裡
以碼位為鍵的路徑涵蓋每個暴露 Unicode cmap 子表的字型,其餘交給 PDFium 以字形為鍵的載入。依賴它之前值得知道的細節:
- 只帶 (3,0) cmap 的符號字型,以及 CID 路徑載入不了的任何字型,走
FPDFText_LoadFont,兩個碼位共用的字形在那裡受讀取器的優先權規則支配 - 只有 format 4 子表時,映射涵蓋基本多文種平面;平台 (3,10) 或 Unicode 平台上的 format 12 子表則加入補充平面碼位
- 字形 0 與代理對碼位被排除在外,項目數上限 65535,讓每個 CID 都以兩位元組、大於零的形式塞得下
- TrueType Collections 需要額外照顧:GDI 的
GetFontData回傳整個 .ttc,而FPDFText_LoadCidType2Font沒有 face 索引參數,直接把 collection 傳進去會內嵌 face 0 的 SimSun——即使您要的是 simsun.ttc 裡的 NSimSun。元件把家族名稱對到字型的 name 表(nameID 1 與 16),把要求的 face 以獨立 sfnt 交出;解析不了的 collection 則整個通過、使用 face 0 - 讀不到指定名稱的系統字型時,
AddText把字型名稱交給FPDFPageObj_NewTextObj,到 PDFium 的標準字型裡查找
索引層摺疊隱形字元,文字裡保留原樣
一旦萃取回傳真實碼位,另一個問題就浮上來:作者刻意輸入的真 NBSP 或軟性連字號,搜尋索引該怎麼處理?在索引層摺疊,讓 TPdf.Text 保持原樣。抽出來的字串是文件內容的記錄;索引是為比對而建的有損檢視,摺疊規則屬於它
下面的輔助函式是您加在自己程式碼裡的函式。它把 NBSP 映射成空格、丟掉軟性連字號——按 Unicode 標準,軟性連字號只標記允許斷行的位置。它刻意不動 U+2126:NFC 正規化會把歐姆符號變成 Omega,因為 U+2126 有到 U+03A9 的正則單體分解,而規格書搜尋該不該把兩者視為相同,是產品決策而非萃取決策:
uses
  SysUtils, Classes, PDFium;

// 搜尋索引自己的輔助函式;不是 PDFium Component 的一部分
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // 原樣文字留在 Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
對第一個範例產生的 codepoints.pdf 跑 IndexDocument,索引後的那行應該讀作 "two-x yz ΩΩ",十一個字元、最後一個是歐姆符號;而 Pdf.Text 仍回傳原始十二個字元,NBSP 與軟性連字號都在
以碼位為鍵的字型、CMap 修復與文字萃取,在 Delphi、C++Builder 與 Lazarus 之間共用同一個頁面模型;字型與文字 API 完整涵蓋於 PDFium Component for Delphi 產品頁