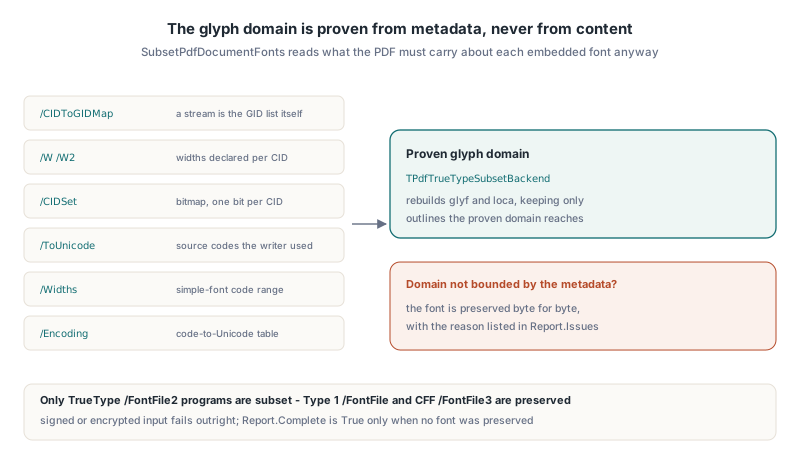
PDFium Component 透過 FPdfDocumentFontSubset 單元裡的 SubsetPdfDocumentFonts,對已內嵌在既有 PDF 裡的字型做子集化。只有當字型資源本身能證明文件可能參照的每一個字形時,函式才會把內嵌的 TrueType /FontFile2 程式換成更小的版本;字形域證明不了的字型原樣保留
想要它的常見原因是一批不是您產出的檔案。老舊產生器做出的發票、對帳單與報告,常常每份都帶完整的 Arial 或整套 CJK 字體,兩頁的文件背幾百 KB 的字型,幾百萬份文件疊起來很快。從源頭重新渲染很少可行。您手上只有 PDF,唯一安全的問題是:每個內嵌字型能砍掉多少,而任何一頁都不會丟字
對既有 PDF 做子集化為什麼可能丟字形?
風險在於後處理器不知道原寫入器用過哪些字形。內嵌字型的生產者知道自己的文字;事後執行的工具得把這份知識重建出來,漏掉的字形會變成空白方塊或 .notdef 形狀,長在一頁沒人看的頁面上——直到客戶看見
顯而易見的做法是解析每條內容流、每個 Form XObject、每個註解外觀與每個欄位預設外觀,收集每個字型顯示過的代碼,保留那些字形。它有效,直到撞上跨頁與表單共用的字型資源、外觀會被檢視器從 /DA 重新生成的表單欄位,或掃描器沒建模的運算子序列。SubsetPdfDocumentFonts 刻意不掃描內容流。它從 PDF 反正必須為每個字型攜帶的中繼資料導出字形域:/CIDToGIDMap、/W 與 /W2 寬度陣列、/CIDSet 點陣、/ToUnicode CMap、簡單字型的 /Widths 陣列與 /Encoding。中繼資料框不住域時,字型保持原樣
保留原始字形 ID,內容流因此不必動
SubsetPdfDocumentFonts 背後的子集後端 TPdfTrueTypeSubsetBackend 保留每個原始字形 ID 槽位,因此內容流、CID 與 /CIDToGIDMap 永遠不必改寫。它重建 glyf 與 loca 表,給每個未用字形零長度的 loca 區間,maxp.numGlyphs 保持不變。字形 4711 子集化之後還是字形 4711;只是文件到得了它才有輪廓
這個選擇拿掉了子集化成品文件最危險的部分。重編字形號意味著改寫每條使用該字型的內容流裡的每個字串,加上映射流,加上任何快取字形 ID 的東西。保留 ID 犧牲一點尺寸,因為 loca 為每個原始字形保留一個條目,但 TrueType 程式的大頭是輪廓資料,砍的正是它。複合字形會追蹤到其元件,帶重音符的字母因此保住基礎字母與構成它的重音符;循環或過深的複合參照讓字型失敗,而不是產出破碎的閉包
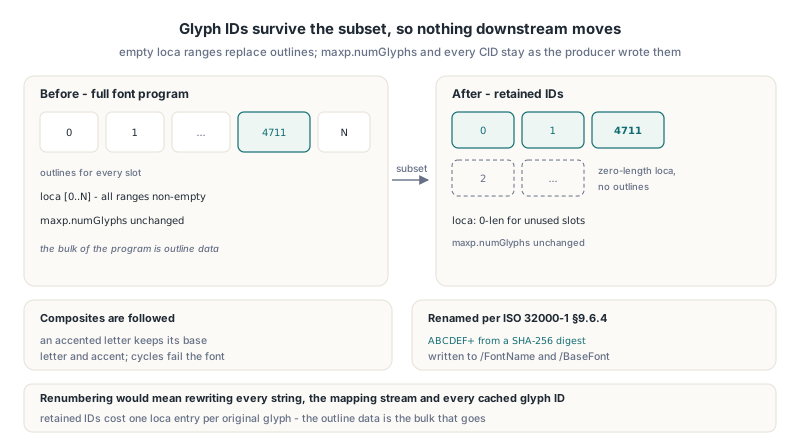
改名後的字型也遵循 ISO 32000-1 §9.6.4,它要求子集字型名稱以六個大寫字母加一個加號開頭。元件從新字型程式的 SHA-256 摘要導出六個字母,先剝掉既有的 ABCDEF+ 前綴,解決同一文件中字型之間的撞名,並把新名稱寫進描述項的 /FontName 與字型字典的 /BaseFont,包括 CIDFont 的 Type0 父節點
uses
  System.SysUtils, System.Classes, FPdfDocumentFontSubset;

procedure SubsetEmbeddedFonts(const SourceName, TargetName: string);
var
  Source, Target: TFileStream;
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Source := TFileStream.Create(SourceName, fmOpenRead or fmShareDenyWrite);
  try
    if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
      raise Exception.Create('Font subsetting failed: ' + Report.ErrorMessage);
  finally
    Source.Free;
  end;
  // 輸出永遠是完整 PDF:Report.Applied 為 True 時是重建的檔案,
  // 否則是來源的逐位元組副本
  Target := TFileStream.Create(TargetName, fmCreate);
  try
    if Length(Output) > 0 then
      Target.WriteBuffer(Output[0], Length(Output));
  finally
    Target.Free;
  end;
end;
SubsetPdfDocumentFonts 怎麼證明 CIDFont 的字形域?
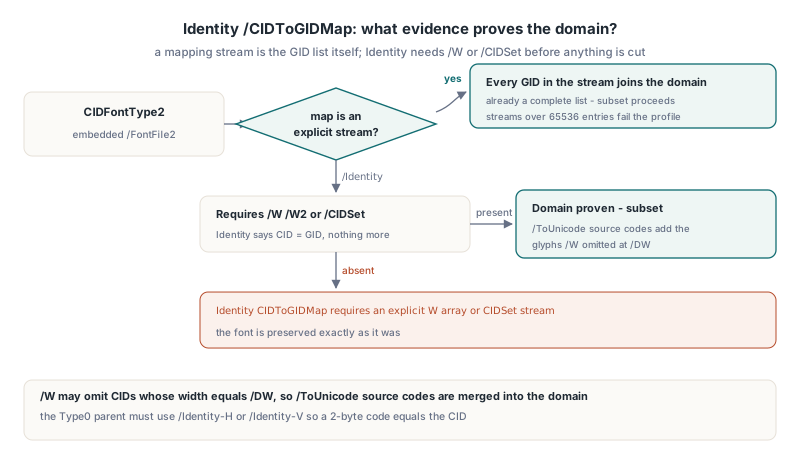
SubsetPdfDocumentFonts 從 CID 到字形的映射證明 CIDFontType2 字型的字形域,而映射決定需要多少額外證據。顯式的 /CIDToGIDMap 流(ISO 32000-1 §9.7.4.2)本身就是該字型可定址的每個字形的清單,所以流裡每個 GID 都進域。超過 65536 項或位元組數為奇數的映射流,超出有界 profile,字型保留
/CIDToGIDMap /Identity 是硬骨頭,也是現代檔案裡最常見的情況。Identity 說 CID 等於 GID,對文件用了哪些 CID 隻字未提。因此元件要求初級證據:顯式的 /W 或 /W2 寬度陣列(§9.7.4.3),其 CID 條目標記生產者為其聲明過度量的字形;或字型描述項裡的 /CIDSet 流(§9.8.3),每個 CID 一個位元的點陣,最高有效位在前。兩者皆無的裸 Identity 字型被保留,原因為 Identity CIDToGIDMap requires an explicit W array or CIDSet stream
拿 /W 當證據的陷阱是 /DW。規範允許生產者省略每個寬度等於預設寬度的 CID,而優化得好的寫入器對最常見的字形寬度恰恰這麼做。如果域只來自 /W,那些字形會悄悄從子集裡消失。為補上這個缺口,元件走訪每個 /DescendantFonts 指向該 CIDFont 的 Type0 字型,要求其 /Encoding 為 /Identity-H 或 /Identity-V(2 位元組代碼即 CID),並把其 /ToUnicode CMap(§9.10.3)裡每個 beginbfchar 與 beginbfrange 條目的來源代碼併進域。其他任何編碼,或預算內解不開的 /ToUnicode 流,都保留字型
簡單 TrueType 字型:從 Widths 到字形 ID
單位元組的 /Subtype /TrueType 字型先由代碼範圍與編碼證明,再經字型程式自己的 cmap 解析到字形 ID。元件要求 0 <= FirstChar <= LastChar <= 255,以及長度恰為 LastChar - FirstChar + 1 的 /Widths 陣列;太短、太長或含非數字的陣列代表代碼域未被證明,字型保持原樣
該範圍裡的每個代碼,加上 /Differences 指名或 /ToUnicode 涵蓋的代碼,再按 ISO 32000-1 §9.6.6 描述的方式映射。/WinAnsiEncoding、/MacRomanEncoding 或 /StandardEncoding 底下的代碼走對應表到 Unicode。/Differences 的字形名稱經 Adobe Glyph List、uniXXXX 與 uXXXX 名稱、258 個標準 Macintosh 字形名稱,以及字型自己的 post 格式 2.0 名稱表解析。得到的值再到格式 0、4、6 與 12 的 cmap 子表查找,包括 Unicode 的 (3,1)、(3,10) 與 (0,*)、Mac Roman 的 (1,0),以及 F000 加代碼的 Windows Symbol (3,0)
字型完全沒有基礎編碼時,元件標記所有合理解釋的聯集,而不是挑一個猜。這會多留幾個可能沒用的字形,往這個方向犯錯是對的。反向的情況則嚴格:映射不到任何已證字形 ID 的 /Differences 名稱會拒絕整個字型,因為一個解不開的名稱就代表域不完整
procedure ReportFontSubset(Source: TStream; Log: TStrings);
var
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
  I: Integer;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Options.SubsetOptions.MinimumSavingPercent := 10;  // 按字型計
  Options.MinimumDocumentSavingPercent := 5;         // 整份檔案
  if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
  begin
    Log.Add('Rejected: ' + Report.ErrorMessage);
    Exit;
  end;
  Log.Add(Format('Fonts %d, subset %d, preserved %d, glyphs %d',
    [Report.FontCount, Report.SubsetFontCount, Report.PreservedFontCount,
     Report.GlyphCount]));
  Log.Add(Format('Font bytes %d -> %d, file bytes %d -> %d',
    [Report.OriginalFontBytes, Report.SubsetFontBytes,
     Report.SourceByteCount, Report.OutputByteCount]));
  for I := 0 to High(Report.Issues) do
    Log.Add(Format('  object %d kept: %s',
      [Report.Issues[I].ObjectNumber, Report.Issues[I].Reason]));
end;
SubsetPdfDocumentFonts 放過哪些東西?
SubsetPdfDocumentFonts 放過每個它證明不了的字型,並在 Report.Issues 裡帶物件編號與原因逐一回報,而不是讓整份文件失敗。只有沒有任何字型被保留時 Report.Complete 才是 True。承諾縮減尺寸之前,這些保留情況值得知道:
- Type 1 的
/FontFile與 CFF 或 OpenType 的/FontFile3程式,回報為Only TrueType FontFile2 programs are supported - 沒有
/W、/W2或/CIDSet的 Identity CIDFont,以及既無映射流也非/Identity的 CIDFont - 從字型描述項以外的地方被參照的字型程式,以及與非
CIDFontType2或非簡單TrueType消費者共用的描述項 - 子集後省不到
SubsetOptions.MinimumSavingPercent的字型,以及重建檔案省不到MinimumDocumentSavingPercent時的所有字型;後一種情況下Report.Applied為False,輸出是原始位元組
有兩種輸入直接失敗而不是保留。已簽署的文件與含簽章欄位的文件被拒,因為替換字型物件會讓每個簽章的位元組區間失效;加密檔案需要先解密來源。成功的執行以稀疏更新寫出替換物件,然後透過修剪孤立物件與資源去重指南所述的同一趟可達性掃描重建檔案,舊字型程式因此不會以不可達物件的身分存活,結果是單一乾淨的修訂版
存檔時以 saSubsetNewFonts 子集化新文字
PDFium Component 在本次會話期間內嵌的字型是另一種情況,由 saSubsetNewFonts 存檔選項處理,而不是 SubsetPdfDocumentFonts。saSubsetNewFonts 對應 PDFium 的 FPDF_SUBSET_NEW_FONTS 旗標,對 TPdf.AddText 這類原生呼叫從系統載入的字型(包括 OpenType CFF 字體)跑原生的 HarfBuzz 子集器。上游 PDFium 仍把該旗標標為實驗性。它不碰檔案裡本來就有的字型
var
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(0, 595, 842);
    Pdf.AddText('Quarterly statement', 'Arial', 14, 72, 770, clBlack, $FF, 0.0);
    if not Pdf.SaveAs('statement.pdf', saSubsetNewFonts) then
      raise Exception.Create('Save failed');
  finally
    Pdf.Free;
  end;
end;
在元件的探測裡,帶 Arial 文字的文件在 saSubsetNewFonts 下從 590 KB 縮到 22 KB,存出檔案的文字擷取仍然完全相符。一款 COLR v0 彩色字型——7.0 MB 的 Segoe UI Emoji——走同一條路到 10.5 KB,因為 PDF 沒有 COLR 圖層的概念,渲染為其基礎輪廓。可變字型是例外,擋在子集器前面:GDI 的 GetFontData 為 1.85 MB 的 Segoe UI Variable 檔案回傳了 18.3 MB 的替代流,文字物件在任何子集化開始之前就建立失敗。這些字型先走的內嵌路徑,見從 Delphi 內嵌 CID Type 2 字型的走查
證明的邊界在哪裡
SubsetPdfDocumentFonts 裡的證明,恰好與生產者寫下的字型中繼資料一樣強。證據只有 /W 的 Identity CIDFont 仍有一個盲點:寬度等於 /DW、沒有 /ToUnicode 條目、描述項的 /CIDSet 也沒列它的字形。這種字形無法從資源證明,元件在刻意不做內容流掃描的前提下無從知道它存在。同時省略 /ToUnicode 與 /CIDSet 又壓縮 /W 的生產者很少見,但確實存在,所以對來路不明的產生器產出的檔案,前後各渲染一份樣本,比對像素與擷取文字
跑批次之前,先弄清楚手上有什麼也有幫助。用 PDFium Component 讀取 PDF 字型屬性的做法告訴您哪些字型有內嵌,試跑一次拿到的 Report.Issues 告訴您其中哪些會被保留、為什麼。預設選項也框住了工作量:1024 個字型、總計約一百萬個字形、128 MB 來源與固定的工作預算,長批次可選 CancellationToken
FAQ
SubsetPdfDocumentFonts 會改變 PDF 的文字或版面嗎?
不會。原始字形 ID、CID、寬度與內容流都保留,文字擷取與渲染用的是和以前相同的字形;只有到不了的輪廓被移除,字型名稱換上新的子集前綴
為什麼某個內嵌字型沒被子集化?
看 Report.Issues。每個保留的字型都帶原因,例如 Identity CIDFont 缺 /W 或 /CIDSet、非 TrueType 程式、畸形的 /Widths 陣列,或節省低於門檻
saSubsetNewFonts 與 SubsetPdfDocumentFonts 一樣嗎?
不一樣。saSubsetNewFonts 在您存檔時子集化本次會話內嵌的字型,而 SubsetPdfDocumentFonts 作用於既有的 PDF 流,替換的是先前由其他生產器內嵌的字型
文件字型子集化、存檔時的字型子集化,以及背後的孤立物件修剪,都隨PDFium Component for Delphi and C++Builder 提供,為 Delphi、C++Builder 與 Lazarus 專案包裝 PDFium