把 FDF 匯入表單,欄位值回來的樣子錯得很微妙:項目符號變成劍號,省略號變成全形破折號。PDFium Component 把整族症狀追到 PDFDocEncoding 表格裡的單一列——ISO 32000-1 Annex D.2 的特殊字元區塊從 $80 開始,不是 $7F
為什麼 FDF 匯入回傳的是鄰居字元?
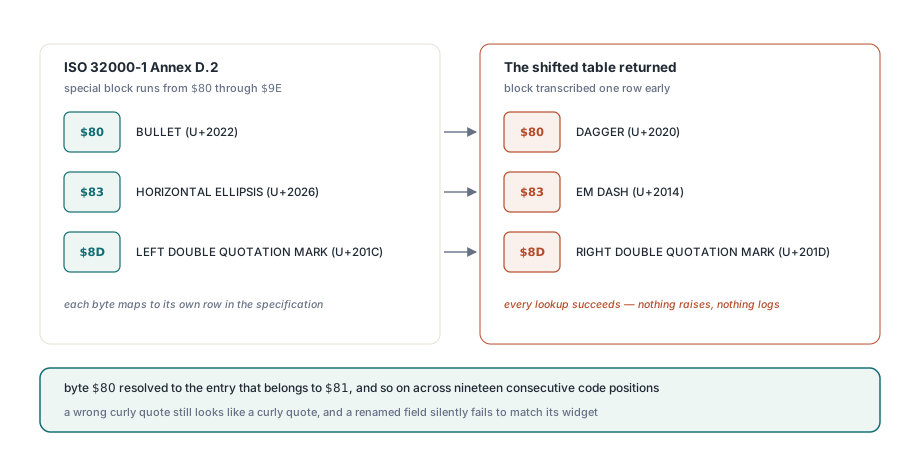
因為偏移一位的編碼表看起來依然是一份完全正常的表格,表裡的每個查詢都成功。Annex D.2 指派給 $80 到 $9E 的區塊被抄早了一列,所以位元組 $80 解析到屬於 $81 的項目、位元組 $81 解析到 $82 的項目,一路錯過連續十九個編碼位置。沒有拋錯、沒有日誌,也沒有任何欄位被拒絕——TPdf.ImportFDF 回報的欄位數跟以前一模一樣
傷害是一致且無聲的。帶 $80 的位元組——Annex D.2 定義為 BULLET(U+2022)——回來變成 DAGGER(U+2020)。$83,HORIZONTAL ELLIPSIS(U+2026),回來變成 EM DASH(U+2014)。$8D,LEFT DOUBLE QUOTATION MARK(U+201C),回來變成 RIGHT DOUBLE QUOTATION MARK(U+201D)——這是沒人會注意的案例,因為錯誤的彎引號在表單欄位裡看起來還是彎引號。欄位名稱與欄位值遭到同樣的命運,而這更糟:一個不再對得上文件裡控制項的名稱,會無聲地套用失敗
PDF 文字字串承載兩種不同的編碼
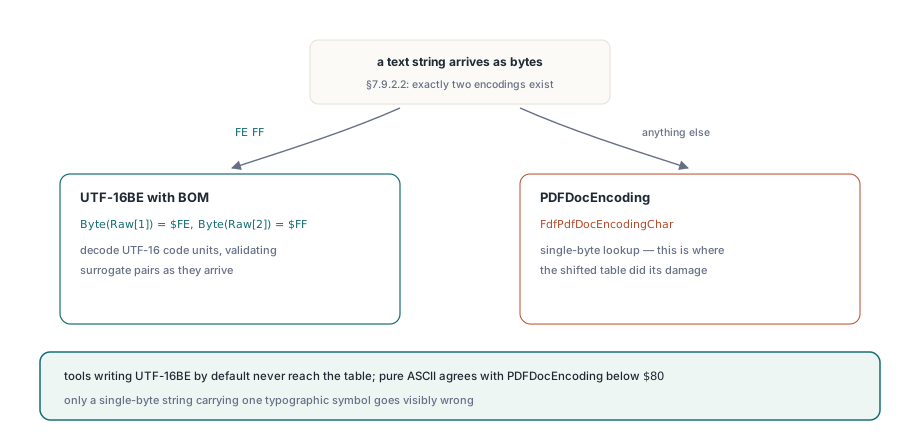
ISO 32000-1 §7.9.2.2 把文字字串型別定義為恰好兩種編碼之一,靠檢查前兩個位元組決定,而不是靠任何字典項目。以位元組順序記號 FE FF 開頭的字串是 UTF-16BE,其他一律是 PDFDocEncoding。這單一分支決定兩套完全不同的解碼器誰要上場,PDFium Component 在 FDF 剖析器內部、碰到任何字元之前就先套用它
// FDF 文字字串:有 BOM 時是 UTF-16,否則為 PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... 解碼 UTF-16 code unit,並驗證代理對
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
這就是為什麼這隻 bug 在一般測試裡躲了那麼久。任何由預設寫 UTF-16BE 的工具產生的 FDF,根本不會碰到 FdfPdfDocEncodingChar,偏移的表格因此保持沉睡。只有單位元組字串——很多 FDF 產生器對純拉丁欄位名稱輸出這種格式,因為比較短——會走進那張表格有關係的分支。純 ASCII 的欄位名稱反正也解碼正確,因為 $80 以下 PDFDocEncoding 與 ASCII 一致。您需要一個含印刷符號的單位元組字串,才會看到明顯出錯
修正後的表格,與釘住它的兩個錨點
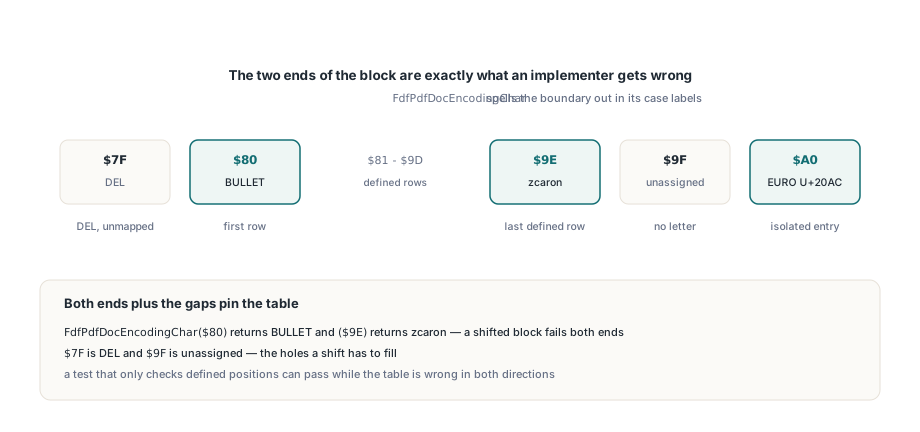
PDFium Component 現在直接在 FdfPdfDocEncodingChar 裡把邊界寫明,因為區塊的兩端正是實作者最容易弄錯的地方。$7F 是 DEL,在 PDFDocEncoding 裡完全沒有意義;區塊在 $80 以 BULLET 開頭,跑到 $9E 的 zcaron 結束;$9F 未指派;歐元符號單獨待在 $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2。區塊從 $80 開始,不是 $7F:$7F 是 DEL 且
    // 在 PDFDocEncoding 中沒有意義;歐元在 $A0,否則預設分支會把它當作
    // no-break space 回傳
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET,區塊的第一列
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 到 $9D
    $9E: Result := WideChar($017E);   // zcaron,最後一個有定義的列
    $9F: Result := WideChar($FFFD);   // Annex D.2 中未指派
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
看看偏移對這兩個端點做了什麼,因為差一錯誤就是從這裡開始不再是表面問題。zcaron 在規範裡位在 $9E,在偏移的表格裡卻在 $9D,所以文件裡一個 $9E 位元組會越過大家抄寫的最後一列,直接掉進身分對應的 fallback,回傳一個 C1 控制字元而不是字母。$A0 的歐元從一開始就沒被寫進表格——身分分支把它當 U+00A0 NO-BREAK SPACE 交回去,一個通過之後所有驗證、印出來什麼都不是、永遠對不上您要找的欄位名稱的字元
您怎麼測試一份轉錄的編碼表?
測試第一列、最後一列與空隙——不要抽中間的樣本。這是這次修正裡值得帶到任何其他從規範抄出來的表格的部分,因為區塊中間的抽查正是整塊平移能通過的測試。驗證 $8D 給出左雙引號證明不了什麼,因為 $8C 給出的東西看起來也合理;驗證 $80 給出 BULLET、$9E 給出 zcaron 才能同時釘住兩端,而偏移的區塊無法同時滿足兩者
procedure CheckPdfDocEncodingAnchors;
begin
  // Annex D.2 特殊區塊的兩端:整塊平移會讓這兩個失敗
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // 規範未定義的編碼位置不得解碼成字母
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // 區塊上方孤立的項目,最容易整個漏掉
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
未定義的位置值得擁有自己的 Assert,而不是當作無趣被跳過。差一錯誤總得把某個東西放到某個地方,而它放的地方幾乎總是規範留空的編碼位置——前面 $7F、後面 $9F。只檢查有定義位置的測試,可以在表格兩個方向都錯的情況下照樣通過;釘住空洞的測試第一次跑就會抓到偏移
在來回往返的表單流程裡,這要付出什麼代價
一個無聲地把每個符號改寫成另一個字元的 FDF 匯入,比失敗更糟,因為失敗在下游浮現,而且看起來像別的問題。欄位名稱是這裡的銳利邊緣。TPdf.ImportFDF 把進來的名稱跟開啟文件裡的控制項比對,一個解碼錯一個字元的名稱就是配不上——欄位保持空白,回傳值仍然把欄位算作已剖析,管線輸出的報告少一個值,日誌裡卻沒有解釋為什麼。任何在搭建使用 PDFium Component 匯出與匯入 XFDF 表單資料和註解那種匯出再匯入迴圈的人,在信任這個迴圈之前,都應該對一個含印刷符號的欄位名稱做來回往返,而不是只用純 ASCII
對修正的限制保持誠實也值得。表格現在對全部 256 個位元組值都符合 Annex D.2,單位元組 FDF 字串因此解碼正確,但 PDFDocEncoding 本身只涵蓋拉丁字元集、沒有更多——範圍外的東西必須以帶 BOM 的 UTF-16BE 進來,而這正是 §7.9.2.2 的本意。UTF-16 字串在 Delphi 端也還有自己獨立的地雷:超過 U+FFFF 的碼點需要代理對,而不是一個 WideChar,這個問題在為什麼 emoji 與 CJK 字元會弄壞 Delphi 的 WideChar裡有討論。更大的觀點可以推廣到編碼表之外:一個 PDF 剖析器可能拒絕它該接受的東西——您立刻就會發現;也可能接受並默默弄錯——您在生產環境才會發現。安全解析 PDF 字典裡描述的名稱 token 陷阱屬於第二類,偏移一列的表格也是——程式路徑成功、回傳值看起來合理,只有對照規範而非對照實作寫的測試會說出真相
TPdf 上的 ImportFDF、ExportFDF 與 ImportXFDF,連同背後支撐它們的 FDF 與 XFDF 剖析器,都是適用於 Delphi 與 C++Builder 的標準版 PDFium Component 的一部分