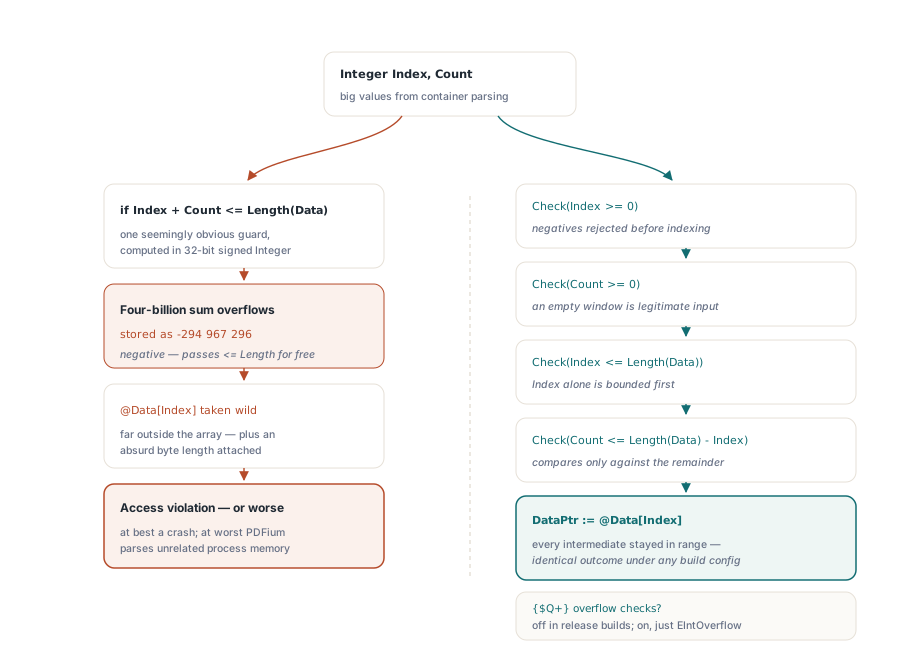
關閉溢位檢查時,兩個運算元都是 Delphi Integer 的 2000000000 + 2000000000 會算出 -294,967,296。當容器剖析器從記錄標頭讀出偏移量與長度、把兩者相加來看內嵌的 PDF 是否裝得進緩衝區時,這個數字就不再是冷知識了。和回繞成負數,與 Length(Data) 的比較通過,下一行就取了一個大約在陣列結尾之後兩 GB 處的位元組位址。從較大緩衝區中段載入 PDF,需要一個永遠不做加法的範圍檢查,以及一個明確的答案:文件開啟之後,位元組歸誰所有
本文討論的是已經在 RAM 裡、位於其他東西內部某個已知偏移量的文件。大到放不進記憶體的文件是另一個問題,要靠按需從磁碟拉取區塊來處理,如 用 PDFium VCL 按需串流大型 PDF 所述。最後一節會畫出這條界線
位於已知偏移量的內嵌 PDF
郵件存放區把信件本文與附件放在同一筆記錄裡。封存容器把一份清單、幾張影像與一個 PDF 串接起來。自訂的線路協定把文件框在一個帶長度前綴的標頭後面。假設記錄有 40 MB,PDF 從第 1,182,336 個位元組開始、長 312 KB。習慣性的寫法是呼叫 Copy(Data, Index, Count) 切出一片,再把這一片交給一個會再複製一次到自己緩衝區的載入器。把容器算進去,同樣的 312 KB 現在存在三份,而信箱掃描會對每一封信重複這件事
PDFium Component 直接定址這個視窗。TPdf 宣告了 LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True),其中 Index 是從零起算的位元組位置,Count 是位元組長度。這個方法驗證兩個數字、算出單一個指標,再轉交給指標多載 LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean),由它透過 FPDF_LoadMemDocument64 開啟文件。整個陣列的形式 LoadDocument(const Data: TBytes; Buffered: Boolean) 只是一行對位元組範圍形式的呼叫,傳入 0 與 Length(Data),所以每次 TBytes 載入都經過同一套驗證
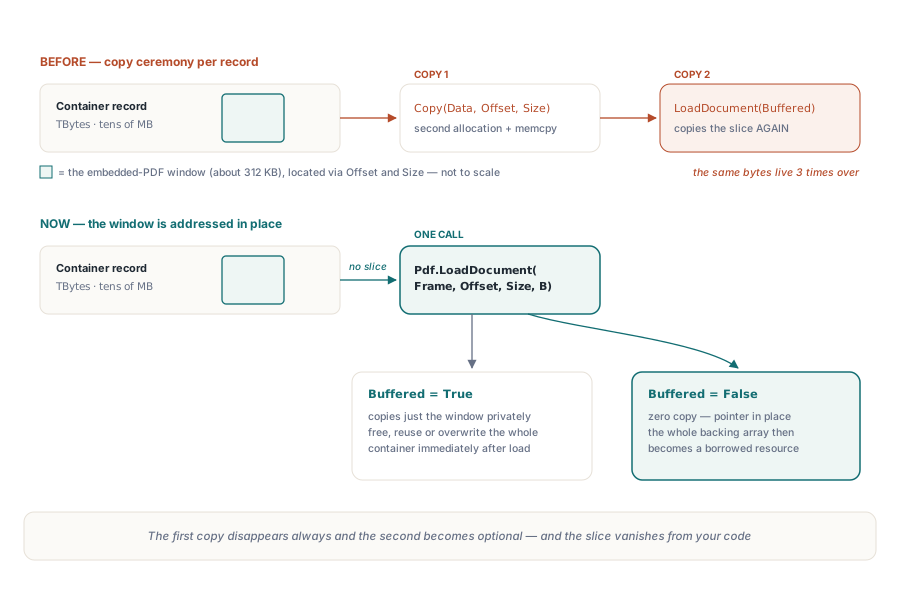
在程式碼裡,那一片切片就直接消失了。LocateEmbeddedPdf 代表你自己的容器剖析器
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // 整筆容器記錄,幾十 MB
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // 你的剖析器,不屬於元件

  Pdf := TPdf.Create(nil);
  try
    // 不做 Copy(Frame, Offset, Size):視窗就地定址
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered 預設為 True
    Frame := nil;  // 這裡沒問題:只複製了 PDF 視窗
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // 關閉文件
  end;
end;
當全域的 EnableV8Engine 仍為 False 且 PDFium 函式庫尚未載入時,記憶體載入器會掃描傳入的位元組尋找 XFA 標記,找到就把 EnableV8Engine 打開,讓支援 V8 的 DLL 被載入。用位元組範圍呼叫時,這次掃描只看得到視窗。同一筆記錄其他位置的清單或第二份文件觸發不了它
為什麼 Index 加 Count 會讓邊界檢查溢位?
因為 Index 與 Count 都是 32 位元有號 Integer,兩個很大的正數相加,不一定可靠地得到一個很大的正數。偏移量與長度來自檔案標頭時,攻擊者或損壞的記錄同時控制了這兩個值。同樣的陷阱也等在你自己的容器剖析器裡,畢竟這些數字是它先算出來的
// 給你自己容器剖析器用的輔助函式(建議寫法,不屬於元件)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // 錯誤:Index + Count 以 Integer 計算,可能回繞成負數
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // 正確:先排除負號,單獨限制 Index,再把 Count
  // 與餘量比較;唯一的算術是一次不會回繞的減法
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;把失敗的案例走一遍。Index = 2000000000 與 Count = 2000000000 時,真正的和是四十億,但 32 位元有號算術把它存成 -294,967,296。這個值輕輕鬆鬆低於任何 Length(Data),所以錯誤的檢查通過了,@Data[Index] 指向陣列外很遠的地方,還附帶一個兩 GB 的長度。當機已經是好結果了。壞結果是 PDFium 把剛好住在那裡的任何行程記憶體拿來剖析
正確的順序永遠不做加法。在索引任何東西之前先拒絕負值。接著只拿 Index 與 Length(Data) 比較,這保證 Length(Data) - Index 是非負的 Integer,然後才把 Count 與這個餘量比較。Delphi 預設以短路邏輯求值 and({$B-}),所以後面的每一項只在前面的都成立時才執行。別把 {$Q+} 當安全網:release 建置通常都關著溢位檢查,而就算開著,你也只是把一個記憶體安全漏洞換成一個從驗證常式中途逃出來的 EIntOverflow
位元組範圍的 LoadDocument 以同樣的順序跑同樣的四項測試,並丟出 EPdfError,訊息點名失敗的規則:"PDF byte range index cannot be negative"、"PDF byte range count cannot be negative"、"PDF byte range index exceeds data length" 與 "PDF byte range exceeds data length"。每一條都能用一個四位元組的陣列重現。Index = 5, Count = 0 觸發第三則訊息,Index = 2, Count = 3 觸發第四則,而每次拒絕之後 Pdf.Active 仍然是 False。跨越原生邊界時對不可信長度的同一套處理方式,在 強化 Delphi 中 PDFium VCL 的 ABI 與記憶體安全 一文有更廣泛的介紹
零長度的視窗仍然是合法呼叫
空視窗傳的是 nil 指標,因為對驗證接受的每一個 Index 來說,@Data[Index] 不見得都是合法的運算式。Index = Length(Data) 搭配 Count = 0 是一個位於緩衝區尾端、格式良好的空視窗,而空的 TBytes 則讓 Index = 0 落在一個沒有第零個元素的陣列上。這兩種情況下取位址,不是讀過了結尾,就是對 nil 動態陣列解參照,而開著範圍檢查時,Delphi 會在載入器還沒開始跑之前就丟出 ERangeError
所以位元組範圍多載會分支:Count = 0 得到 nil,其他任何數量得到 @Data[Index]。指標多載只在大小為零時接受 nil,接著 PDFium 拒絕開啟空緩衝區,呼叫以一個普通的 EPdfError 收場,帶著 PDFium 的最後錯誤文字,或者在 PDFium 什麼都沒回報時帶著 "Cannot load PDF document"。宣稱附件為零位元組的標頭,會拿到與其他任何壞輸入相同的可捕捉例外。不過在你的剖析器裡就把它拒絕掉,並在訊息裡帶上記錄編號,在支援日誌裡讀起來還是好得多
Buffered 決定位元組歸誰所有
Buffered 是這裡唯一一個後果會延續到呼叫結束之後的參數。Buffered = True 時,元件會在載入前把選定的視窗(而且只有視窗)複製到自己的緩衝區。在 40 MB 的例子裡,複製的是 312 KB,容器則不動。LoadDocument 一回傳,你就可以立刻釋放、重用或覆寫容器
Buffered = False 時,@Data[Index] 直接送進 FPDF_LoadMemDocument64,而只要文件還開著,PDFium 就會一直透過那個指標讀取。整個後備的 TBytes 變成借用狀態。它必須保持存活且不被修改,直到你設定 Active := False 或釋放 TPdf。重要的是整個陣列,不只是視窗:Delphi 動態陣列是以一整塊來做參照計數的,所以在你程式碼的任何地方放掉最後一份參照,就會釋放 PDFium 仍在讀取的記憶體。SetLength 同樣致命。重新配置可能會搬動這塊記憶體
有兩個 Delphi 細節讓這件事比看起來更容易出錯。動態陣列不像字串,沒有寫入時複製,所以 Other := FFrame; Other[0] := 0; 寫進去的正是 PDFium 正在剖析的那些位元組。而你的網路程式碼為下一個框架重用的接收緩衝區,會在文件還開著的時候被覆寫。像 Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False) 這樣把函式結果直接傳進去,陣列就只被一個隱藏的暫時變數抓著,它會隨呼叫常式一起死去,而文件還活著
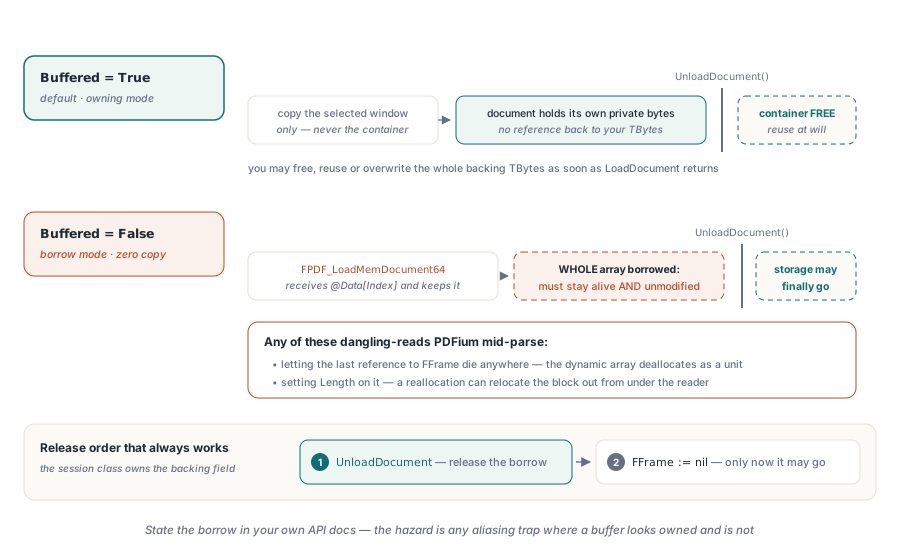
凡是會跨執行緒、躲在可重用緩衝區後面,或比載入它的常式活得更久的東西,都保留 Buffered = True。額外成本是一次 PDF 自身大小的複製,換來的是呼叫一回傳就能丟掉 40 MB 記錄的自由。借用只有在容器本來就是你整個工作階段都會持有的長壽欄位時才值得,例如一個在使用者翻閱附件期間一直開著封存記錄的檢視器。那種情況下,請在單一類別裡把所有權寫明白
type
  TFrameSession = class
  private
    FFrame: TBytes;   // 在 FPdf 開著文件期間擁有後備儲存空間
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // 共用這個陣列;現在不准其他人寫入
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // 先關閉前一個視窗
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame 必須比這份文件活得久
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. 釋放借用
  FPdf.Free;
  FFrame := nil;         // 2. 現在儲存空間才可以走
  inherited;
end;
建構函式共用呼叫端的陣列而不是複製它,所以呼叫端必須停止對它寫入。如果你無法承諾這一點,就把 Copy(AFrame) 傳給建構函式,這樣又回到一次複製,只是每個工作階段做一次,而不是每次載入做一次
確認視窗從 %PDF- 開始
差了幾個位元組的視窗是最隱晦的失敗,因為文件可能照樣開得起來。ISO 32000-1 §7.5.4 把每個交叉參照項目定義為從檔案開頭算起的位元組偏移量,§7.5.2 則把 %PDF- 標頭放在最前面。當你的剖析器數錯了前綴、視窗早了八個位元組開始,那些偏移量就全差了八個位元組。PDFium 會在前 1024 個位元組內尋找標頭並補償前導垃圾;開始得太晚或結束得太早的視窗,則可能逼它從找到的物件標記重建交叉參照表。不管哪一種,頁數看起來都是對的。你剖析器裡的偏移量仍然是錯的,而下一個讀這筆記錄的程式可能就沒這麼寬容了
多載 LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) 讓這件事看得見。Report.HeaderOffset 是在視窗前 1024 個位元組內找到 %PDF- 的位置,找不到時為 -1。Report.UsedRecovery 在 PDFium 不接受交叉參照表為有效時為 True。報告中所有偏移量都從視窗的第一個位元組算起,而不是從容器算起。太短的 Count 會切掉結尾的 %%EOF,而 TPdfLoadOptions.Default(plmStrict) 會打開 RequireFinalEndOfFileMarker,所以嚴格模式會直接拒絕那個視窗
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning 是你自己的記錄常式
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
這些欄位背後的稽核有一項成本,對借用式載入很重要。當視窗裝得進 Options.AuditByteLimit(預設 256 MB)時,稽核讀的是視窗的一份暫時副本,所以 Buffered = False 搭配報告在載入期間就不再是零複製了。把 AuditByteLimit 設為 0 會跳過稽核與複製,並讓 HeaderOffset 維持在 -1。開發容器剖析器期間,以及面對新的記錄來源時,用帶稽核的形式跑;偏移量可信之後再換回普通多載。報告的其餘部分在 用 PDFium 載入報告抓出 PDF 載入失敗 一文中介紹
什麼時候位元組範圍是錯的工具
位元組範圍多載假設整個容器已經在記憶體裡,而且因為 Count 是 Integer,單一視窗不能超過 MaxInt 個位元組。磁碟上 6 GB 的封存檔,或一個無法倒帶的 socket,都不符合這個形狀,而只為了定址裡面的一個視窗就把一切讀進 TBytes,更是本末倒置。這些情況下,LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) 讓 PDFium 從可定位的串流按需拉取區塊。自己寫一個小小的 TStream 後代,在每次 Seek 時加上 PDF 的起始偏移量,就能讓內嵌文件看起來像從位置零開始,如 按需串流那篇文章 所示
另一種不匹配是內容還不是純 PDF。如果內嵌的位元組是壓縮過的、被容器加密的,或包在另一種編碼裡,一份轉換後的副本就免不了,而用預設的 Buffered = True 載入那個新陣列就是最直接的答案。位元組範圍只在一種形狀下划算:連續、未經修改、已經常駐在記憶體裡的 PDF 位元組,位於一個你的剖析器不靠加法就驗證過的偏移量上
位元組範圍呼叫與檔案、串流、原始指標和按需載入並列在同一個 TPdf 元件裡。PDFium Component 產品頁面 列出了支援的 Delphi 與 C++Builder 版本、授權選項,以及載入 API 的其餘部分