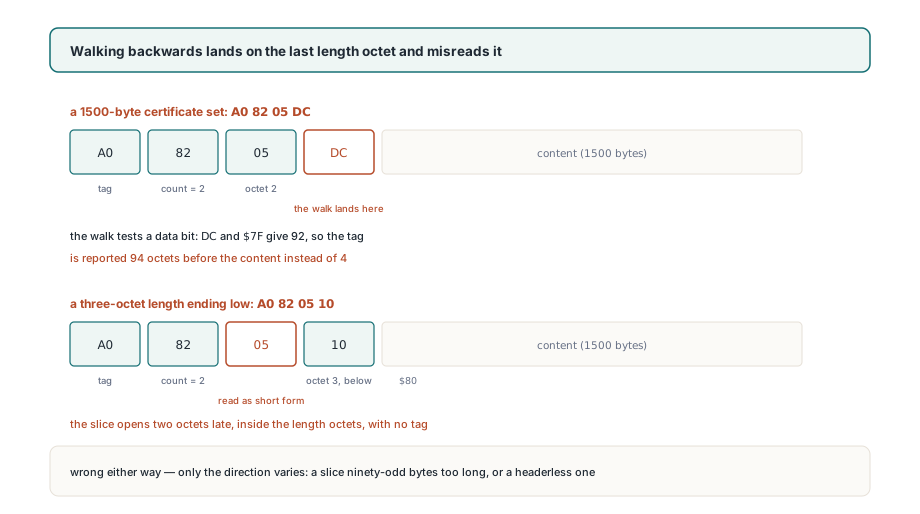
四個位元組 A0 82 05 DC 開啟一個承載 1500 位元組內容的 context-specific [0] 元素。從左往右讀毫無歧義:tag A0、宣告後面還有兩個位元組的起始長度位元組 82,然後是 05 DC。從右往左、從第一個內容位元組起讀,遇到的第一個位元組是 DC。它的最高位元是 1,低七位說 92,於是相信它的輔助函式回報 tag 在內容之前 94 位元組。真實距離是 4
沒有人故意倒著走。事情會發生,是因為多數 DER 讀取器交回的是每個元素的內容偏移與長度——往深處走正好夠用,而原樣複製一個同層元素需要的是它 tag 的偏移。從內容偏移往前減看似兩行程式碼的事,而且只要每個長度都裝得進單一位元組,它就一直保持正確。真實憑證集合的長度從來裝不進一個
簽章時間戳記對已簽署 CMS 做了什麼
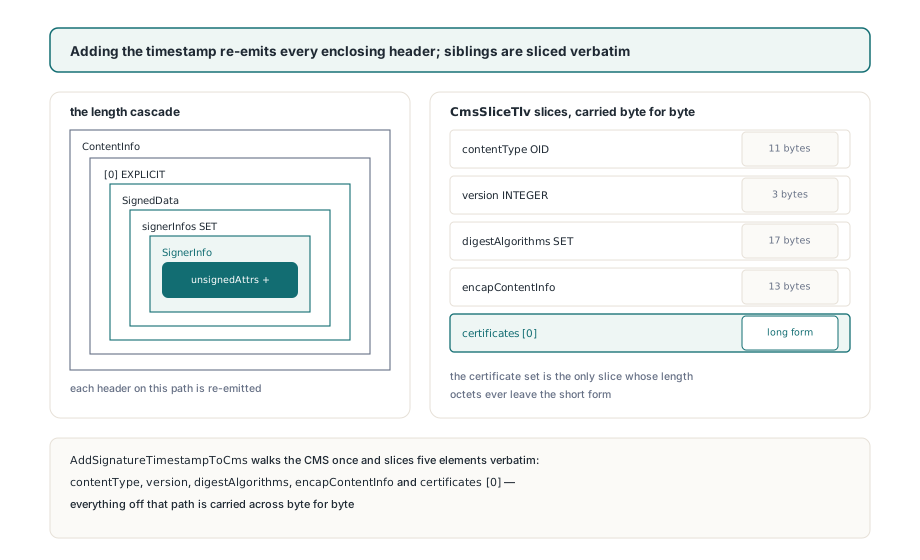
加上 PAdES B-T 時間戳記,會強迫 CMS 的每一層外層標頭重新編碼,同時五個同層元素必須逐位元組原樣帶過。ETSI EN 319 122-1 第 5.3 節在 OID 1.2.840.113549.1.9.16.2.14 下定義的簽章時間戳記屬性,住在 RFC 5652 第 5.3 節的 SignerInfo 的 unsignedAttrs 裡,其內的 RFC 3161 權杖是對簽章值計算的。所以權杖從 TSA 抵達時,CMS 已經建好、也已經簽好。多出的一個屬性拉長 SignerInfo,繼而拉長 signerInfos SET,然後 SignedData、[0] EXPLICIT 包裝,最後是外層 ContentInfo
在 PDFium Component 裡,這一串是 FPdfCms.pas 與 FPdfTsa.pas 裡的三個匯出呼叫。TPadesSignOptions.Level 是 plB_T 以上且設了 TsaUrl 時,SignPadesBytes 會替你跑完它們;要求 B-T 層級卻給了空 TsaUrl 時,它丟出 EPadesCrypto,而不是默默寫出普通 B-B 簽章。若你用 BuildSignedData 自己建 CMS,這條鏈長這樣
// CmsDer holds the ContentInfo returned by BuildSignedData.
// Options.Level >= plB_T 時,SignPadesBytes 會代跑同樣三步
var
  SigValue: TBytes;
  Ts: TPadesTimestamp;
begin
  if not ExtractSignatureValue(CmsDer, SigValue) then
    raise Exception.Create('CMS carries no signature value');
  // TSA 的 messageImprint 對簽章值位元組計算
  Ts:= RequestTimestamp(TsaUrl, SigValue, Nonce);
  // 從 SignerInfo 重新編碼到 ContentInfo,同層元素原樣複製
  AddSignatureTimestampToCms(CmsDer, Ts.TokenDer);
end;
AddSignatureTimestampToCms 原樣帶過五個元素:contentType OID、SignedData 版本 INTEGER、digestAlgorithms SET、encapContentInfo SEQUENCE,以及存在時的 certificates [0] 集合。在 BuildSignedData 以 SHA-256 產出的 CMS 裡,其中四個都很小:OID 11 位元組、版本 3 位元組、摘要演算法集合 17 位元組、分離式 encapContentInfo 13 位元組。憑證集合裝著簽署者憑證加上你傳入的每一張鏈上憑證,一張真實的 X.509 憑證長達數百位元組。這是唯一一個長度位元組必定使用長格式的切片
為什麼 DER 的長度位元組不能倒退走?
長度位元組的個數記在第一個長度位元組裡,倒退走訪先遇到的是最後一個。X.690 第 8.1.3.4 節定義短格式:一個位元組,bit 8 為 0,bit 7 到 1 放 0 到 127 的長度。第 8.1.3.5 節定義長格式。它的起始位元組 bit 8 為 1,bit 7 到 1 數的是後面裝長度的位元組個數,長度本身是無號 big-endian 整數。沒有任何標記指出某個位元組是後續位元組,它的 bit 8 與其他七位一樣是數量位。所以測 Buf[ContentOffs- 1] 最高位元的輔助函式,是在測資料,再把資料當個數讀
// The tempting helper, given only the content offset. Do not ship this
function NaiveHeaderStart(const Buf: TBytes; ContentOffs: Integer): Integer;
var
  P, LenByte: Integer;
begin
  P:= ContentOffs- 1;            // 落在最後一個長度位元組上
  if P< 0 then
    Exit(ContentOffs);
  LenByte:= Buf[P];
  if (LenByte and $80)= 0 then   // 只對第一個位元組有意義
    Result:= P- 1
  else
    Result:= P- (LenByte and $7F)- 1;
end;

// A0 82 05 DC(1500 位元組):Buf[ContentOffs- 1]= $DC,$DC and $7F= 92
//   Result= ContentOffs- 94,tag 其實在 ContentOffs- 4
// A0 82 05 10(1296 位元組):$10 的 bit 8 為 0,被讀成短格式
//   Result= ContentOffs- 2, which points at 05 inside the length octets
兩個失敗方向都出現在平常的尺寸上。1500 位元組的憑證集合標頭以 DC 收尾,輔助函式把切片起點提早了 90 位元組。1296 位元組的集合以 10 收尾,輔助函式把它當成短格式長度,切片晚開兩個位元組、根本沒對到 tag。某條鏈落在第一種還是第二種情況,只取決於總長度的低位元組
提早的那種情況還能跑出緩衝區前端。按 BuildSignedData 的排布方式、每層外層長度都佔兩個位元組時,憑證集合的內容從第 60 位元組開始:ContentInfo 標頭 4、OID 11、[0] 與 SignedData 標頭各 4,然後小的同層元素 3、17、13,再加憑證集合標頭 4。從 60 減 94,輔助函式回傳 -34。它唯一的防護設在 ContentOffs- 1 上,負值就這樣直接進了複製
X.690 第 10.1 節釘死了什麼
DER 把長度編碼變成長度的純函數。X.690 第 10.1 節限制 DER 只能用定長形式,並要求最少位元組數,這拿掉了 BER 的兩個自由:不定長形式,以及用前導零位元組填充的長格式長度。在這條規則下,低於 128 的內容長度必定恰好一個長度位元組;其他長度則是一個起始位元組,加上恰好與該值有效位元組數相同的後續位元組數。128 得到 81 80;256 時標頭長成 82 01 00;65536 需要 83 01 00 00。手裡已經有內容長度的程式碼,不必讀緩衝區任何一個位元組就能算出標頭大小
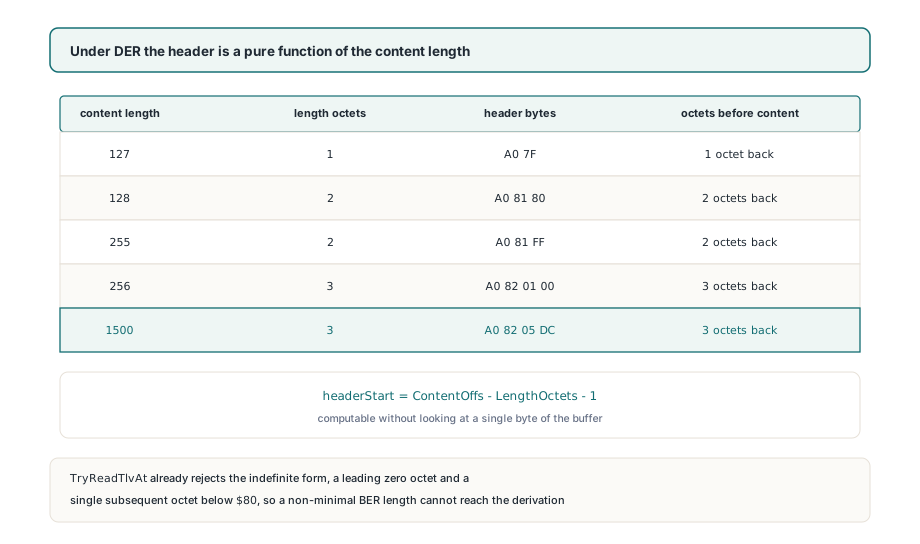
推導的好壞取決於輸入真的是 DER 這個宣稱。TDerReader.TryReadTlvAt 在任何切片發生之前就強制這個宣稱:它拒絕 $80 的起始長度位元組(不定長形式)、第一個後續位元組為零的長格式長度、低於 $80 而本該用短格式的單一後續位元組,以及超過四個的後續位元組。ReadTlv 建立在 TryReadTlvAt 之上,所以 AddSignatureTimestampToCms 走訪的每個元素都已通過那些檢查。BER 式填充長度永遠到不了那段算術
AddSignatureTimestampToCms 內部,每個同層元素的 tag 偏移都用這個方式從其內容偏移與內容長度推導。推導出的起點落在緩衝區開頭之前——意即兩個偏移不可能同屬一體——時,程序丟出訊息為 CMS: TLV header precedes the buffer start 的例外,完全不產出 CMS。一份仍能解析的畸形重建,遠比偏移失和當下的例外難追
推導還帶一個假設:識別碼只佔一個位元組。X.690 允許 tag 號碼 31 以上使用多位元組識別碼,TryReadTlvAt 也會解析它們。CMS SignedData 從不使用,因為它的 tag 是 universal 的 SEQUENCE、SET、INTEGER 與 OID,加上 context-specific 的 [0] 與 [1],所以這個假設對時間戳記重建碰到的每個元素都成立
在自己的 DER 程式碼裡複製同層元素
若你對著 TDerReader 寫程式碼,乾脆跳過推導。PeekTlv 與 ReadNextTlv 填一份 TDerTlv 記錄,其 Offset 本來就指向 tag,其 HeaderLength 是實測的 tag 加長度位元組大小,EncodedBytes 則回傳從 Offset 到 NextOffset 的整個元素。這條路還能應付多位元組識別碼,那是任何長度算術都救不回來的。四個 out 參數的 ReadTlv 往深處走時很方便,但它只回報內容那一側,需要內容時用它,需要整個元素時用記錄形式
// Every child of SignedData as a complete TLV: tag, length octets, content.
// TDerTlv.Offset 指向 tag,完全不涉及標頭算術
function SignedDataChildren(const CmsDer: TBytes): TDerByteArrays;
var
  Root, Ci, Explicit0, Sd: TDerReader;
  Tlv: TDerTlv;
begin
  Result:= nil;
  Root.Initialize(CmsDer);
  if not Root.ReadNextTlv(Tlv) or not Root.EnterConstructed(Tlv, Ci) then
    raise Exception.Create('ContentInfo SEQUENCE expected');
  if not Ci.SkipTlv then                            // contentType OID
    raise Exception.Create('contentType OID expected');
  if not Ci.ReadNextTlv(Tlv) or not Ci.EnterConstructed(Tlv, Explicit0) then
    raise Exception.Create('[0] EXPLICIT content expected');
  if not Explicit0.ReadNextTlv(Tlv) or not Explicit0.EnterConstructed(Tlv, Sd) then
    raise Exception.Create('SignedData SEQUENCE expected');
  while not Sd.AtEnd do
  begin
    if not Sd.ReadNextTlv(Tlv) then
      raise Exception.Create('SignedData child malformed');
    SetLength(Result, Length(Result)+ 1);
    Result[High(Result)]:= Sd.EncodedBytes(Tlv);   // 例如 A0 82 05 DC ...
  end;
end;
其他 API 只給你內容偏移與長度時,正向推導很短。DerHeaderStart(下一節連同其邊界檢查一起展示)是你自己的程式碼;它鏡像第 10.1 節的規則,對不可能一致的偏移回傳 -1,呼叫端於是拿到一個可以拒絕的值,而不是一個看起來合理的起始位元組
為什麼短的測試憑證藏住了錯誤?
小的佔位憑證讓憑證集合停在短格式,而倒退走訪恰好對這種情況正確。32 位元組的集合編成 A0 20,64 位元組的編成 A0 40。從內容往回走落在那個唯一的長度位元組上,它的最高位元是 0,因為它既是第一個也是唯一一個。答案正確,理由錯誤。用這麼小的憑證搭出來的時間戳記測試,可以重新解析結果、找到屬性、回報 B-T,卻從來沒讓一個真實尺寸的憑證集合通過那道切片
任何依賴長度編碼方式的程式碼路徑,都需要跨過編碼邊界的測試輸入。對 DER 來說,就是 128 位元組以上的內容(逼出長格式),以及 256 位元組以上的內容(逼出第二個後續位元組)。下面的檢查在兩處邊界加上開場那個 1500 位元組案例上,把 DerHeaderStart 與讀取器解析時量到的標頭相比。未排序的 signedAttrs SET OF 能溜過同源往返測試,也是同一個結構性原因:測試只餵了錯誤程式碼與正確程式碼答案一致的輸入
// Your own helper for APIs that report only content offset and length.
// 假設識別碼只佔一個位元組,對 CMS SignedData 裡的每個 tag 都成立
function DerHeaderStart(ContentOffs, ContentLen: Integer): Integer;
var
  LengthOctets, Remaining: Integer;
begin
  LengthOctets:= 1;                  // 短格式,X.690 8.1.3.4
  if ContentLen>= 128 then
  begin
    Remaining:= ContentLen;          // 長格式,X.690 8.1.3.5
    while Remaining> 0 do
    begin
      Inc(LengthOctets);             // 每個有效位元組一個
      Remaining:= Remaining shr 8;
    end;
  end;
  Result:= ContentOffs- LengthOctets- 1;
  if Result< 0 then
    Result:= -1;                     // 偏移不一致:讓呼叫端自己 raise
end;

// 邊界檢查,寫成你自己的測試程式碼:推導出的 tag 偏移
// 必須等於 TDerReader 解析標頭時量到的偏移
procedure CheckHeaderDerivation;
const
  Lens: array[0..6] of Integer= (127, 128, 255, 256, 1500, 65535, 65536);
var
  W: TDerWriter;
  R: TDerReader;
  Tlv: TDerTlv;
  Content: TBytes;
  I: Integer;
begin
  W:= TDerWriter.Create;
  try
    for I:= Low(Lens) to High(Lens) do
    begin
      SetLength(Content, Lens[I]);
      R.Initialize(W.Wrap($A0, Content));   // A0 7F / A0 81 80 / A0 82 05 DC ...
      W.Clear;
      if not R.PeekTlv(Tlv) then
        raise Exception.CreateFmt('unreadable TLV for %d bytes', [Lens[I]]);
      if DerHeaderStart(Tlv.ContentOffset, Tlv.ContentLength)<> Tlv.Offset then
        raise Exception.CreateFmt('header start wrong for %d bytes', [Lens[I]]);
    end;
  finally
    W.Free;
  end;
end;
同一個邊界經匯出函式可以端到端走到。給 BuildSignedData 鏈上憑證,讓組合尺寸把憑證集合推到剛好低於與高於 128 與 256 位元組,對每個結果跑 AddSignatureTimestampToCms,再用 SignedDataChildren 走訪輸出,逐位元組比較憑證集合元素與加時間戳記前 CMS 裡的那一份
AddSignatureTimestampToCms 接受什麼
AddSignatureTimestampToCms 是為 BuildSignedData 產出的 CMS 寫的:一個 SignerInfo、可選的 certificates [0] 集合、沒有 crls [1]、也還沒有 unsignedAttrs。餵它一個裝著超過一個 SignerInfo 的 signerInfos SET,它丟例外,而不是留下第一個簽署者、丟掉其餘。帶 crls [1] 集合的 CMS 會停在 CMS: signerInfos SET expected 例外,因為憑證之後的元素不是走訪要找的那個 SET。兩種拒絕都發生在任何東西寫回 CmsDer 之前
新的 unsignedAttrs 恰好裝一個屬性,所以不必排序就滿足 X.690 第 11.6 節的 SET OF 排序規則。SignerInfo 的簽署部分——從版本到簽章 OCTET STRING——整塊複製,這意味著重新摘要 signedAttrs 的驗證器在加入權杖前後看到相同位元組。驗證器還是把文件打回票時,原因通常在別處,PAdES 拒簽原因檢查清單有涵蓋。權杖隨時間帶來什麼、B-LT 與 B-LTA 如何疊在其上,請看RFC 3161 時間戳記與 DSS 的逐步解說
FPdfAsn1.pas 裡的 DER 讀取器與寫出器、FPdfCms.pas 裡的 CMS 建構器與時間戳記步驟,都是隨 PDFium Component for Delphi 附上的 Pascal 原始碼。重建的 SignedData 在驗證器裡解析不過時,你可以單步走進切出每個元素的那段程式碼,對照它引用的 X.690 條文檢查