同一份發票 PDF 在 Windows 與手機上開啟,斷行、字型與標誌落在相同的位置。PDF 檔案是一組編號物件外加一份位元組偏移索引,PDFium Component 內的 PDFium 引擎這類閱讀器從檔尾開起:startxref、xref 表、catalog、頁面樹、content stream,然後是像素
所以 PDF 檔案是什麼,為什麼到處看起來都一樣?Word 與 RTF 文件存文字與樣式,版面交給開啟它的那台機器,缺一個字型或換個印表機驅動程式,頁面就重排。PDF 存的是成品。每個字形與每一行在以點為單位的座標空間裡都有絕對位置,字型程式隨檔案旅行,影像自帶色彩資料與壓縮 filter。檢視時沒有任何東西在排版,所以任何作業系統上任何合規的渲染器都畫出同一頁。這個格式以 PDF 1.0 與 Acrobat 於 1993 年問世,建在 PostScript 成像模型上,每個修訂版加入下述機制的一部分:
- PDF 1.1 到 1.4 帶來加密、互動式表單、帶邏輯結構的數位簽章,與透明度
- PDF 1.5 加入物件串流與交叉引用串流;PDF 1.6 加入 AES 加密
- PDF 1.7 成為 ISO 32000-1:2008,PDF 2.0 成為 ISO 32000-2:2017,2020 年修訂
- PDF/A(ISO 19005)、PDF/X(ISO 15930)與 PDF/UA(ISO 14289)為典藏、印刷生產與無障礙對這個基礎設限
閱讀器開啟 PDF 檔案時發生什麼事?
開啟 PDF 是一條查找鏈,從檔案最後幾個位元組開始、以一張點陣圖結束。鏈上幾乎每一環都是字典——ISO 32000-1 §7.3 的基本物件型別之一——字典之間用 7 0 R(物件 7、世代 0)這類間接引用互相指向。檔案的行為因此像一張物件圖,而不是一串頁面。標頭、主體、交叉引用表與 trailer 的版面見PDF 檔案結構總覽,逐行標註的最小 PDF展示 obj、endobj 與 stream 在文字編輯器裡的樣子。每個閱讀器都照下面的順序走
- seek 到檔案結尾,讀
startxref關鍵字之後寫著的位元組偏移 - 載入該偏移上的交叉引用資料,它把每個物件編號映射到檔案裡的位置
- 讀 trailer,沿
/Root到文件 catalog - 沿 catalog 的
/Pages條目走下頁面樹,到所要求的頁面物件 - 解碼頁面的 content stream,按順序解讀其運算子
- 經
/Resources解析那些運算子指名的字型、影像與 form XObject - 在裝置解析度下把路徑、字形外框與影像點陣化成像素
第一步:startxref 與交叉引用表
閱讀器從不從檔案頂端掃描。格式良好的檔案以 startxref 關鍵字、一個 48211 這樣的十進位數、與 %%EOF 收尾,那個數字是交叉引用資料的位元組偏移。對 xref 做天真的反向搜尋會停在 startxref 裡面,所以要搜完整關鍵字。經典表用定寬條目(§7.5.4),閱讀器因此能跳到任何物件編號的條目、不必解析其他條目;每個條目的位元組版面在結構總覽裡交代。表後的 trailer 指名 /Size、/Root,選配 /Encrypt、/ID 與 /Prev
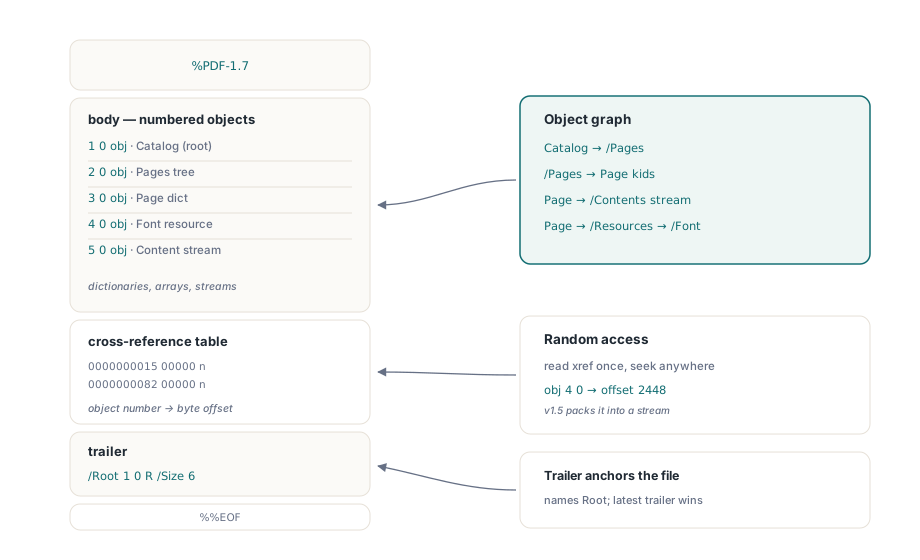
每個條目都是絕對位元組位置,任何移動位元組的東西——例如改寫行尾的編輯器——都讓索引指到錯的地方。帶修復流程的閱讀器掃描 obj 關鍵字重建它;沒有的拒收檔案,這就是受損 PDF 能在一個檢視器開啟、卻在另一個失敗的原因。startxref 偏移上坐著什麼,告訴你眼下是哪一種:經典表是 xref 關鍵字,PDF 1.5 交叉引用串流是 N 0 obj 檔頭,過期偏移則是其他任何東西。下面的輔助函式是你自己的程式碼,建在平實的 RTL 串流上
uses
  System.SysUtils, System.Classes;

// 你自己的輔助函式:Offset 是 startxref 之後寫著的數字。
// 分類閱讀器在那個位置會找到什麼
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
交叉引用串流(§7.5.8)是帶 /Type /XRef 的壓縮物件,/W 陣列給每欄的位元組寬度,二進位列指向位元組偏移或物件串流(§7.5.7)內部。trailer 的鍵搬進它的字典,檔案裡完全沒有 trailer 關鍵字。THotPDF 設了 UseXRefStream 時 HotPDF 寫這種形式。離開你掌控的檔案——郵件附件、印刷廠上傳之類——經典表仍是更安全的選擇,因為早於 PDF 1.5 的閱讀器照樣解析得了它。PDF/A-1 為典藏定了案:ISO 19005-1 建在 PDF 1.4 上,其 §6.1.4 明文不得使用交叉引用串流,所以 PDF/A-1 profile 作用時 HotPDF 一律寫經典表
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
從 /Root 到正確的頁面:catalog 與頁面樹
trailer 的 /Root 指向文件 catalog,catalog 的 /Pages 指向頁面樹的根。每個中間 /Pages 節點帶著其下葉子頁面的 /Count,找第 5,000 頁的閱讀器往下走時逐層減去計數、整棵子樹不開就跳過。ISO 32000-1 §7.7.3 不要求樹平衡;單一個 10,000 條目的 /Kids 陣列合法,只是搜尋慢。只讀葉子的程式碼會掉進一個陷阱。/Resources、/MediaBox、/CropBox 與 /Rotate 是可繼承的(§7.7.3.4),沒有自己 /MediaBox 的頁面仍然有效,因為值住在某個祖先身上
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
媒體框為頁面上畫的一切設定座標空間:原點在左下、Y 向上,一單位等於 1/72 吋,除非 PDF 1.6 的 /UserUnit 把它縮放。按頁碼要一頁時,PDFium Component 走完整趟下降。TPdf.PageMetrics 回傳以點為單位的頁面尺寸,繼承的框已經解析好,附帶頁面旋轉,所以下面的清單對葉子頁面不帶自己框的檔案也回報正確尺寸
uses
  System.SysUtils, PDFium;

// 印出頁數與每一頁以點為單位的尺寸
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // 解析 xref 資料、trailer 與 catalog
    if not Pdf.Active then        // 載入失敗讓 Active = False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // 1 起算;經樹載入頁面
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
PDF 怎麼在螢幕上畫出一頁?
頁面的可見內容是一支小程式:一或多條 content stream 裡的後置運算子,在閱讀器跑過 /Filter 指名的解碼器——多半是 /FlateDecode——之後按順序解讀。BT 開啟文字物件,Tf 選字型資源與大小,Td 挪文字位置,Tj 畫出字串,ET 關閉物件。路徑用 m、l、c 與 re 建出,再以 f 填色或以 S 描邊。圖形狀態(§8.4)裝著那些運算子隱含讀取的東西:轉換矩陣、色彩與裁剪路徑。q 推入一份複本、Q 彈出,成對之間設定的轉換因此漏不進後面的內容
q
1 0 0 1 72 700 cm     % 把原點移到 (72, 700)
BT
  /F1 12 Tf           % 字型資源 F1、12 點
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % 描邊色彩,作用域由 q/Q 框住
0 -6 m 140 -6 l S
Q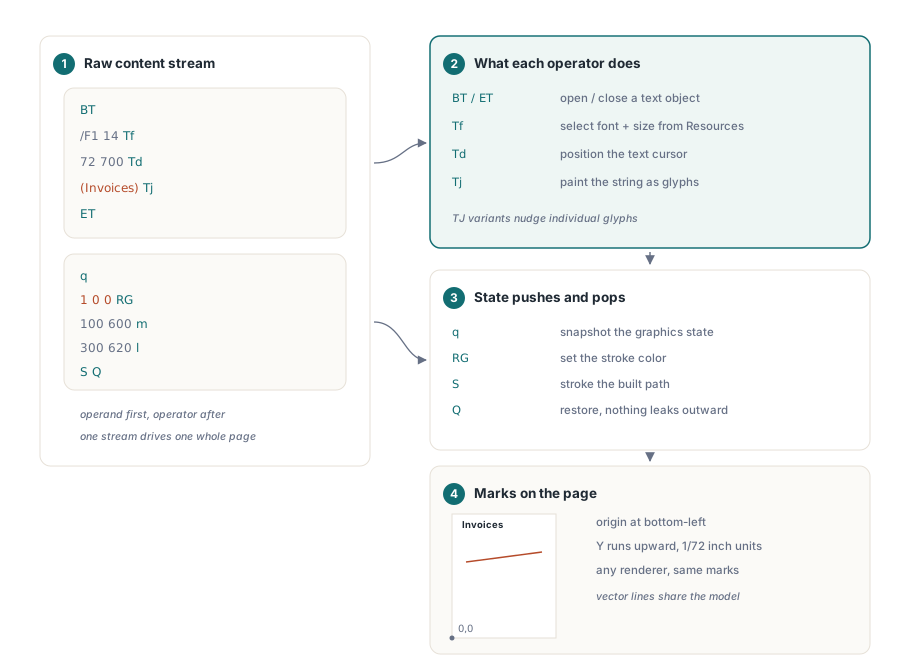
/F1 這類名稱是頁面 /Resources 的鍵。字型字典經它的字型描述器(§9.8)通到內嵌字型程式,影像在其 JPEG 或 Flate 資料解碼後以一次 Do 畫出。點陣化殿後。渲染器把轉換矩陣套上每條路徑與字形外框,把點映射到裝置像素,填出帶抗鋸齒的結果。那個時間點頁面仍是向量資料,放大到 400% 是以更大尺度重跑 content stream,不是拉伸點陣圖。目標解析度由呼叫端挑:螢幕用每吋 96 或 150 像素,印刷用 300 以上。PDFium Component 裡這個階段是 TPdf.RenderPage,收以像素為單位的輸出尺寸
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// 以每吋 Dpi 像素渲染 FileName 第 1 頁,存成 BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // 1 起算
    // PageWidth 與 PageHeight 以點為單位(1/72 吋)
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // 函式形式回傳新點陣圖
    end;
  finally
    Pdf.Free;
  end;
end;
頁面看起來沒問題,複製貼上卻回傳亂碼,為什麼?
檔案記錄了要畫哪個字形、卻沒記錄它代表哪個字元時,複製貼上就失敗。渲染只需要內嵌字型程式裡的字形形狀。擷取需要 Unicode,來自標準編碼或字型字典上的 /ToUnicode CMap(§9.10.3)。/Encoding /Identity-H 的複合字型把原始字形 ID 寫進 content stream,沒有 ToUnicode 映射時,那些 ID 與任何字元之間都沒有定義過的關係。螢幕完美無缺,剪貼簿裝滿符號。子集字型讓這更容易發生,它們只留文件用到的字形,從 /BaseFont /AAAAAA+ArialMT 這類名稱的六字母前綴一眼可辨(§9.6.4)。PDF 字型處理指南深入談 CJK 字型與壞掉的擷取
增量更新與簽章位元組範圍
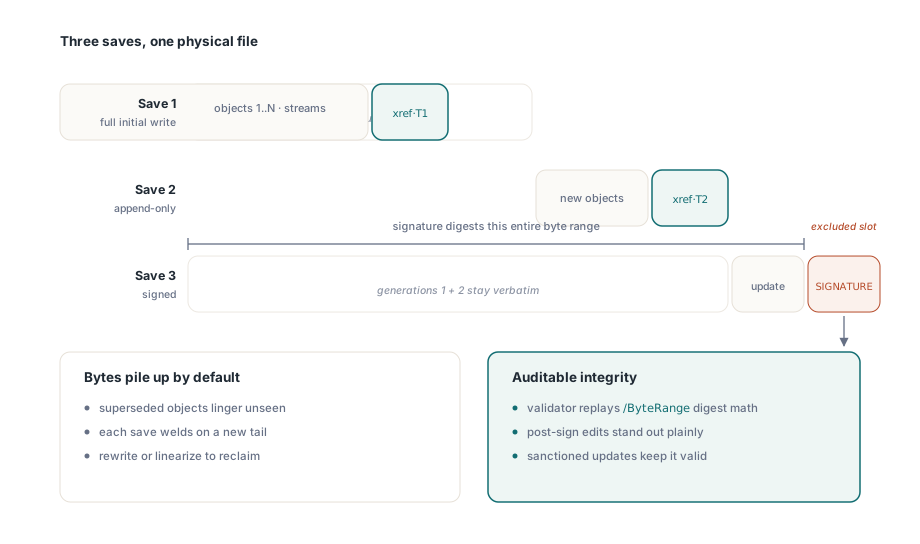
簽章仰賴 PDF 只增不改的編輯方式:增量更新(§7.5.6)在最後一個 %%EOF 之後加入物件與一份新的交叉引用段,結構總覽解釋了 /Prev 鏈與被刪內容為何仍在較早修訂裡存活。簽章字典的 /ByteRange 寫成 [0 a b c],對除了裝 CMS 簽章的 /Contents 十六進位字串之外的一切取雜湊,所以被簽修訂結束在位元組 b + c,驗證器把檔案截到那裡重建它。更晚的修訂落在那個點之後;完整重寫、線性化器或最佳化處理則移動簽署者雜湊過的位元組,一次作廢所有既有簽章
Delphi 或 Lazarus 應用程式需要這整條管線時——從解析交叉引用資料、走訪頁面樹,到渲染與文字擷取——PDFium Component for Delphi and Lazarus 把它包進上面清單使用的 TPdf 文件元件,以及螢幕顯示用的 TPdfView 檢視器控制項