從 40 頁的 PDF 中複製 3 頁需要花費 2 分鐘,這並非效能調校問題;這是一個訊號,表示使用了錯誤的 API 路徑;當我第一次在基於 HotPDF Delphi Component 的頁面複製程式碼上看到這個時間花費時,我的直覺是先查看文件結構,其次才是程式碼;事實證明,這個順序恰恰搞反了
實際上慢在哪裡
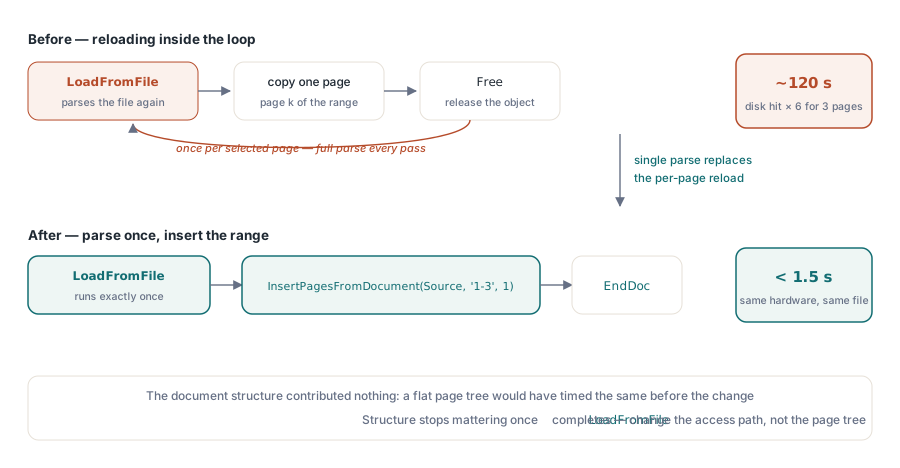
有問題的 PDF 是一份 40 頁的參考文件,具有非比尋常的頁面樹:有多個中間的 /Pages 節點,而不是單一的扁平陣列;出問題的程式碼呼叫了 LoadFromFile,然後使用 BeginDoc 建置新文件、在選定的頁碼上進行迴圈,並在每次反覆運算時再次從磁碟載入來源文件以提取頁面;這相當於將完整的解析成本乘以您需要的頁面數量;一個 12 MB 的檔案在擷取 3 頁時讀取了磁碟 6 次,因為沒有人注意到該檔案是否需要在多次反覆運算之間保持開啟狀態
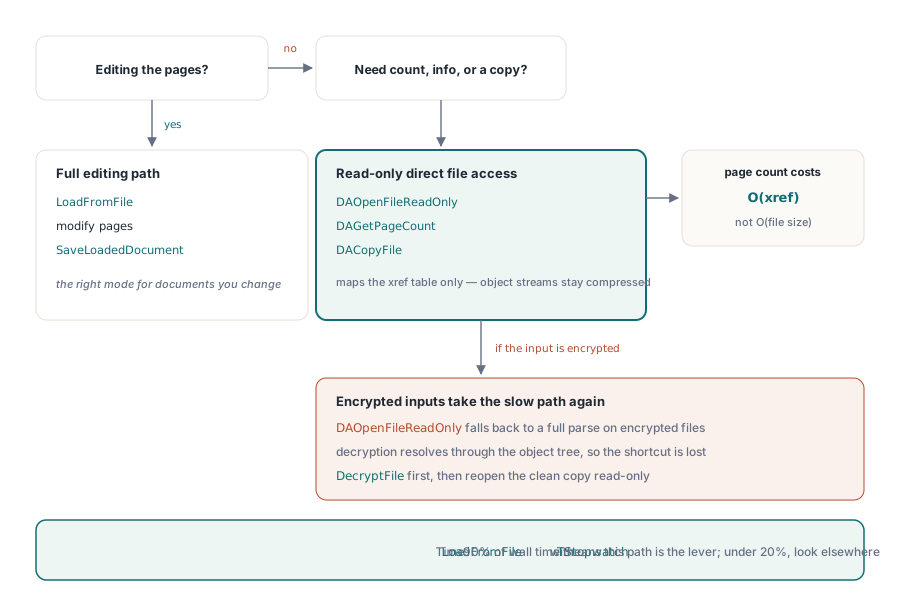
第二個原因在程式碼中是看不見的:HotPDF 的 LoadFromFile 會建構出編輯 API 所運作的記憶體內物件模型;對於您即將修改的文件,這是正確的行為,但如果您只需要頁數和頁面子集,這會做超出您需要的功;對於結構的唯讀存取,DAOpenFileReadOnly 可以避免還原序列化整個物件樹,這對於具有大型影像資源的壓縮檔案非常重要
兩者歸結為同一件事:拿了為某個工作設計的 API,卻把它用在另一個工作上
使用 ExtractPagesToFile 進行頁面擷取
把一段頁面範圍從已載入的 HotPDF 文件複製成一個新檔案的正確路徑,是在來源 LoadFromFile 之後呼叫 ExtractPagesToFile。您只載入來源一次,這個呼叫會建好目標文件、把選取的頁面複製進去、然後寫入磁碟——全部都基於已在記憶體中的那份副本:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // 只載入來源一次:完整解析只在此處發生
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // 把要求的範圍('1-3'、'1,5,7-9')直接寫入新檔案
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
PageRange 參數接受與命令列範例相同的格式:以逗號分隔的頁碼或範圍清單,例如 '1-3' 或 '1,5,7-9';頁面是以 1 為基底的;ExtractPagesToFile 會把每個選取的頁面連同它參考到的內容串流與資源一併複製,因此從 40 頁文件中擷取 3 頁時,工作集依然很小
在先前執行需要 2 分鐘的同一個 12 MB 檔案上進行計時:使用此模式約為 1.3 秒;大部分的時間是花在單一的 LoadFromFile 呼叫上;一旦第一次解析了物件表,文件結構就變得無關緊要了
當 LoadFromFile 負擔過重時:Direct File API
如果您只需要計算頁數、檢查文件資訊或在不接觸內容的情況下複製檔案,Direct File API 可以完全避免完整的解析;DAOpenFileReadOnly 對應交叉引用表而不需要解壓縮物件資料流,因此頁數計算是 O(xref 大小) 而不是 O(檔案大小):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile 是保留位元組的複製,不會重新序列化
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;注意事項:DAOpenFileReadOnly 接受密碼參數,但對於加密的輸入會退回到完整解析,因為解密需要物件樹來解析加密字典;如果您的來源檔案已加密,請先使用 DecryptFile 對其進行解密以取得未加密的複本,然後使用 Direct File API 開啟它;檔案層級的 DecryptFile 函式對標準加密採用直接 AES-256 重寫路徑,對於大型檔案來說,比 LoadFromFile 緊接在後呼叫 SaveLoadedDocument 還要快,因為它不會建置完整的記憶體內物件模型
大批次處理期間的記憶體
在迴圈中處理數十個檔案的批次工作具有一個看起來正確但會累積記憶體的模式:在迴圈內建立 THotPDF、呼叫 LoadFromFile、執行工作、呼叫 Free;這在結構上是沒有問題的;問題在於,當內部工作配置暫存物件、擷取異常,並使這些暫存物件在錯誤路徑上保持存活時;Delphi 的記憶體管理員不會進行壓縮,因此批次執行中上百次的錯誤路徑洩漏可能會將記憶體推得足夠高,從而減慢所有其他配置的速度
解決方法原不奇特;參與 PDF工作的每個 THotPDF 以及每個中間 TStream 或 TBitmap 都屬於 try/finally 區塊,其中 Free 是最後一個陳述式;在 try 之前將本端指標設定為 nil,以便在初始化途中失敗時,finally 分支可以安全地使用 if Assigned(x) then x.Free;這是標準的 Delphi 所有權規範,也是此類問題的完整解決方案
在批次上下文中還有一件事要知道:AddImage 會把每張圖片註冊到正在建置的文件上,而當 EndDoc 完成該檔案時,HotPDF 會釋放這些註冊。註冊表跟隨 BeginDoc/EndDoc 循環,而不是 LoadFromFile,所以批次的乾淨模式是每份文件一個 THotPDF 實例:建立它、做完工作、存檔、釋放它
在變更任何內容之前進行測量
在採用任何這些模式之前,請先測量;來自 System.Diagnostics 的 Delphi TStopwatch 封裝了 QueryPerformanceCounter,且對於檔案 I/O 的實際時間分析足夠精確;單獨封裝 LoadFromFile 並查看它佔用了多少時間;如果它佔總時間的 90%,則解決方法是 Direct File API 或減少解析同一個檔案的次數;如果低於 20%,則瓶頸在其他地方,您追錯了方向
本篇貼文開始時提到的 2 分鐘擷取,最後證實完全是重複載入模式所致;文件結構沒有任何影響;扁平的頁面樹也會以同樣的方式執行;切換到單一的 LoadFromFile 緊接著一次 ExtractPagesToFile 呼叫,在相同的硬體上把它縮到約 1.3 秒,而無需變更其他任何內容
此處顯示的頁面操作 API 是適用於 Delphi 和 C++Builder 的 HotPDF Delphi Component 的一部分