Excel 會在一份 LibreOffice 與各種自製讀取器都開得好好的 XLSX 上跳出「我們發現部分內容有問題」,因為 Excel 強制執行那些讀取器視而不見的兩件事:schema 標為必填的屬性,以及 Open Packaging Conventions 的唯一性規則。在任何「把產生的部件與保留的部件混在一起寫」的寫入器裡,有三條規則特別容易踩雷:<phoneticPr> 需要它的 fontId;每個部件名稱在 [Content_Types].xml 裡恰好只能有一個 Override;而兩條根層級關聯絕不能共用 rId4 這樣的識別碼。本文逐一走過這三條,以及 HotXLS——給 Delphi 與 C++Builder 的原生 Excel 試算表元件——如何寫套件以滿足它們
為什麼其他讀取器都接受的套件,Excel 卻拒收?
因為那個修復提示是一道 schema 與套件驗證器,不是剖析失敗。一份活頁簿可以在自己的函式庫、LibreOffice 與 XML 驗證器之間來回 round trip,而且在XLSX OPC 關聯解析一文所用的那種 OPC 意義上結構健全:每個部件都 reachable、每個目標都可解析。在一個關掉 DisplayAlerts 的隔離 COM 執行個體裡用 Workbooks.Open 開它,呼叫仍可能直接失敗。互動模式下同一份檔案則產生熟悉的修復對話框,而修復記錄——Excel 肯寫的時候——只報部件名,不報規則。好幾個互不相干的違規可以躲在那一個提示背後,Excel 不會一條一條報;它拒收活頁簿,把尋找與分析的工留給你。接下來是每一條規則、違反它的自然方式,以及 HotXLS 改成怎麼寫套件——因為每一條都是任何 Delphi XLSX 寫入器都可能絆倒的規則
規則 1:phoneticPr 的 fontId 是必填,即使是零
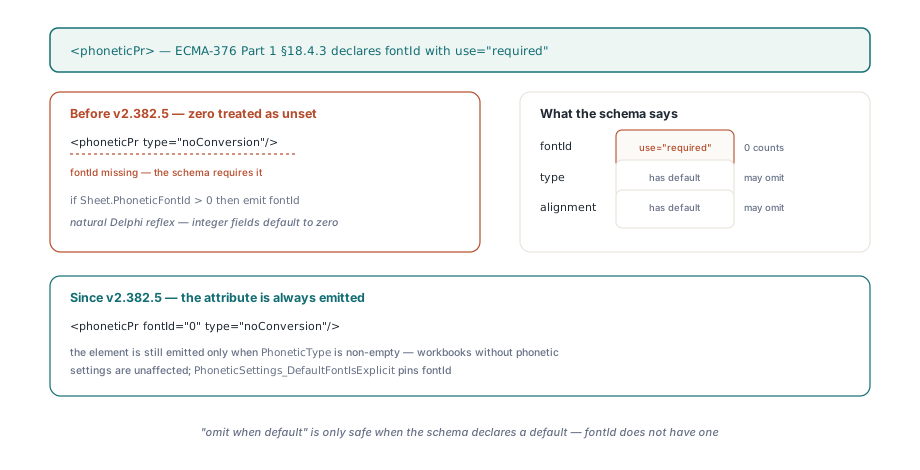
<phoneticPr> 元素帶著一個 fontId 屬性,在 ECMA-376 Part 1 §18.4.3 裡宣告為 use="required",而值為 0 是合法的字型索引,不是「沒有」。把零當成「未設定」、只在 Sheet.PhoneticFontId > 0 時才輸出該屬性的寫入器,遵循的是一個自然的 Delphi 反射動作——整數欄位預設就是零——但它會對任何「拼音字型恰好是 styles.xml 裡第一個字型」的活頁簿產出 <phoneticPr type="noConversion"/>;這很容易命中,因為索引 0 就是第一個字型。然後 Excel 在讀回時,拒收了一個它自己寫出去的值
// 自然反射:零當成未設定,fontId 被丟掉
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas,工作表寫入器——屬性為必填,零也要寫
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS 只在 TXLSXWorksheet.PhoneticType 非空時才輸出這個元素,所以從來沒帶拼音設定的活頁簿不受影響。在一張全新的工作表上把 PhoneticFontId 設成零、存檔,xl/worksheets/sheet1.xml 就會帶著 <phoneticPr fontId="0"。更廣的教訓:「等於預設值就省略」只有在 schema 宣告了預設值時才安全;同一個元素裡 type 與 alignment 有預設,fontId 沒有
規則 2:[Content_Types].xml 裡每個部件名稱只能有一個 Override
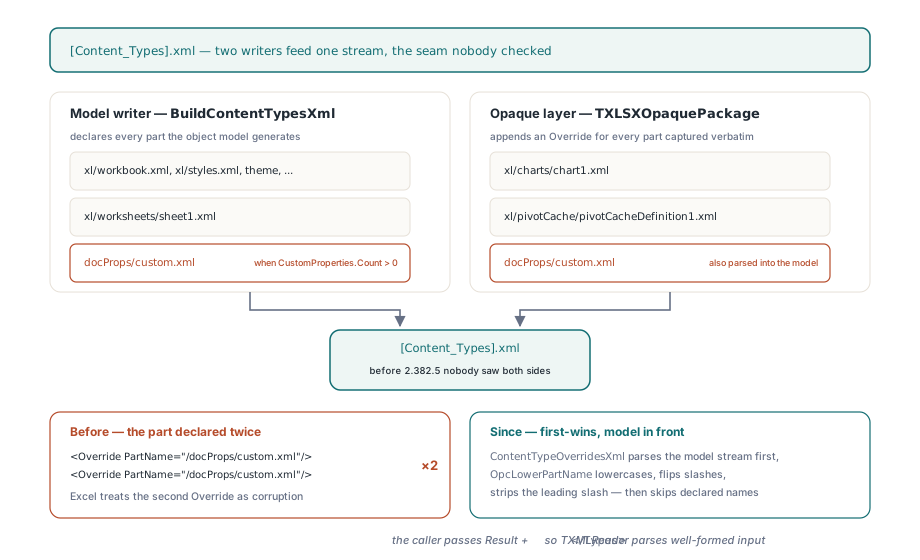
內容類型串流對每個部件名稱最多只能宣告一次,而 Excel 把同一個 PartName 的第二個 Override 當成毀損,即使兩筆帶著相同的 ContentType 也一樣。HotXLS 有兩個寫入器在餵這條串流。BuildContentTypesXml 宣告物件模型產生的每個部件:活頁簿、樣式、共用字串、theme、工作表,以及當 TXLSXWorkbook.CustomProperties.Count > 0 時的 /docProps/custom.xml。開著 PreserveUnsupportedParts 時,TXLSXOpaquePackage 接著為它從來源套件逐字捕獲的每個部件補上一個 Override,讓那些位元組在輸出時仍有宣告。撞在一起的,是兩邊都存在的部件。自訂文件屬性已解析進模型,但來源套件的 docProps/custom.xml 同時被不透明層捕獲,天真的合併就會宣告它兩次;當模型重新產生某個不透明層也保留的部件時,圖表與樞紐快取部件也會落在同一個坑裡。對模型已寫了什麼毫無所見的不透明寫入器無從得知,這正是 ContentTypeOverridesXml 被賦予那份所見的原因
<!-- 天真的合併會產出什麼 -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS 把產生出來的 XML 傳進 ContentTypeOverridesXml,讓不透明寫入器在輸出任何東西之前先剖析它。兩個細節撐起正確性。OpcLowerPartName 在比對前轉小寫、把反斜線換成正斜線、剝掉開頭的斜線,因為 OPC 部件名稱以不分大小寫的方式比較,而模型寫出來的名字帶前導斜線、不透明層存的 ZIP 項目名稱沒有。BuildContentTypesXml 裡的呼叫端則傳入 Result + '</Types>',把建到一半的文件補上收尾,讓 TXMLReader 看到格式完整的輸入而非被截斷的串流。浮現的規則是「模型優先的先寫先贏」:物件模型宣告的永遠是權威版本,不透明重播只負責補缺口
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // 剖析模型產生的串流,收集每一個已宣告的 PartName。
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // 已宣告過,或是 rels 部件
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
規則 3:關聯 Id 在一個關聯部件內必須唯一
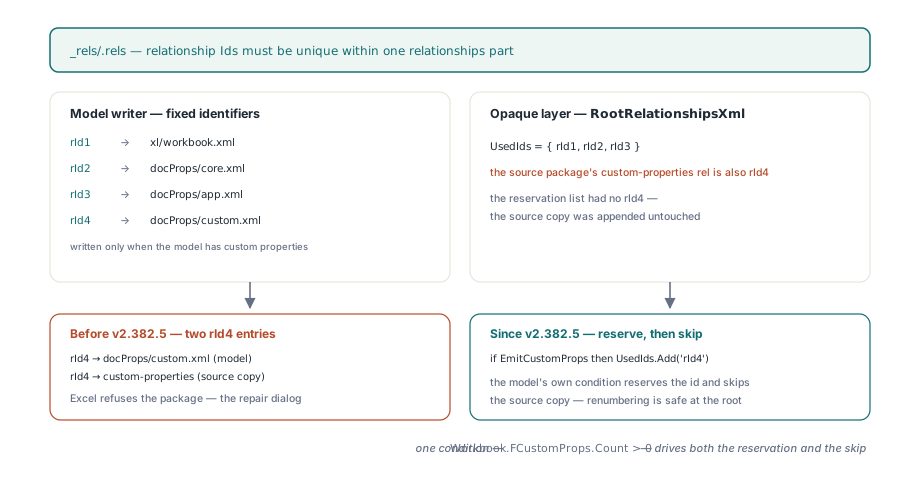
.rels 部件裡的每個 Relationship 都需要一個在該部件內唯一的 Id,兩個共用一個,Excel 就拒收套件。HotXLS 寫套件層級的 _rels/.rels 時用固定識別碼:活頁簿是 rId1,core 與 extended 文件屬性是 rId2 與 rId3,模型有自訂屬性時則是 rId4。不透明套件接著附加它從來源保留的根層級關聯,對任何已在 UsedIds 清單裡的識別碼重新編號。如果那份清單只知道 rId1 到 rId3、不知道模型即將發出自己的自訂屬性關聯,那麼自訂屬性關聯也叫 rId4 的來源套件——Excel 預設就是這麼寫——輸出時就會帶著兩筆指向同一目標的 rId4。RootRelationshipsXml 因此在模型發出自訂屬性時先保留 rId4 並跳過來源副本。呼叫端 BuildRootRelsXml 把 Workbook.FCustomProps.Count > 0 當成第二個引數傳入,讓保留與跳過由「模型是否發出 rId4」的同一個條件驅動。重新編號在套件根層級是安全的,因為活頁簿內部沒有任何東西按名字參照根層級關聯識別碼;同一招往下一層就是錯的——workbook.xml 裡的 r:id 屬性綁定的是活頁簿關聯部件裡的識別碼,這正是 MergeWorkbookRelationshipsXml 另外維護一份識別碼映射的原因
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // 模型寫入器保留的
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // 自訂屬性歸模型所有;不要重播來源副本。
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // 最低的可用 rIdN
  UsedIds.Add(String(Id));
  ...
end;
這三條規則的共同點是什麼?
三條都在防範同一種寫入器:有兩個來源、卻沒有人單獨擁有套件不變式。物件模型產生它懂的部件;不透明層重播它不懂的部件,好讓 round trip 保住圖表、樞紐快取、自訂 XML,以及theme、extLst 與 calcChain 無損往返筆記裡描述的其他一切。兩邊各自都可以自洽。OPC 對整個套件加的約束——唯一的 Override 部件名稱、每個部件唯一的關聯識別碼——只在兩者拼接的接縫上存在,所以必須有人擁有那道接縫。fontId 規則往下一層還是同一個形狀:寫入器可以知道自己想省略什麼,卻從不去查那個說它不能省的 schema。HotXLS 用固定優先序解決這件事,而不是合併啟發式:模型先寫,不透明層看過已寫內容、在任何衝突上讓位。這些不變式從外部檢查也很便宜:讀出存檔套件裡的 [Content_Types].xml 與每個 .rels 項目,遇到任何重複的 PartName、Extension 或 Id 就失敗。這個檢查不需要 Excel,涵蓋兩條唯一性規則;fontId 規則仍需要 schema 驗證器
不是範圍、而是公式的列印區域
列印區域是 Excel 在存回副本上比對的另一件事:一份 _xlnm.Print_Area 被 Excel 回報為 $A$1:$J$29 的範本,round trip 之後必須回報一模一樣的值。背後有兩個陷阱。匯入時,一口氣砍到第一個未加引號 ! 的前綴剝除,會把 OFFSET('Print Data'!$A$1,0,0,2,2) 這種動態列印區域變成 $A$1,0,0,2,2),也讓 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 這種帶限定的聯集只丟掉第一段的前綴。匯出時,把工作表名稱對整串儲存的 PrintArea 只加一次前綴,會讓純聯集 $A$1:$B$2,$D$1:$E$2 第一段帶限定、第二段裸奔——ECMA-376 Part 1 §18.2.5 下 Excel 不接受這種 _xlnm.Print_Area 定義
// 匯入:只有在剩下的東西是單純 sqref 時才剝掉前置詞
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) 原樣回傳,不做處理

// 匯出:每個以逗號分隔的段落都要加限定,否則就全部不加
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // 是一條公式:逐字輸出
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;兩邊的配對規則相同:列印區域只有在每一段都解析成單純範圍時才算單純範圍,否則它就是一條公式、逐字傳遞。有了這條規則,具名基底、帶工作表限定的基底與聯集,都能在反覆的存檔重開循環中存活。列印區域如何與頁面設定及列印模型的其他部分互動,見工作表保護、頁面設定與列印一文
怎麼找出 Excel 到底在抗議哪一條規則?
先假設您自己的驗證器是錯的,因為它放行了。Open XML SDK 的驗證器會指出像缺少 fontId 這樣的 schema 違規,連部件與 XPath 一起報,而它底下的封裝層根本拒絕打開任何帶著重複內容類型項目的套件,所以先跑它,別做別的。當它一聲不吭而 Excel 還是要修復時,就對套件二分:解壓、刪掉一個部件及其關聯與 Override、重壓、重開,每輪把候選集合砍半,直到提示消失。上面三個違規會按那個順序浮現,而且沒有一個會在 Excel 提議存出的修復檔裡現形,因為修復會悄悄丟掉或重新編號那些有問題的條目。HotXLS 寫入器的兩個設計選擇值得知道。去重採「模型優先的先寫先贏」:如果來源套件為某個模型也會產生的部件宣告了不同的內容類型,模型的宣告勝出、來源的丟棄——對 HotXLS 會重新產生的部件這是正確行為,而不是通用合併。而對產生內容類型串流多跑的那一趟 TXMLReader,在開著 PreserveUnsupportedParts 的每次存檔都會執行,相對於一條很少超過幾 KB 的串流,是小成本。這些規則就位後,Win32 與 Win64 兩個建置存出的 4805 條公式貸款範本,在 Excel 裡開啟無提示、重算零差異、列印區域與原檔回報一致
如果您自己要用 Delphi 寫 XLSX,檢查清單很短:schema 標為必填的屬性一律輸出,不管值是什麼;每個部件名稱只宣告一次;而每個關聯部件都要在所有會動到它的寫入器之間共用同一份已用識別碼清單。如果您希望那份清單已經存在、而且是對著 Excel 測過、而不是只對著自己的讀取器測過,本文描述的套件寫入器隨 HotXLS Delphi 試算表元件一起出貨,連同那個讓這道接縫值得守護的不透明部件 round trip