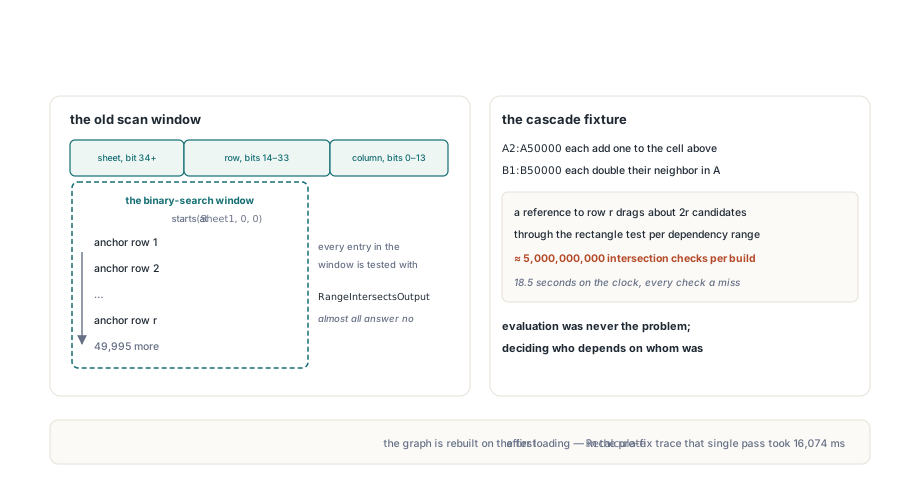
A 欄放 50,000 條公式、每條對上一格加一,B 欄再放 50,000 條、每條把左鄰加倍——試算表模型很難比這更樸素了。求值只花 100,000 次加法和乘法;但如果邊建構器照直覺寫,算出求值順序的成本高出好幾個數量級:從被參照工作表的頂端一路往下搜尋每條公式直到被參照列,逐一測試是否重疊,留下命中的。單這張表就得做約五十億次矩形測試,而幾乎每一次的答案都是否
五十億是算出來的,不是碼錶量出來的。指向第 r 列的參照會把約 2r 個候選拖進搜尋視窗——上方每一列的每一欄各一個——對 100,000 條參照加總,就落到數十億。有意思的是,視窗確實必須從工作表頂端開始,原因跟偷懶毫無關係
相依圖重建的時間花在哪裡
只要公式拓撲改變,HotXLS 重算引擎就會重建公式相依圖:活頁簿載入或產生後的第一次 Recalculate,以及公式改寫、工作表增刪或儲存格區塊被複製之後的第一次。兩個活頁簿類別 TXLSWorkbook 和 TXLSXWorkbook 都為此從 lxDepGraph 單元建立 TXLSDepGraph。每個公式儲存格成為一個節點,帶一個錨點(Row, Col)和一個延伸到(OutRow2, OutCol2)的輸出矩形。普通公式的矩形就是錨點儲存格本身
節點按 XLSDepMakeKey 打包的 64 位元鍵值排序:欄占位元 0–13,列占位元 14–33,工作表索引從位元 34 起跳。按這個鍵排序得到「工作表優先、列優先」的順序,所以找出對某個參照可能有意義的最後一條公式,只需在(Sheet2, Row2, 16383)上做一次二分搜尋。麻煩的是第一條。下界必須是(Sheet1, 0, 0),也就是被參照工作表的最頂端,兩個界線之間的一切都成了候選
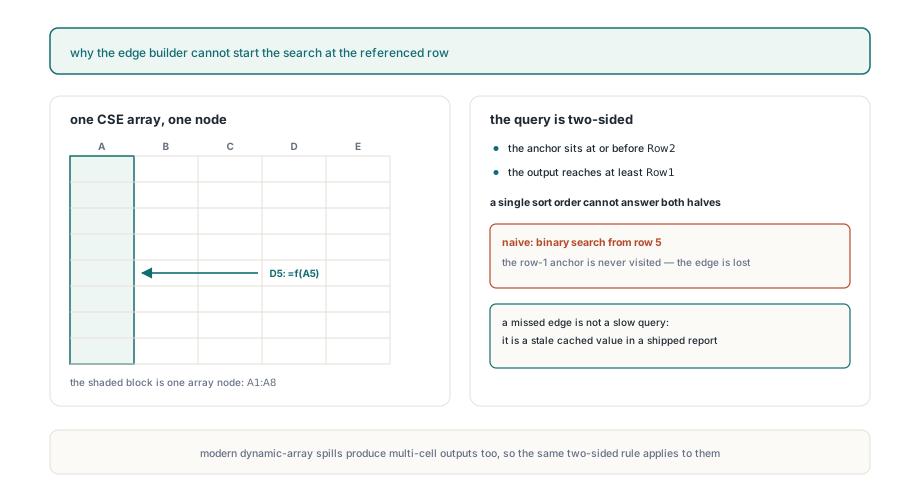
搜尋為什麼不能從被參照列開始?
錨點在某範圍上方的陣列公式可能擁有範圍內的儲存格。在 TXLSXWorkbook 裡,輸入到 A1:A8 的 CSE 陣列是單一節點,錨點在 A1,輸出向下延伸到第 8 列,增量重算與相依圖一文描述過這個結構。D5 裡只讀 A5 的公式仍然需要一條指向該節點的邊。二分搜尋若從第 5 列起跳,第 1 列的錨點永遠不會被走訪,邊不會被記錄,D5 就可能先於它依賴的陣列被求值。症狀是存檔後留下過期的快取值,這比重算變慢難察覺得多
所以真正的查詢有兩個條件。節點是候選,當且唯當:錨點在 Row2 或之前、輸出至少到達 Row1、位於參照範圍內的工作表、且欄位有重疊。按錨點排序回答得了前一半;錨點順序對後一半隻字未提,因為第 3 列的公式可能只輸出一格,也可能輸出一千列。What-if 資料表形狀相同:TXLSXWorkbook 把每張資料表登記為覆蓋整個結果區的單一節點。動態陣列公式走另一條路,被標記為易變,每輪都重算;動態陣列溢出公式一文說明溢出範圍的行為
TXLSDepGraph 是公開類別,所以不需要活頁簿就能重現這個案例。工作表索引從 1 起,列與欄從 0 起,與計算器的座標一致。下面的探針登記陣列根節點和讀取端,建立邊,並讓一條反向的點參照鏈穿過同一種圖類別,展示後面幾節要依賴的計數器
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE 陣列:錨點 A1(列 0、欄 0),輸出向下到 A8(列 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5(列 4、欄 3)只讀 A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1,即 A1 根節點
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2:A1 根節點和 D5 自己
  finally
    G.Free;
  end;

  // 鏈 A1..A100000,每格讀上一格,由下而上加入
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
按最大輸出列修剪子樹
TXLSDepGraph.BuildEdges 保留錨點排序充當上界,下界則用一棵疊在排序結果上的最大值增強線段樹回答。每個樹節點儲存其下方所有節點最大的 OutRow2。查詢只在鍵值視窗內行走,儲存最大值低於 Row1 的子樹整棵丟棄,因為那棵子樹裡沒有任何公式碰得到被參照的列。活下來的節點照樣跑完整矩形測試,工作表跨距和欄位的檢查與之前分毫不差
這項技術小到可以整個展示。下面的草稿是為本文寫的最小版本,名字自成一套;沒有一個是 HotXLS 的 API,陣列由讀者自行從一份已按錨點鍵排序的輸出列清單填入
uses
  System.Math, System.Generics.Collections;

// 僅為草稿:疊在按錨點鍵排序節點上的最大值增強線段樹。
// OutRow2[i] 是排序後第 i 個節點的最後一個輸出列。
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// 由左至右收集 [Lo, Hi) 內輸出抵達 Row1 的每個節點
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // 在視窗外,或沒有任何輸出抵達 Row1
  if L = R then
  begin
    Hits.Add(L);                 // 呼叫端仍要跑完整矩形測試
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // 先左
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // 維持掃描順序
end;

// 先以 BuildMax(Ix, 1, 0, Count - 1) 建樹一次,
// 之後每條參照呼叫 Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
每條參照的工作量從視窗大小降到 O((k + 1) log n),k 是輸出真正抵達被參照列的節點數。回到開頭的模型:從 Br 指向 Ar 的參照現在只測兩個矩形,Ar 和 Br 自己;從 Ar 指向上一格的參照只測該列的兩個節點。手工估算,完整建圖約 200,000 次測試,而不是五十億
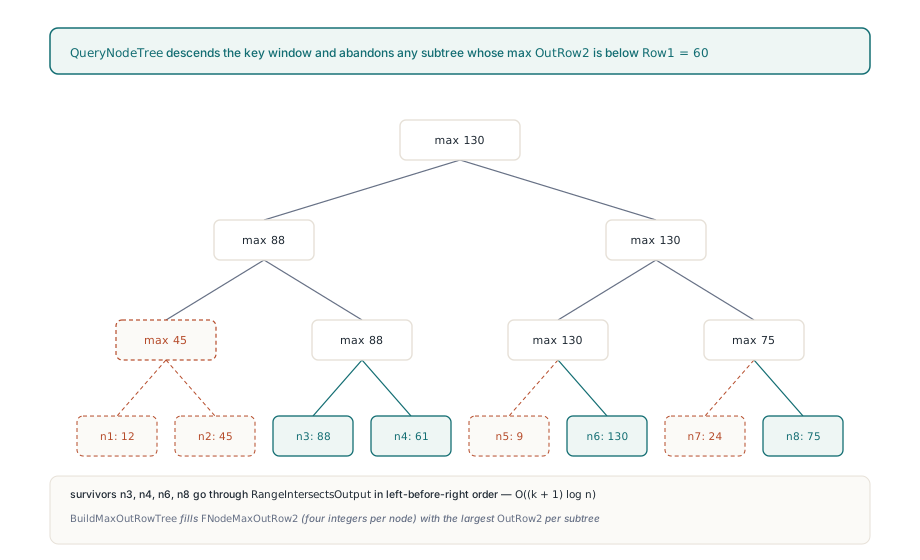
同樣的邊,同樣的順序
先左後右的遞迴比看上去重要。存活節點的走訪順序與對視窗跑普通迴圈完全一致,所以每個節點的 Dependents 和 Precedents 陣列按同樣次序填入,據此建出的拓撲順序每次執行都相同。這個順序不只是內部記帳:圖是最新的時候,XLSX 寫入器按 FullTopoOrder 回傳的順序輸出 xl/calcChain.xml,走訪順序若不確定,同一份未改動的活頁簿存兩次就會出現雜訊 diff
邊的種類規則也保住了。出現在 VLOOKUP、MATCH、XLOOKUP 等函式查找陣列引數裡的參照產生 lookup-scan 邊,會傳播髒標記但不參與環偵測。當節點對同一個前例同時有硬參照和查找參照時,先記錄的硬邊會壓制後到的 scan 邊;先記錄的 scan 邊保留自己的位置,硬邊仍然照加。這個順序正是查找範圍不會產生假循環參照的原因,而它只有在修剪後的行走按掃描順序拜訪候選時才成立
EdgeCandidateChecks 屬性讓修剪可觀察。它統計最近一次 BuildEdges 實際測試的輸出矩形數,每次建圖開始時歸零。上面的探針裡,反向鏈回報 99,999,每條參照一次測試——儘管節點是由下而上加入、排序得把它們全部重排。AddNode 把排序和邊都標記為過期,下一次 BuildEdges 或 NodeIndexOf 會重建索引而不是修修補補
剩下的成本在哪裡
樹只按列修剪,這個選擇決定了大型模型還要為什麼買單
- 欄位失配的代價留在葉子上:填滿
A100:Z200的 2,626 條公式全部抵達第 100 列,指向AA100:AA200的參照得逐一測試它們,最後才在欄位上被拒絕 - 整欄和其他寬參照確實有很多前例;索引去掉的是浪費的測試,建出真正的邊仍與數量成正比
- 跨多張工作表的參照會打開覆蓋第一張表全部的視窗,那裡輸出很深的公式都會走到葉子測試;邊的結果相同,只是修剪變弱
- 樹每個節點吃四個整數,100,000 條公式約 1.6 MB;任何拓撲變更都讓下一次建邊付出完整 O(n log n) 重排序加上 O(n) 建樹
列是單一索引維度的正確選擇。產生的報表、帳冊和財務模型都向下生長,浪費的候選幾乎全部來自列距離,而欄位失配在矩形測試裡用幾次整數比較就遭拒。在樹裡加第二個維度只會複雜化每個查詢,省下的卻是本來就便宜的測試
呼叫端這邊,昂貴的步驟是重建,而改值不觸發重建。Recalculate 第一次呼叫時建圖;之後的呼叫只重算位於改動值下游的公式,外加易變公式。先寫完所有公式、再一次重算,是要追求的模式。下面的治具在經典引擎上為兩種階段計時,Recalculate 回傳無法求值的公式儲存格數;請在實際要跑批次作業的硬體上執行,因為絕對時間高度依賴機器
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // A 欄裡 49,999 節的鏈
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // B 欄裡 50,000 個相依者
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // 建圖,求值全部
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // 改值:圖被重用
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // 只跑髒子圖
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
在這個模型裡,改值階段仍會重算全部 99,999 條公式,因為整個 A 欄都掛在 A1 之下;它跳過的是建圖。用純值覆寫公式儲存格則是另一回事,那會改變拓撲,下一次 Recalculate 會從頭重建圖
被複製的定義名稱裡同樣的二次方形狀
報表帶狀區把同一個模式藏在另一處。TXLSXWorksheet.CloneRangeTo 會複製直接指向被複製區塊內範圍的定義名稱,而每份副本都需要一個在其範圍內唯一的名稱:Total_2、Total_3,依此類推。每次複製都從 _2 重新搜尋的話,每多一份副本就多試一個候選,於是由數百條複製帶組成的工作表,光命名就要花掉二次方次的名稱查找
TXLSXDefinedNames 在名稱索引裡為每個基底名稱和範圍保存一個後綴提示來避免這件事。下一次搜尋從上次回傳的後綴起跳,並先複查它,因為呼叫端可以不加那個名稱。刪除名稱、透過 Name 改名、用 SheetIndex 搬移或清空集合,都會連同所有提示一起丟掉索引,下一次複製便回到第一個空閒後綴,補上這次變動留下的任何缺口
對要產生或重算大型試算表的 Delphi 與 C++Builder 應用,HotXLS Excel component for Delphi and C++Builder 在經典與 XLSX 兩個活頁簿類別的重算引擎裡都使用這套帶索引的相依圖