一個指向整欄的定義名稱,出現在純量位置時會被 Excel 當成單一儲存格來讀:第 7 列的 =Vertical+1 意思是「Vertical 第 7 列的那一格」,不是整個區域。HotXLS Delphi Component 從 v2.382.4 起在兩個層級套用這個隱含交集:求值時,以及抽取依賴關係時。原因是一份有 4805 條公式的貸款範本顯示,光把值算對並不夠。當依賴走訪器把名稱展開成完整區域,任何餵給該區域某一格的下游公式就閉出了一條根本不存在的循環,TXLSXWorkbook.Recalculate 於是拒絕整本活頁簿
那份範本就是一本現成的貸款攤還活頁簿。把每個快取值都毒成 777,再跑一次完整的 Recalculate,兩種引擎架構都回傳 23,也就是 lxErrorRef,循環參照的代碼。4805 條公式裡有 3842 條與獨立期望值不符,B18 帶著 #VALUE!,E18 還是 777,而 J7 的期數讀到的是一條還沒算完的餘額欄裡的佔位值。三個彼此獨立的缺陷躲在同一個回傳碼後面,本文逐一把對應的修正原始碼講過一遍
為什麼對欄名做純量參照會造出假循環?
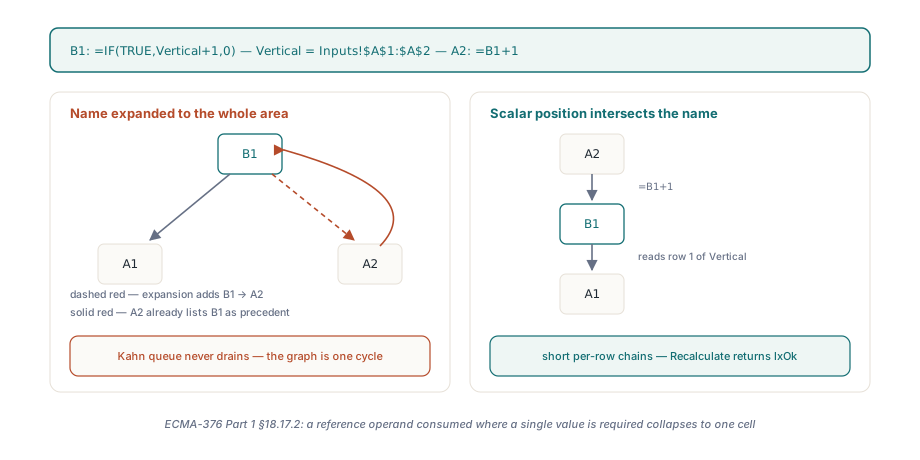
因為依賴圖只認邊,而從一條公式連到 480 列區域的邊就是 480 條邊,其中一條會繞回某個依賴這條公式的儲存格。設 B1 是 =IF(TRUE,Vertical+1,0)、Vertical 定義為 Inputs!$A$1:$A$2,而 A2 是 =B1+1。Excel 把 B1 算成 A1+1、A2 算成 B1+1,一條直鏈。走訪器若把 B1 記成依賴 A1:A2,A2 就成了 B1 的前置項,而 A2 早已把 B1 列為前置項,於是驅動HotXLS 增量重算的 Kahn 佇列永遠等不到這兩個節點的入度歸零。貸款範本正是由這個模式構成的:每一列期數都參照餘額、利率與期數的具名欄,每個名稱都橫跨整份攤還表,而每一列又同時寫進那些欄位。把名稱展開,圖就是一整塊巨大的強連通分量。改用隱含交集去算,圖就變成一組短鏈、每一列一條,這正是 ECMA-376 Part 1 §18.17.2 對「在需要單一值的位置消耗參照運算元」的描述
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // 純量位置:公式在第 1 列,所以 Vertical 收斂成 A1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // 定義指向另一個名稱的名稱照樣做交集,所以這裡是 A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // 參照類引數:整個區域相加,不做交集
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // 第 6 列落在 A1:A2 之外,交集為空,由 IFERROR 接住
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2、A2 = 3、B2 = 3、B3 = 4、B6 = 42
      // v2.382.4 之前這個分支到不了:B1 -> A2 -> B1 是一條循環
    end;
  finally
    Book.Free;
  end;
end;
HotXLS 怎麼判定一個引數是純量?
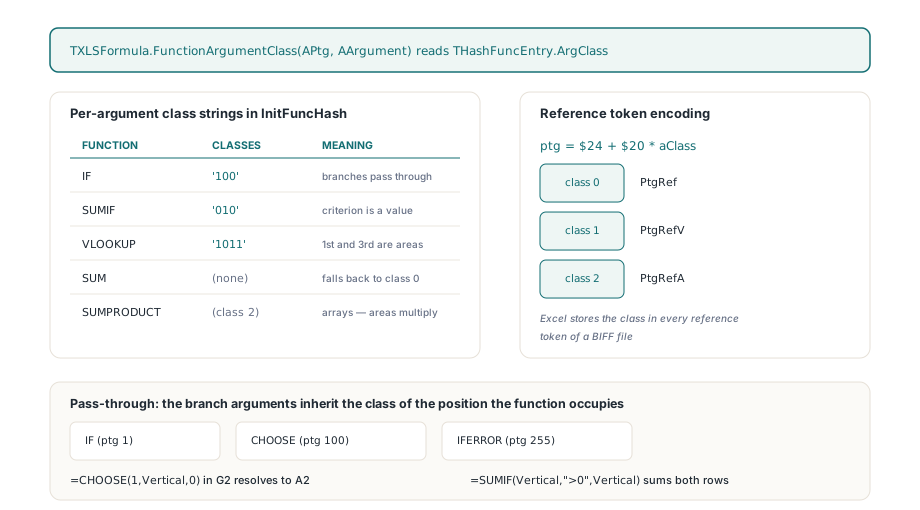
HotXLS 是從函式表讀答案,而不是看引數的形狀。TXLSFormula.InitFuncHash 裡的每一筆都經由 THashFunc.SetValue 註冊,可附帶一個逐引數的類別字串:'IF' 帶 '100'、'SUMIF' 帶 '010'、'VLOOKUP' 帶 '1011',而 'SUM' 什麼都不帶,所以它的引數全部退回函式層級的類別 0。新增的 TXLSFormula.FunctionArgumentClass(APtg, AArgument) 透過 THashFuncEntry.ArgClass 把那個位元組暴露出來,回傳 1 代表值類別。這三個類別就是 [MS-XLS] §2.2.2 指派給運算元 token 的那三個,而編碼器早就依賴它們:寫入參照時,它把 ptg 算成 $24 + $20 * aClass,類別 0 得到 PtgRef、類別 1 得到 PtgRefV、類別 2 得到 PtgRefA。Excel 寫出的 BIFF 檔在每一個參照 token 裡都存了那個類別,所以只要函式表與規格相符,引擎不必看資料就能回答「這個引數是不是純量」。SUMIF 中間那個引數是準則,是一個值;第一與第三個是區域,是參照。SUMPRODUCT 則以函式層級類別 2(陣列)註冊,這就是為什麼 =SUMPRODUCT(Vertical,Vertical) 還是會把整個區域相乘
有三個函式在第一個引數之後完全不查自己的表項。IF(ptg 1)、CHOOSE(ptg 100)與 IFERROR(ptg 255)會把它們選中的東西直接傳出去,所以它們的分支引數繼承的是函式本身所處位置的類別。光是這一條規則,就讓 G2 的 =CHOOSE(1,Vertical,0) 解析成 A2,而旁邊的 =SUMIF(Vertical,">0",Vertical) 照樣把兩列相加;這也是攤還表最常動用的一條規則,因為它的期數格靠 IF 來測貸款是否還沒結清
把類別帶進依賴走訪
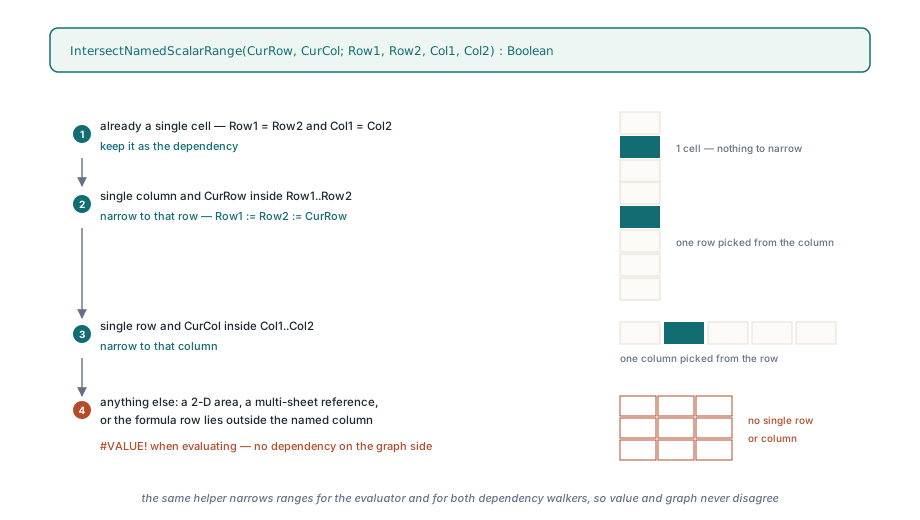
lxCalc.pas 裡的依賴抽取器是對編譯後語法樹跑的遞迴 Walk,而且存在兩份:一份在 TXLSCalculator.ExtractDependencies 裡管活頁簿內的圖,一份在 ExtractWorkspaceDependencies 裡管跨活頁簿的圖。v2.382.4 給了兩個走訪器各兩個額外參數。AScalar 在公式根節點起始為 True,對每個函式子節點依 FunctionArgumentClass 重新計算,而對 ptg 1、100 與 255 的分支引數則原值傳遞。ANameRoot 只在走訪器下降進某個名稱的編譯定義時才變成 True,而且只穿得過 SA_GROUP 節點(也就是括號),所以定義為 =A1:A2+1 的名稱不會被誤認成單純的區域。當這兩個旗標在 SA_RANGE 節點上同時為 True,AddResolvedRange 就會用求值器在記錄依賴之前所用的同一個 helper 把區域收斂。這個 helper 短到可以直接整段引用
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // 本來就是單一格
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // 單欄:取這一列
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // 單列:取這一欄
    Result := True;
  end;
end;
凡是 helper 拒絕的東西——二維區域、跨工作表參照,或所在列落在具名欄之外的公式——在求值端產生 #VALUE!,在圖那一端則完全不記任何依賴,這正是 Excel 對空交集的做法。求值端位於 TXLSCalculator.GetValueItemName:它把編譯定義上的 SA_GROUP 外層剝掉,若根節點是 SA_RANGE,就呼叫 GetRangeInfo、做交集,然後透過 FGetValue 取出那一格,而不是把整個定義算一遍。外部參照走原本的路,因為沒有本地的列可以拿來交集。名稱的儲存與作用域一開始是怎麼來的,見定義名稱與跨工作表公式一文;這裡只關心名稱解析出來之後引擎做了什麼
為什麼對算到一半的欄位做 MATCH 會讀到 777?
因為 MATCH 的查閱陣列引數是一種掃描參照,而掃描參照是刻意被排除在求值順序之外的。查閱掃描一文引進了 TXLSDepRange.LookupScan,並以「把掃描邊排除在排序之外所放棄的東西」一節收尾:查閱公式可能在範圍內每一格都重算完之前就先跑,讀到過期的值。在互動式工作階段裡,下一趟就會收斂。但對一份被毒過的範本做批次重算時不會,而定義為 =MATCH(0.01,Balances,-1)+1 的 PaymentCount,就讀到了還躺在餘額欄裡的 777 佔位值,回傳一個不可能對的期數
TXLSDepGraph.TopoOrder 現在把掃描邊當成軟性排序邊。它在硬性入度之外另外維護一個 ScanInDeg 陣列,統計每個節點還有幾個髒掉的掃描前置項,並在那些前置項被吐出時遞減,用的就是先前的改動已經存下來的 ScanPrecedents、ScanDependents 與 ScanPrecedentCount 清單。每一次迭代,Kahn 佇列會掃過它的就緒視窗,找出第一個 ScanInDeg 為零的節點並把它換到隊首;若每個就緒節點都還在等掃描前置項,就照穩定順序彈出隊首。掃描邊永遠不會進入硬性入度,所以一個對自己所在欄位做 VLOOKUP 的自我參照仍然合法,但一個能等到可完成前置項的查閱,現在就會等。釘住這個行為的迴歸測試 LookupScan_WaitsForDirtyFormulaValues 把三個餘額格毒成 777,期望 PaymentCount 回傳 3,接著把輸入翻成零,期望 =IFERROR(PaymentCount,99) 看到 #N/A 並回傳 99
四位小數的截斷是從哪冒出來的?
來自 Delphi 的 Variant 算術,而且只發生在巢狀位置。TXLSCalculator.GetValueItem 裡的二元運算子早就把最外層的 + 或 - 複製到兩個 Double 區域變數,所以 =B1-A1 沒問題。但在 =IF(TRUE,B1-A1,0) 裡面,同一個減法變成對兩個 Variant 執行 Value := Value - SubValue,而當一個運算元是 Int64 的儲存格值、另一個是 Double 時,我們觀察到的結果是 Currency——一種四位小數的定點型別——所以 1066.1854641400994 減 120 回來就被截成四位小數。在一份每一期都由前一列複利推算的攤還表上,這個誤差會走過幾百期才傳到總計
// TXLSCalculator.GetValueItem,二元算術分支(lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Int64 與 Double 混用的 Variant 算術可能被提升成 Currency。
// 試算表算術必須保住浮點精度。
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
這道防護在 SA_ADD、SA_SUB、SA_MUL 與 SA_DIV 之前一律先跑,而迴歸測試 Arithmetic_MixedInt64AndDoubleKeepsPrecision 把 Int64(120) 存進 A1、1066.1854641400994 存進 B1,然後以 1E-10 檢查巢狀的差與和,以 1E-8 與 1E-12 檢查積與商。HotXLS 不宣稱自己知道 RTL 在各個編譯器版本上對混用 Variant 型別套用的每一條提升規則;它宣稱的是試算表算術就是 IEEE double,而它現在讓兩個運算元在運算子看到它們之前都變成 double,問題也就不存在了
這項修正保證了什麼,又沒保證什麼
v2.382.4 之後,兩種引擎架構對那份被毒過的範本都回傳 lxOk,4805 個快取值全部在 1E-7 之內與獨立的逐列期望值相符,而「快取真的被毒過」「來源雜湊沒變」「每一條公式都還在」這幾個斷言也都成立。過程中沒有啟用迭代,也沒有壓掉任何錯誤碼。一條貨真價實、經由名稱形成的循環——A1 是 =B1 而 B1 仍在讀 Vertical——依然回傳錯誤,測試 NamedScalarRanges_IntersectWithoutFalseCycles 就是以此收尾
界線值得講清楚。隱含交集只適用於編譯定義在剝掉括號之後、是單一工作表上單欄或單列區域的名稱;出現在純量位置的二維名稱跟 Excel 一樣是 #VALUE!,而函式表不認得的函式會從 FunctionArgumentClass 拿到類別 0,所以它的名稱引數照樣整片展開。軟性排序是一種偏好,不是保證:純掃描構成的循環仍然照穩定順序求值,讀到的就是當下快取裡的東西,這正是查閱掃描一文刻意接受的行為。而整份範本的結果是對著一支獨立的期望值腳本驗證的,不是對著另一套試算表引擎,因為參考辦公套件沒能在 60 秒的預算內把原始範本重算完。HotXLS 是原生 Delphi 與 C++Builder 的試算表元件,不需安裝 Excel 就能讀取、重算與寫入 XLS、XLSX、ODS 與 CSV;名稱交集、引數類別表與軟性掃描排序因為共用同一顆計算引擎而適用於每一種格式,目前的函式涵蓋範圍列在 HotXLS Delphi 試算表元件產品頁上