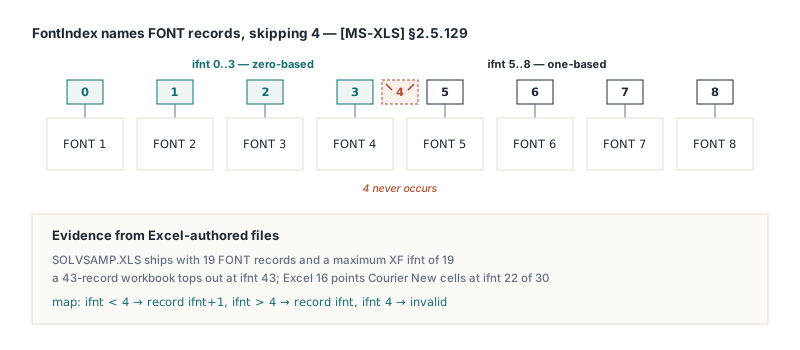
一份帶八條 FONT 記錄的 BIFF8 活頁簿,裡面有條 XF 記錄的字型欄位寫著 8。從零起數的話這已經超出表格一格,Excel 卻毫無怨言地用第八號字型渲染那個儲存格。這個值是合法的:[MS-XLS] §2.5.129 把前四條 FONT 記錄編為 0 到 3,整個跳過 4,之後的每條記錄按其一為基的位置編號
所以第五條 FONT 記錄是 ifnt 5,格式良好的檔案永遠不會需要大於其 FONT 記錄數的值。這條規則讀起來像規範裡的筆誤,正是有人動手「修正」它的原因;又因為儲存格格式、共用字串的 rich text 和註解 run 全都帶同一個 FontIndex 型別,兩條路徑若讀法不一,就會某些字型綁對、另一些整整差一條記錄。它與 解碼 BIFF8 XLUnicodeString cch 與 fHigh一文裡的長度與編碼怪癖同屬一族——檔案沒問題,是讀它的方式有問題
[MS-XLS] §2.5.129 到底說了什麼,以及在真實檔案上怎麼驗
[MS-XLS] §2.5.129 把 FontIndex 定義為帶一個洞的記錄位置。低於 4 的值從零起數,高於 4 的值從一起數,值 4 絕不可用。XF 記錄用它指向字型,rich 共用字串的 FormatRun 條目用它,§2.5.272 描述的 TXO 格式化 run 也用它
你不必照單全收規範的說法。用任何 BIFF 記錄檢視器傾印一份 Excel 自己存的 .xls,數一數 FONT 記錄(記錄類型 $0031)的條數,再掃描每條 XF 記錄($00E0)開頭的字型欄位。最大值不會超過記錄數,清單裡也不會出現 4。如果你看到 4,或高於 FONT 數的值,這份檔案就不是 Excel 寫的,它的字型編號值得多看兩眼。對診斷工具或測試而言,整個映射兩個函式就放得下
// 你自己的輔助函式,不屬於任何函式庫
// [MS-XLS] 2.5.129 FontIndex:0..3 從零起數,> 4 從一起數,4 無效
function FontIndexToRecordNo(Ifnt: Word): Integer;  // FONT 記錄,從 1 起算
begin
  if Ifnt < 4 then
    Result := Ifnt + 1
  else if Ifnt > 4 then
    Result := Ifnt
  else
    Result := -1;  // 4 不該出現
end;

function RecordNoToFontIndex(RecordNo: Integer): Word;
begin
  if RecordNo <= 4 then
    Result := RecordNo - 1
  else
    Result := RecordNo;
end;
HotXLS 如何為 XF 記錄與 rich text run 為字型編號
HotXLS 按規範編號讀寫每一個 BIFF8 字型引用。存檔時字型表先壓實到真正被引用的字型,每個存留字型的位置變成一個 FontIndex:位置 1 到 4 寫成 0 到 3,位置 5 以上原樣輸出。載入反向操作:5 以上的值減一找到記憶體裡的字型,5 以下的原地不動。同樣的轉換套用在 XF 記錄、共用字串表的 rich text run、註解與文字方塊 run,以及經典圖表記錄裡的字型引用上
對應用程式碼而言,可見的部分是 TXLSComment 和 TXLSTextBox 上的 TextRuns。TextRuns.FontIndex[I] 原樣回傳讀到的檔案編號,跳過 4。run 索引從 1 起算,CharIndex[I] 是 run I 起始的字元偏移量。在這裡暴露檔案編號而不是從零起數的表格槽位是更好的預設:API 回報的與記錄傾印顯示的一致。代價是在把值當表格位置用之前,先呼叫一次上面的輔助函式
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  I: Integer;
  Ifnt: Word;
begin
  Book := TXLSWorkbook.Create;
  if Book.Open('review-notes.xls') <> 1 then
    raise Exception.Create('Cannot open review-notes.xls');
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  if Note <> nil then
    for I := 1 to Note.TextRuns.Count do
    begin
      Ifnt := Note.TextRuns.FontIndex[I];   // 檔案編號,跳過 4
      // 你自己的健全檢查:4 代表檔案違反 2.5.129
      if Ifnt = 4 then
        raise Exception.CreateFmt('Run %d uses invalid ifnt 4', [I]);
      Writeln(Format('run %d at char %d: ifnt %d = FONT record #%d',
        [I, Note.TextRuns.CharIndex[I], Ifnt, FontIndexToRecordNo(Ifnt)]));
    end;
end;
存檔之後,某個 run 存的編號可能與你讀到或設定的不同。存檔會連同壓實後的字型表一起為 run 重新編號,編號會變,它指向的字型不會
為什麼一次從零起數的修正會把每個自訂字型都挪位
這個陷阱通常始於一份看起來合理的 bug 報告。有人傾印一份帶八條 FONT 記錄的活頁簿,看到 XF 指向字型 8,斷定寫入端產生了越界索引,於是把寫入端和讀取端一起改成純粹從零起數的算術。往返測試照樣通過,因為打過補丁的寫入端與讀取端互相印證。Excel 不印證。照那種寫法存出的檔案,把第一個自訂字型存成 ifnt 4,Excel 把它解析成預設字型,之後每個自訂字型都提前一條記錄落座。讀 Excel 自己的檔案則反過來:每個字型晚一條記錄才綁上
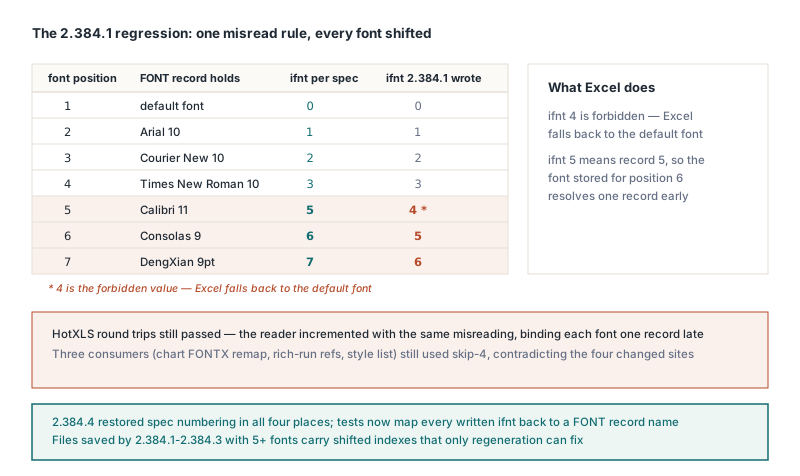
兩個訊號能在出貨前暴露這種誤讀。其一是一條斷言 ifnt < FontCount 的測試。它看似邊界檢查,實際上把誤讀寫成了需求。透過規範公式把每個寫出的 ifnt 映射回 FONT 記錄名稱的測試,第一次執行就抓到位移
另一個訊號是程式碼自相矛盾。完整的 BIFF8 讀取端與寫入端要在多處套用跳過 4 的規則:XF 輸出、XF 輸入、共用字串 run 重映射、註解 run、圖表字型記錄。當一次修改把其中幾處改成從零起數、其餘原封不動,未被動過的那幾處就是證據——先懷疑那次修改,再懷疑它們。半套修改能潛伏很久,因為 rich text 裡用到的字型,通常也有某個儲存格格式引用著
為什麼註解字型 run 只在第二次存檔時壞掉?
兩種寫入習慣相遇時,註解與文字方塊 run 可能熬過一次存檔、卻在下次崩掉。第一種習慣是不對稱修剪:無條件保留前 N-1 條 FONT 記錄,只在最後一條無 XF 引用時把它丟掉。第二種是把 TXO 格式化 run([MS-XLS] §2.4.329)逐位元組寫回而不重新編號。各自單獨看,兩種習慣都能通過單次存檔測試;合起來,它們埋下了一場等一個世代的字型流失
原因在 Excel 寫出什麼。Excel 親自產出的 .xls 常以一條無人引用的收尾字型結束;在中文語系的系統上是 9 pt 的等線。第一次存檔時,只被某個註解 run 使用的字型因此永遠不是最後一條,什麼也不會動。但那次存檔丟掉了收尾字型,把只有註解在用的字型推上最後一個位置。第二次存檔發現最後一條字型沒有 XF 引用,便把它丟了。run 的 ifnt 於是指到表格末端之外,Excel 退回預設字型。如果活頁簿其間新增了一個字型,run 反而綁到新來的。建立註解與超連結審閱工作流裡那種反覆開啟、批註、再存的筆記,正是這毛病最先現身的地方
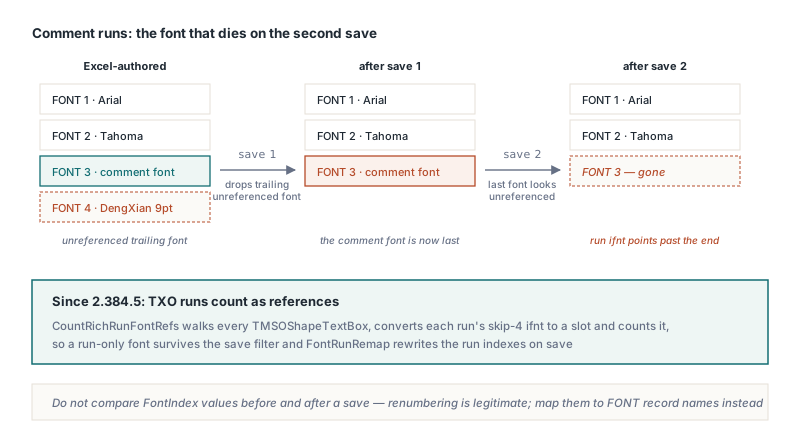
HotXML 對註解與文字方塊 run 的處理,與共用字串 run 同一套。壓實字型表之前,每張工作表上的每個 run 都從其跳 4 的 FontIndex 轉成表格槽位並計入引用,只有 run 在用的字型因此留得住。輸出時,run 走與 XF 記錄重編號相同的槽位到存檔索引對照表。收尾的 TxOLastRun 條目不帶字型,按讀到的原樣寫出。正因為有這層重編號,比較存檔前後的 FontIndex 值毫無意義;要比的是它們解析到的字型名稱
複製、插入列與跨活頁簿的 run
在經典引擎裡,Range.Copy、CopyRange、Sheets.AddCopy 以及 Range.Insert 和 Range.Delete 背後的儲存格位移,全都走同一條儲存格複製路徑,位移不過是複製加清除。一次只帶註解文字和作者的複製,會在一次插入列之後把雙 run 筆記變成單字型筆記——使用者根本沒碰過那則註解
HotXLS 複製每個 run 的起始偏移量和字型,連同文字一起。同一活頁簿內,FontIndex 原樣重用。跨活頁簿時字型按值搬移:跳 4 的編號轉成槽位,字型按屬性在目標字型表裡配對或新增,得到的槽位再轉回檔案編號。Sheets.AddCopy 把工作表複製進另一本活頁簿時,共用字串裡的 rich text 也走同一套轉換,兩種 run 因此無從漸行漸遠。字型表這一側採用的按值搬移,與跨活頁簿複製與公式重綁一文涵蓋的公式那一側同一路數
為這套行為寫測試時,有兩個邊界案例值得知道:
- 原地貼上——來源與目的地解析到同一則註解——保留其 run;在被讀取之前什麼都不會被清除
Sheets.AddCopy也會複製錨在沒有儲存格記錄的儲存格上的註解,只跑儲存格記錄的迴圈會漏掉這些
XLSX 引擎上,複製按值克隆註解 run,註解部件以 rFont、strike、u 和 vertAlign 讀寫。run 的字型名稱、刪除線、底線與上下標設定,因此存檔重開之後原樣回來
經得起重新編號的迴歸測試
本文的每個陷阱都能通過記憶體內的測試。從零起數的誤讀住在配對好的寫入端與讀取端裡,註解字型的流失需要兩次存檔,XLSX 上丟失的註解 run 只在重開後現形。所以測試必須從磁碟重開、至少跑兩個存檔世代、檢查 run 結構而不是原始字型編號。從一份 Excel 親自存出的活頁簿起步,C2 上有一則雙 run 註解,其第二個 run 用的字型在檔案裡無人引用——那正是第二次存檔原本會丟掉的字型
procedure CheckNoteAcrossTwoSaves(const SrcFile, Out1, Out2: string);
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  RunCount: Integer;
  SecondRunAt: Word;
begin
  // Assert 呼叫是你自己的測試檢查
  Book := TXLSWorkbook.Create;
  Assert(Book.Open(SrcFile) = 1);          // Excel 存的,C2 有兩個 run
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  Assert(Note <> nil);
  RunCount := Note.TextRuns.Count;
  SecondRunAt := Note.TextRuns.CharIndex[2];

  Book.Sheets[1].Range['C2', 'C2'].Copy(Book.Sheets[1].Range['E5', 'E5']);
  Book.Sheets[1].Range['C1', 'C1'].Insert(xlShiftDown);   // C2 挪到 C3
  Assert(Book.SaveAs(Out1) = 1);

  Book := TXLSWorkbook.Create;               // 第二個世代
  Assert(Book.Open(Out1) = 1);
  Assert(Book.SaveAs(Out2) = 1);

  Book := TXLSWorkbook.Create;               // 重開,絕不信任記憶體
  Assert(Book.Open(Out2) = 1);
  Note := Book.Sheets[1].Range['C3', 'C3'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
  Assert(Note.TextRuns.CharIndex[2] = SecondRunAt);
  Assert(Note.TextRuns.FontIndex[2] <> 4);
  Note := Book.Sheets[1].Range['E5', 'E5'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
end;
run 數和起始偏移量抓得住被壓平的筆記。字型本身還要在測試之外多走一步:用記錄檢視器開啟 Out2,把每個 run 的 ifnt 過一遍 FontIndexToRecordNo,確認落點的 FONT 記錄帶著與來源檔相同的字型名稱。在 Excel 裡,字型流失的症狀是 C3 筆記第二個 run 變成預設字形
經典 XLS 仍出現在不少 Delphi 與 C++Builder 專案裡,而 BIFF8 檔案裡的每個字型消費端都必須在 §2.5.129 上達成一致,輸出才能在 Excel 裡正確開啟。HotXLS,Delphi 試算表元件在儲存格格式、共用字串、註解、文字方塊與圖表之間貫徹跳 4 編號,每次存檔為 run 重新編號、跨活頁簿按值搬移,並在無 Excel、無 OLE 自動化的前提下讀寫 XLS 與 XLSX