PDF 沒有內嵌字型時,HotPDF 元件用 HPDFMapBaseFontToSystem 選出的已安裝 Windows 字型來渲染那段文字:它解碼 /BaseFont 名稱、剝掉樣式部分、嘗試幾種拼寫直到 GDI 確認家族已安裝、從度量相容字型補測標準 14 字型缺失的寬度、並在繪製前把單位元組碼轉成 Unicode。這些步驟每一步的存在,都是因為天真的版本在真實檔案上栽過。RenderLoadedPageToBitmap 頁面渲染器處理內嵌字型程式得心應手;這篇講的是那些根本不在檔案裡的字型
為什麼 GDI 會無聲畫出錯的字體?
GDI 從不回報字型缺失:給 CreateFontIndirect 一個它不認得的字體名,它安安靜靜選個替身,常常是另一款沒有粗體字重的襯線體。早期渲染器幾乎原樣傳遞 PDF 名稱,於是 TimesNewRoman,Bold、TimesNewRomanPS-BoldMT 與 SegoeUI-Semibold 全部什麼都配不上,最後用 GDI 隨手挑的字體出場。名稱還可以更糟。ISO 32000-1 §7.3.5 允許名稱以 #xx 寫任意位元組,CJK 產生器慣用跳脫過的 UTF-8 或舊字碼頁位元組拼字型名;v2.766.69 之前,那些跳脫序列本身就成了字體名。HPDFMapBaseFontToSystem 現在先解碼跳脫序列,合法的 UTF-8 位元組序列當字元返回,其餘高位元組按系統字碼頁解讀
砍樣式是啟發式開始咬人的地方。逗號永遠終結家族(Arial,Bold 得到 Arial),連字號只有在後面的詞是樣式時才算:Bold、Italic、Oblique、Regular、Roman、Medium、Light、Black、Heavy、Semi、Demi、Thin、Extra、Ultra、Condensed。這條規則讓 MS-Mincho 保持完整,同時把 Calibri-Light 變成 Calibri。HotPDF 接著嘗試家族的各種拼寫,再試去掉 PSMT、MT 或 PS 後綴的拼寫。從 v2.768.18 起,這些拼寫覆蓋所有在可能起詞的位置選擇加不加空格的組合:小寫字母後的大寫之前(MyriadPro 變 Myriad Pro)、一串大寫中後面跟著小寫的最後那個大寫處(UIGothic)、以及開頭 MS 之後(MSPGothic),從全空格形式一路到原樣名稱;超過四個這類位置之後,只試全空格與連寫兩種。加空格不能無腦套,因為 Windows 保留了一些連寫詞:SimSun 就以這個拼寫安裝,而 MicrosoftYaHei、MicrosoftJhengHei 與 MSPGothic 屬於 Microsoft YaHei、Microsoft JhengHei 與 MS PGothic。v2.768.18 之前,映射器在每個內部大寫前加空格,MicrosoftYaHei 於是被當成 Microsoft Ya Hei 去查,永遠查不到。候選字型算「已安裝」的條件是:CreateFontIndirect 之後 GetTextFace 回傳請求的名稱,或者——自 v2.768.18 起——所選字型的 name 表把它列為任意語言的家族名、完整家族名或排版家族名;結果按名稱快取,帶著大量未安裝字型的文件不再每頁為每個名稱去試探 Windows
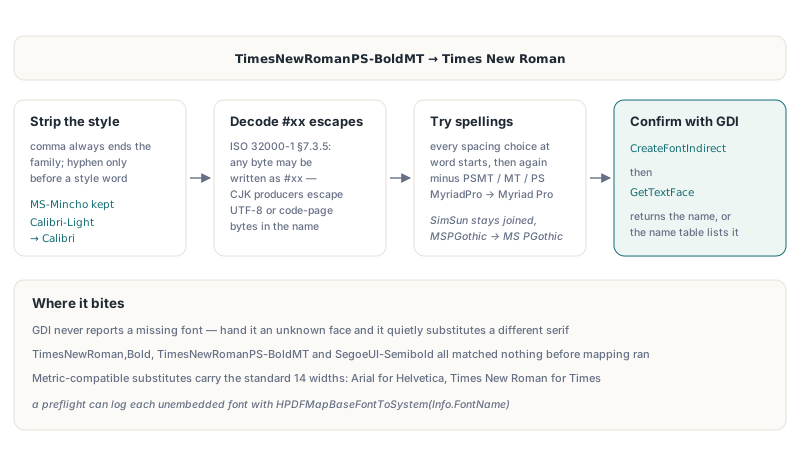
映射函式在 HPDFRenderFontMetrics 單元裡是公開的,所以預檢報告可以指出每個未內嵌字型將以哪個已安裝家族渲染,用的是 THotPDF 已為已載入文件暴露的字型列舉:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
沒有 /Widths 的標準 14 字型怎麼量寬度?
HotPDF 用相同度量的已安裝字型補測缺失的前進量,因為 ISO 32000-1 §9.6.2.2 允許標準 14 字型省略 /Widths,而函式庫不附 AFM 表。Arial 帶 Helvetica 度量、Times New Roman 帶 Times、Courier New 帶 Courier,所以 HPDFMeasureBaseFontWidths 以 lfHeight = -1000 建立對應字體、呼叫 GetCharWidth32W;在這個高度,結果已經是 PDF 寬度用的 1/1000 em 單位。渲染器先經 /Encoding、/BaseEncoding 與 /Differences——預設 StandardEncoding——把每個碼轉成 Unicode。SVG 匯出與文字擷取還踩過一個陷阱:一個完全不帶 /Encoding 的標準 Type 1 字型,產出了解碼器卻沒有編碼資訊,SVG 匯出從未註冊它,量出來的寬度全部作廢。補上隱含的 StandardEncoding 修好了它,前提是標記成預定義編碼;要是走 CMap 名稱那條路,每個碼都解成 0,所有寬度跟著完蛋
粗體、斜體與字型描述器旗標的差一錯誤
字型描述器的 /Flags 條目從 1 起數位元,不是從 0,所以按 ISO 32000-1 表 123,ForceBold 是位元 19($40000)、Italic 是位元 7($40)。舊程式碼測的是 $20000——那是位元 18,SmallCap。這個錯從 v2.345.0 活到 v2.766.53,因為 /FontDescriptor 幾乎總是間接引用,而字型建構器只讀直接物件,整個旗標分支從未執行;同樣的失明也無視了 /Widths 12 0 R,文字按 500 單位的後備前進量排版。v2.766.53 開始讓渲染器解析間接引用之後,同一個變更裡就必須把位元改對,否則每個小型大寫字體會突然全變粗體:
const
  // ISO 32000-1 表 123 的位元位置從 1 起數
  FD_ITALIC     = $00040;  // 位元 7
  FD_SMALLCAP   = $20000;  // 位元 18,不是字重
  FD_FORCEBOLD  = $40000;  // 位元 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;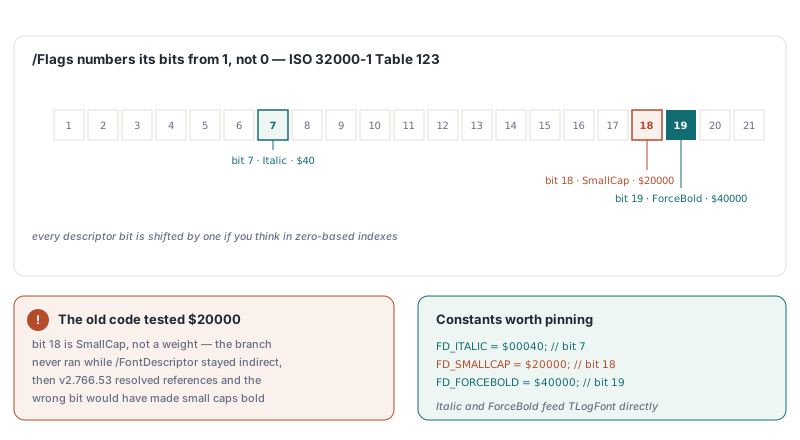
帶 UCS2 CMap 的 CJK 字型為什麼寬度不對?
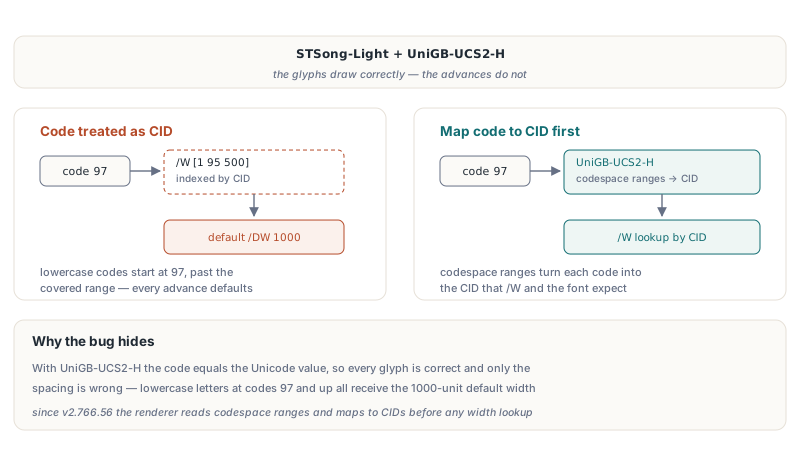
帶預定義 UCS2 CMap 的 CJK 文字畫得出正確字形、間距卻錯,原因是渲染器把字元碼當 CID 用,而 /W 以 CID 索引,不以字元碼索引。用 STSong-Light 與 UniGB-UCS2-H 時,碼恰好等於 Unicode 值,GDI 畫出正確字元、bug 藏在前進量裡:小寫字母以 97 以上的碼到達,落在 [1 95 500] 這種 /W 條目之外,統統領到 1000 的預設寬度 /DW。從 v2.766.56 起,HotPDF 渲染器經 CMap codespace 區間(ISO 32000-1 §9.7.6.2)讀碼、先映射成 CID 再查寬度。只有內建 UCS2 與 UTF16 表與內嵌 CMap 串流會被使用;對 GBK-EUC-H 之類做 identity 近似,只會裝出支援的樣子卻產出錯誤結果,所以渲染器不裝
中文 Windows 上帶音標的字元為什麼變問號?
單位元組碼絕不能餵給 ANSI(「A」)系列 GDI 函式,因為 GetGlyphOutlineA 與 GetGlyphIndicesA 按系統字碼頁解讀位元組,而 TextOutA 用的是所選字型的字元集。中文系統上,Arial 的位元組 $A9(Windows-1252 裡的著作權符號)成了 GBK 前導位元組、渲染成「?」,v2.766.83 加入的無提示輪廓路徑一頭栽進這個陷阱。v2.767.3 用 GetTextCharset 向實現的字型要字元集,經 TranslateCharsetInfo 換成字碼頁,把位元組過 MultiByteToWideChar、改呼叫 W 系列;符號字型改用 U+F000 加碼。與 Windows-1252 不一致的編碼——/Differences、StandardEncoding、MacRomanEncoding——在任何系統字型看到它們之前就先映射成 Unicode
用系統字型繪製的極限在哪裡?
系統字型渲染是近似,HotPDF 元件對自己的邊界很誠實。v2.768.18 之前,安裝檢查只比對 GetTextFace 回傳的名稱,而在地區化的 Windows 上那個函式以系統語言回報家族名,所以中文 Windows 上的 Microsoft YaHei、日文 Windows 上的 Yu Mincho 被判缺失、畫成 GDI 替身;從 v2.768.18 起,以別的名稱回來的字體也會到字型的 name 表裡查,這類字型找得到了。度量相容只對 Helvetica、Times 與 Courier 家族有保證;Symbol 映到 Symbol、ZapfDingbats 映到 Wingdings,是權宜而非匹配。上面的預檢也只看每頁 /Resources 字典裡的字型,看不到 form XObjects 內部引用的那些。碼仍然畫不出來時,繪製時的未解析字形追蹤會報告它——這比用眼睛盯縮圖強
耐用的修法在產生端。HotPDF 自己寫檔時 FontEmbedding 預設為 True,就算程式碼用 Helvetica 呼叫 SetFont,也會替換成內嵌的 Arial;內嵌文字走內嵌字型字形渲染器,跟上面的種種猜測無關。對進來的檔案,一個便宜的防護是:映射出的家族不在螢幕字型清單裡時,渲染前先警告:
// VCL:Screen.Fonts 列出已安裝家族名(Forms 單元)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
完整元件——包括頁面渲染、文字擷取與寫出端的字型子集化——見 HotPDF Delphi PDF component 產品頁