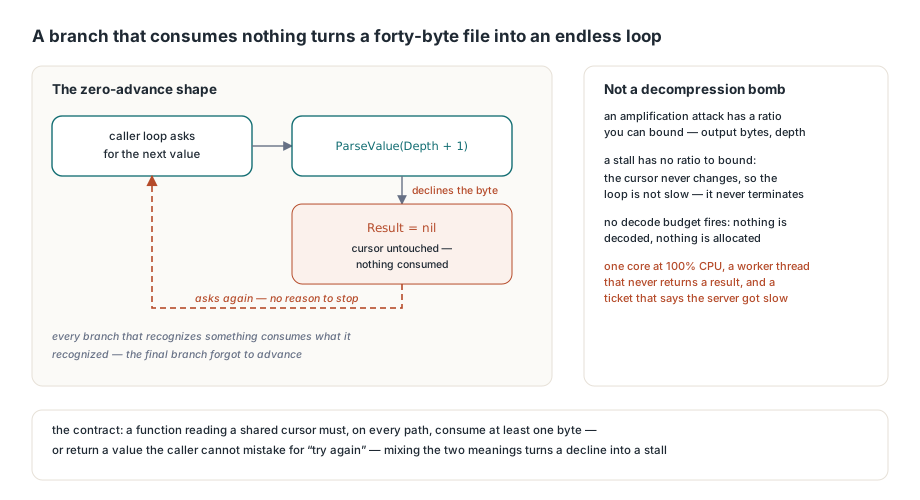
剖析器在某個分支讀了一個位元組、拒絕處理它、然後不移動游標就回傳時,就會卡在畸形 PDF 上。呼叫端的迴圈看不到進展,也沒有理由停下來,於是永遠空轉。HotPDF 曾在三個獨立剖析器裡帶著完全相同的缺陷出貨,全部都能從不到五十位元組的輸入觸發
這是一類值得單獨命名的拒絕服務,因為它看起來不像大家已經在防的那種。沒有解壓縮、沒有配置成長、沒有記憶體壓力可以觸發看門狗。程序只是坐在單一核心上,緩衝區裡捧著少數幾個位元組,CPU 百分之百。如果你讀了巢狀濾鏡放大與 PDF 炸彈之後加了解碼預算,那個預算在這裡不會觸發:沒有東西在解碼,也沒有東西在配置。不同的失敗,不同的修法
四十位元組的檔案為什麼比解壓縮炸彈更貴
因為成本與輸入大小完全無關。放大攻擊有你可以綁住的比值:封頂輸出位元組、封頂遞迴深度,最壞情況就變成有限。零前進迴圈沒有可以綁的比值。迴圈條件是永不改變的游標的函式,所以它不是慢,是不終止,上游任何以大小為基礎的限制都抓不到它。這也讓它在維運上特別難搞。當機會給你堆疊,記憶體不足給你一行日誌,而停滯的剖析器給你一個永遠不回傳結果的工作執行緒、一個因為下游沒人知道它開始了所以永不逾時的請求,以及一張寫著伺服器禮拜二變慢的單子。結構成因永遠是同一種形狀。tokenizer 或值剖析器有一串以目前位元組為鍵的分支。每個認出東西的分支都消耗它認出的東西。然後有一個最後分支,或鏈前的守衛,替沒人認領的位元組回傳,而作者把它當成錯誤路徑而不是掃描步驟來思考。錯誤路徑回傳。掃描步驟前進。當一個函式必須同時是兩者時,被忘記的往往是前進
物件剖析器:沒人消耗的兩個分隔符
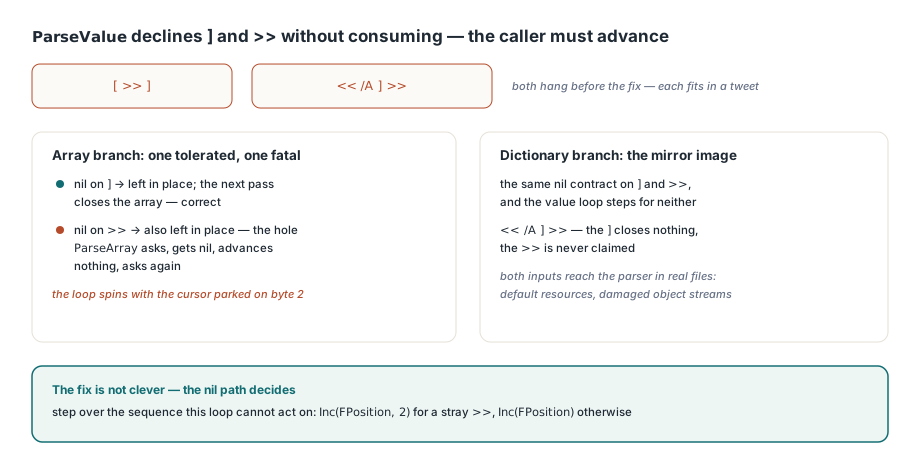
在 HPDFParser 裡,THPDFSpanObjectParser.ParseValue 一開始就拒絕兩種位元組序列。依 ISO 32000-1 第 7.3 節,值不能以 ] 或 >> 開頭,因為那些是關閉容器而不是開啟值,所以 ParseValue 對兩者都回傳 nil 而不消耗。這是正確的契約,把前進的全部責任都丟給呼叫端。陣列分支只做到一半:nil 結果時它檢查 ]、留在原位給下一輪關閉陣列,然後跳過其他一切——除了那個檢查碰巧寫成讓流浪的 >> 也留在原位。於是 [ >> ] 卡死,因為 ParseArray 要一個值、拿到 nil、什麼都沒前進、再問一次。字典分支有鏡像的洞,<< /A ] >> 以同樣的方式卡死。兩個輸入都夠合法到能到達剖析器,也夠短到塞進一則推文
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // 修復前,下面兩個呼叫都永遠不會回傳
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
修復不巧妙,而這正是重點:nil 路徑必須明確決定目前迴圈能處理兩個未消耗序列中的哪一個,然後跨過另一個
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue 對 ']' 與 '>>' 都回傳 nil 而不消耗。
  // ']' 在下一輪結束陣列,但陣列裡流浪的 '>>'
  // 必須跨過,否則剖析永遠不前進
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;還有一件事值得注意。THPDFSpanObjectParser.RecordError 只遞增 THPDFParserViewStatistics 的 ErrorCount;它不封頂任何東西。剖析器把 HPDFParserMaximumDepth 設成 64 來綁住巢狀,但對錯誤計數沒有同等上限,而一個沒人讀的計數器就是錯過的斷路器。就算前進恢復了,每位元組一個錯誤的輸入也會以值得提早退出的速率啃完大物件,而不是走完完整遍歷。每次剖析後檢查統計 record 的 Valid,把大的 ErrorCount 當成停止信任該物件的理由,而不只是診斷
CMap tokenizer 與 XFDF 讀取器裡同樣的形狀
HPDFCMapReader.NextToken 在它的回退分支帶著完全相同的缺陷。函式回傳 TCMapTok,用專屬分支處理 <、( 與 /;其他一切落到「讀到空白或分隔符為止」。當起始位元組本身就是 ISO 32000-1 第 7.2.2 節集合裡的分隔符,那個迴圈跑零次,token 空著回來,呼叫端再要同一個 token。六個可能落到那裡的字元裡,只有 [ 會被更早的 bfrange 處理攔截,所以 ToUnicode CMap 任何地方一個流浪的 )、>、]、{ 或 } 就足以卡死文字提取
// keyword 或數字:讀到空白或分隔符為止
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// 上面任何分支都沒認領的分隔符(流浪的 ')'、'>'、
// '['、']'、'{' 或 '}')會把 P 留在原位並回傳空
// keyword,所以呼叫端會永遠要同一個 token
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
XFDF 那一側有變體,起源不同、效果相同。HPDFXFDFXml.ParseElement 在頂端設 Result := P,此時 P 還指著開頭的 <,然後才遞增自己的區域游標,所以之後每個提早退出的路徑都回傳進場位置,除非先覆寫 Result。依 XML 1.0 第 2.8 節的文件型別宣告,或任何沒有可剖析標籤名稱的東西如 <1a>,會走一個從未更新 Result 的出口,子元素迴圈收到它傳進去的同一個位置。屬性迴圈還有三個這種洞,因為 ReadName、空白跳過與 = 處理全都拒絕既不是名稱字元、也不是空白、也不屬於 =、>、/ 的位元組,而且沒有一個消耗它。相鄰的 CDATA 修復是搬動責任而不是加守衛:依 XML 1.0 第 2.7 節,CDATA 區段以 < 開頭,所以子迴圈以前會把它交給 ParseElement,後者接著從區段內容裡讀出標籤名稱。在子迴圈裡用 IsCDATAStart 認出它、把位元組複製進文字緩衝區直到 IsCDATAEnd,才是正確的分工,而舊的跳過也短了一個位元組,因為這個標記從 ! 算起有八個位元組
比資料活得更久的宣告計數
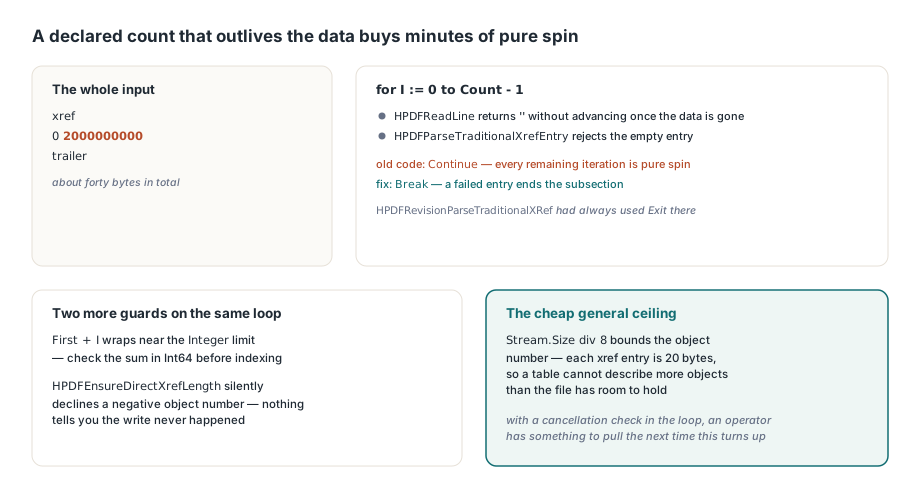
後來的版本從反方向浮出同樣的模式,而這是最可能出現在你自己程式碼裡的變體。依 ISO 32000-1 第 7.5.4 節,交互參照小節標頭是 first count 對,而 HotPDF 兩個傳統 xref 剖析器都對它迴圈 for I := 0 to Count - 1,條目剖析失敗時用 Continue 而不是 Break。這讀起來像是對一行壞資料的容忍。其實不是:HPDFReadLine 在資料耗盡後回傳空字串而不前進,HPDFParseTraditionalXrefEntry 立刻拒絕空條目,所以宣告計數剩下的每次疊代都是純空轉。算術不客氣——標頭 xref\n0 2000000000\ntrailer 加最小外殼大約四十位元組,買到忙碌核心的幾十秒,迴圈裡沒有任何取消檢查。線索就坐在同一個單元裡,因為 HPDFRevisionParseTraditionalXRef 在那個位置一直用 Exit。當兩個函式剖析同一種文法、卻對失敗條目是否結束小節意見不合時,其中一個就是停止收到修復的分叉,這跟在混合交互參照處理裡傳統表與串流描述同一批物件時出現的簽章相同
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // 宣告計數大於表格時,
  // 這裡原本會沒有資料可讀而空轉
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First 來自小節標頭,所以宣告起點接近 Integer 上限時
  // 總和會繞回,而成長 helper
  // 會默默拒絕負索引
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... 記錄條目 ...
end;
Break 之後的兩個界限屬於同一次修復。HPDFEnsureDirectXrefLength 拒絕為負物件編號成長陣列而且不吭聲,First + I 對接近 Integer 上限的宣告起點會繞回,所以負索引會到達下面的寫入。Stream.Size div 8 的物件編號上限是便宜的一般性答案,因為沒有傳統交互參照表能描述比檔案容納得了的更多的物件,任何宣稱相反的標頭都在描述不存在的檔案。如果你在手動修復損壞的表,同樣的推理從另一側也成立,那是診斷並修復手動編輯的 PDF筆記的領域
怎麼證明卡死修復真的有效
跑舊程式碼,而不是重讀它。停滯是少數可以用二進位訊號、不需要任何插樁就驗證修復的缺陷類別,因為程序不是回傳就是不回傳,而推論控制流正是最初製造這個 bug 的技能。機制值得複製。把改動單元的修復前版本抽到暫存目錄,然後用單元搜尋路徑把那個目錄放在真實程式庫前面編譯一個小探針:dcc32 -U<scratchdir>;<Lib> probe.dpr。編譯器對先找到的東西取舊原始碼,對其他一切取目前原始碼,所以單一探針二進位檔會用舊剖析器對上程式庫其餘部分。在逾時下跑它——四十秒很寬裕——把 exit code 124 當斷言。然後從暫存目錄一次撤回一個單元並重建。三個停滯都這樣重現,各自可歸因到特定單元,固定原始碼回到路徑後三個都回傳了,代價是每個單元一次編譯
動手前有兩個陷阱值得知道。單元搜尋路徑靜默地寬容:把 shell 的 Unix 風格路徑如 $PWD 交給 -U,編譯器一句話不說就忽略那個目錄,意思是你的探針是對著目前原始碼編譯的,為了錯誤的理由通過。先把路徑轉成原生 Windows 形式。第二個是暫存目錄不帶 include 檔,所以你還需要 -I<Lib> 給 HotPDF.inc,否則建置會以一種看起來像原始碼問題、其實是路徑問題的方式失敗。而且要對這個方法不給你什麼保持誠實:它確認特定輸入在特定建置上不再卡住,對你沒想到的輸入什麼都沒說。零前進缺陷要靠模糊測試或讀遍每個 tokenizer 的每個分支來發現,不是靠事後寫的回歸測試
你自己的剖析器要稽核什麼
可重用的規則是契約,不是檢查清單項目。任何從共用游標讀取的函式,在每一條路徑上,包括失敗路徑,都必須至少消耗一個位元組,或回傳呼叫端不會誤認成「再試一次」的值。把這兩種意義混進單一 nil 或單一空 token,正是把拒絕變成停滯的原因。所以依形狀稽核,而不是依症狀。找出每個終止條件依賴另一個函式擁有的游標的迴圈,問當那個函式拒絕目前位元組時會怎樣。找出每個寫成「讀到 X 為止」的回退分支,問當游標已經坐在 X 上時它做什麼。找出每個以來自檔案而不是來自資料的計數為界的迴圈,讓失敗的元素結束迴圈而不是跳過一次疊代。同一種文法在兩處剖析時,把它們 diff 一下,因為其中一個會收到另一個沒收到的修復。並在每個可能跑呼叫端指定次數疊代的迴圈裡放取消檢查,讓下一個這類問題出現在生產環境時,操作員有東西可以拉
這裡描述的剖析器在目前的 HotPDF Delphi Component 裡出貨,給 Delphi 與 C++Builder 用,統計 record 與深度上限都暴露出來,你自己的加固可以建立在它們之上