假設一份 400 頁的報告內嵌一個 2 MB 的字型,若讓每一頁為它引用到的所有東西付帳,算出來的總額會很奇怪:明明檔案在磁碟上可能只有 30 MB,各頁加總的字型卻有 800 MB。改成把字型平均分攤,每頁只攤到約 5 KB,於是每個東西看起來都不貴,記憶體卻像憑空冒出來。兩種數字都沒回答真正的問題:某個物件若消失,到底能釋放多少位元組
這個數字在堆積分析裡有名字,叫保留大小(retained size),而圖論有乾淨的算法。物件記帳到它的主導者頭上——也就是所有從根出發的路徑都必經的最近物件。共用的物件一路上浮,直到抵達真正擁有它的節點;獨占的原地不動,總和因而不會重複計算
HotPDF 的淺層大小、保留大小與主導者規則
HotPDF 透過 THotPDF.BuildLoadedObjectDependencyGraph 為已載入的文件算出這件事。呼叫會為每個已載入的間接物件回傳一個 THPDFObjectDependencyNode、為每個間接參照回傳一個 THPDFObjectDependencyEdge,接著以文件 Catalog——trailer 的 /Root 項目所指名的物件(ISO 32000-1 §7.7.2)——為根執行主導者分析。每個節點帶兩個大小:EstimatedShallowBytes 是物件自身的成本,EstimatedRetainedBytes 則是自身成本加上它所支配的每個物件的淺層成本
回到那個字型。每一頁都引用它,所以沒有任何單一頁面支配它;各條路徑要到這些頁面上方的頁面樹節點才會收斂,在扁平樹裡那就是根 /Pages 物件。字型的 2 MB 就記在這裡,再往上併入 Catalog。反過來,只畫在第 12 頁、別處都不用的影像 XObject,通往它的每條路徑都經過第 12 頁,於是第 12 頁的保留大小含整個影像。所以保留量排行榜首的,正是刪掉就能真正騰出記憶體的物件
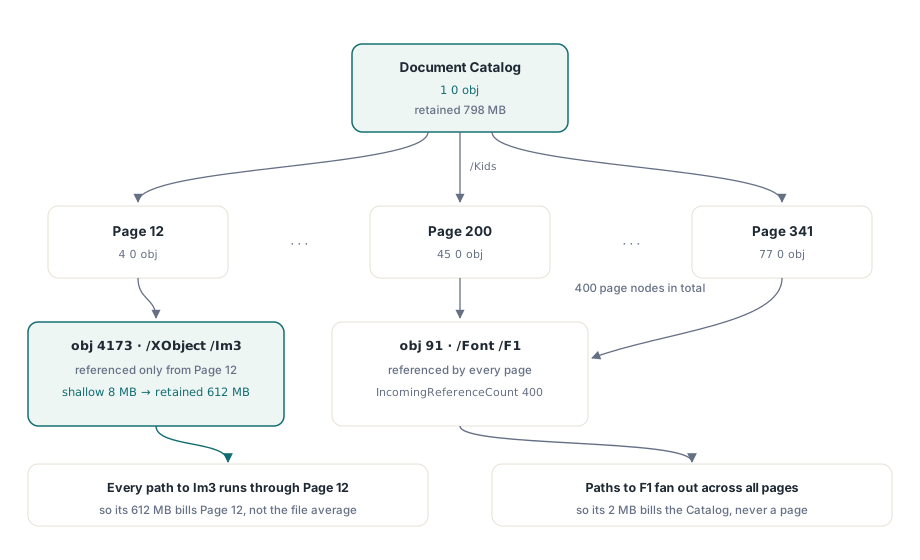
同一套算術還附贈一個交叉驗證。THPDFObjectDependencyGraphInfo.CatalogRetainedBytes 等於所有可從 Catalog 抵達之物件的淺層大小總和,TotalEstimatedBytes 則是所有已載入物件的淺層大小總和,不論可達與否。兩者的差距,就是文件已經不再指向、卻還握著的記憶體
執行依賴圖並解讀失敗結果
只有整個分析跑完,方法才回傳 True,這個回傳值就是你要檢查的東西。回傳 False 時 info 記錄仍有內容,但那些陣列不該拿去出報告。物件數超過 MaxObjects(預設 250,000)時,方法在建立任何節點之前就停下,並把 ObjectCount 設成上限加一,讓你知道上限太小,而不是告訴你文件有多大。掃描途中若撞上邊數預算(預設 2,000,000)或直接物件的 256 層巢狀上限,節點回來時淺層大小只有部分,保留大小與可達性則完全沒有
uses
  SysUtils, HPDFDoc;

procedure ProfileLoadedPdf(const FileName: string);
var
  Pdf: THotPDF;
  Nodes: THPDFObjectDependencyNodeArray;
  Edges: THPDFObjectDependencyEdgeArray;
  Info: THPDFObjectDependencyGraphInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile 回傳頁數;0 代表載入失敗
    if Pdf.LoadFromFile(FileName) = 0 then
      Exit;

    // 離線鑑識跑分析時調高的上限
    if not Pdf.BuildLoadedObjectDependencyGraph(Nodes, Edges, Info,
      1000000, 8000000) then
    begin
      // Log 是你自己的記錄常式
      Log(Format('graph incomplete: %s (limit %s, invalid %s, objects %d)',
        [string(Info.Diagnostic), BoolToStr(Info.LimitExceeded, True),
         BoolToStr(Info.InvalidObjectGraph, True), Info.ObjectCount]));
      Exit; // 別拿不完整的節點陣列去排名或加總
    end;

    Log(Format('%d objects, %d edges (%d unresolved), %d reachable',
      [Info.ObjectCount, Info.EdgeCount, Info.UnresolvedReferenceCount,
       Info.ReachableObjectCount]));
    Log(Format('estimated %d bytes, Catalog retains %d, unreachable %d',
      [Info.TotalEstimatedBytes, Info.CatalogRetainedBytes,
       Info.TotalEstimatedBytes - Info.CatalogRetainedBytes]));

    LogTopRetained(Nodes, Edges, 10);
  finally
    Pdf.Free;
  end;
end;失敗分支裡還有兩個旗標值得看。InvalidObjectGraph 在已載入物件裡找不到 Catalog 物件,或直接物件被發現包含自己時會設立——後者只出現在畸形輸入。LimitExceeded 也涵蓋主導者分析跑滿 128 輪仍未收斂的情況。Diagnostic 對每種情況給一行說明。若傳給 MaxObjects 零或負值,或給 MaxEdges 負值,則改為拋出 EArgumentOutOfRangeException,而不是回傳 False
呼叫因上限而失敗時,把陣列丟掉,用更大的界限重跑一次。部分的淺層大小在日誌裡看起來頭頭是道,錯的方式恰好讓人追錯物件。界限之所以存在,是因為圖本身有成本:每條邊都存一個 Path 字串,八百萬條邊的跑法會在受測文件之外再多配八百萬個小字串。這分析該放在有人刻意觸發的診斷路徑上
EstimatedShallowBytes 實際在數什麼?
EstimatedShallowBytes 估算的是常駐記憶體,不是檔案裡的位元組。對每個物件,它加上解析後物件及其直接子系的實體大小、字典與陣列清單佔用的槽位、每個鍵、名稱與字串的長度,以及串流 payload 若在 RAM 裡——記憶體串流,或已讀進記憶體的延遲載入串流——時的 payload 本體。位元組還留在來源檔裡、或已溢出到暫存檔的串流,只計其物件開銷
這有實際後果。掃描為重的檔案剛載入完就分析,影像的保留大小會顯得溫和,因為還沒有任何東西解碼過它們。在讓行程長大的那一步之後(渲染、文字擷取、合併)再跑圖,已具象化的串流就會帶著真實重量現身。要可重現的檢查,就把同一個檔案分析兩次:一次緊跟 LoadFromFile,一次在昂貴操作之後,再比較兩份榜首
ObjectType 很粗。它回報的是 PDF 值型別,otStream、otDictionary 諸如此類,所以影像、字型程式與頁面內容串流全都讀作 otStream。角色要從進來的邊上看。THPDFObjectDependencyEdge.Path 記錄參照在來源物件裡的哪裡被找到,以 $ 開頭,字典項目記 /Key、陣列元素記 [n]、串流的字典記 /dictionary。從頁面出發的 $/Resources/XObject/Im3,或從獨立資源字典出發的 $/XObject/Im3,代表這物件被當成名叫 Im3 的 XObject 使用;從字型描述器來的 $/FontFile2 代表內嵌的 TrueType 程式;$/Contents[0] 代表頁面內容
// 你自己的輔助函式,不是庫的一部分:按保留大小排出前 Count 名節點,
// 並為每個節點印出一條連入參照的路徑
procedure LogTopRetained(const Nodes: THPDFObjectDependencyNodeArray;
  const Edges: THPDFObjectDependencyEdgeArray; Count: Integer);
var
  Taken: array of Boolean;
  I, J, Best: Integer;
  Via: AnsiString;
begin
  SetLength(Taken, Length(Nodes));
  for I := 1 to Count do
  begin
    Best := -1;
    for J := 0 to High(Nodes) do
      if (not Taken[J]) and ((Best < 0) or
         (Nodes[J].EstimatedRetainedBytes >
          Nodes[Best].EstimatedRetainedBytes)) then
        Best := J;
    if Best < 0 then
      Break;
    Taken[Best] := True;

    Via := '(no incoming reference)';
    for J := 0 to High(Edges) do
      if Edges[J].Resolved and
         (Edges[J].TargetObjectNumber = Nodes[Best].ObjectNumber) and
         (Edges[J].TargetGenerationNumber = Nodes[Best].GenerationNumber) then
      begin
        Via := Edges[J].Path;
        Break;
      end;

    Log(Format('%d %d obj  shallow %d  retained %d  refs in %d  via %s',
      [Nodes[Best].ObjectNumber, Nodes[Best].GenerationNumber,
       Nodes[Best].EstimatedShallowBytes, Nodes[Best].EstimatedRetainedBytes,
       Nodes[Best].IncomingReferenceCount, string(Via)]));
  end;
end;
多數物件看一條連入路徑就足以分類。共用物件用 IncomingReferenceCount 看有幾個參照,主導者分析之後誰擁有它則由 ImmediateDominatorObjectNumber 及其世代號回答。Catalog 以及所有 Catalog 抵達不了的物件,該欄位是 -1。Resolved 旗標為 False 的邊指向未載入的物件號,這些計入 UnresolvedReferenceCount;檔案其他部分都健康時這個數字偏高,通常代表交叉參照區段受損
不可達物件從哪裡來?
ReachableFromCatalog 為 False 的節點已載入、也佔記憶體,但從 Catalog 出發沒有任何參照鏈能到它,文件結構裡也沒有東西會把檢視器帶到它面前。它的保留大小等於淺層大小,因為主導者分析只在可達物件上跑。因此把不可達節點的 EstimatedRetainedBytes 加總,答案會與 TotalEstimatedBytes - CatalogRetainedBytes 一致
增量更新是常見來源,但不是大家直覺想的那種。當後面的修訂版重新定義物件 2120,最新的交叉參照項目勝出,舊定義根本不會被載入,所以同一物件號被取代的副本不會出現在圖裡。會出現的,是後來的修訂版單純不再參照的物件:從改寫過的 /Annots 陣列裡拿掉的註解、換了新物件號的影像、從 AcroForm 移除的表單欄位。ISO 32000-1 §7.5.6 沒有任何條文要求更新把這些項目標記為空閒,只要交叉參照資料仍把它們列為使用中,載入器就當它們是活物件。物件串流與增量更新一文講過修訂版如何疊加
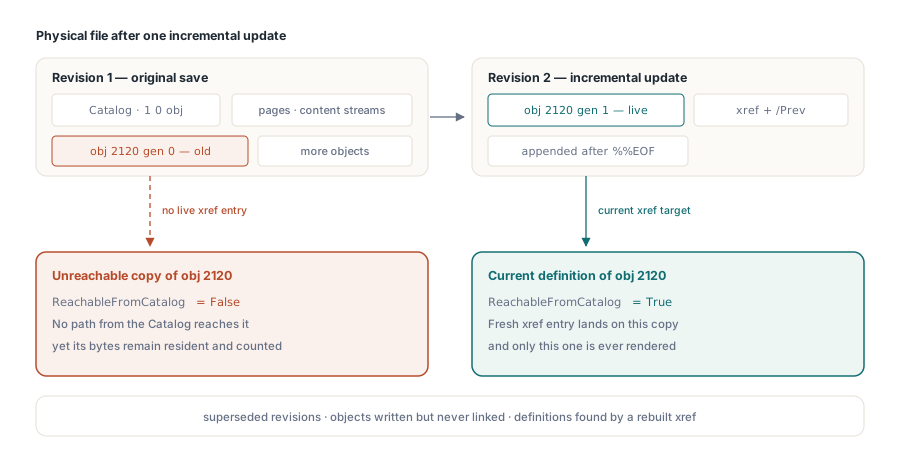
另外兩個來源:一是生產器寫出物件卻沒把它們連結起來,二是損壞檔案的交叉參照資料得靠掃描重建,過程可能撿到無人參照的物件定義。當估算總量有很大一部分落在不可達節點上,與其再追加一個修訂版,不如把檔案乾淨重寫,而圖會給你足以說服人的位元組數,去正當化較慢的存檔
抓著記憶體不放的,會不會是剖析器?
先別怪文件,看看載入本身表現如何。有兩個呼叫描述的是剖析器而非內容,而且兩者都在每次 LoadFromFile 或 LoadFromStream 開始時歸零,所以永遠描述最近一次載入
GetLastParserArenaStatistics 會填好一份 THPDFParserArenaStatistics 記錄,對應剖析期間存放短命 token 與緩衝區的區塊 arena。區塊為 64 KiB(BlockSize),超過一個區塊的配置會拿到與自身等大的專屬區塊。AllocationCount 減 ReusedAllocationCount 等於 BlockAllocationCount,即 arena 向記憶體管理器要新區塊的次數。區塊在 THotPDF 實體的整個生命週期內保留,銷毀時才釋放。若同一實體處理整批檔案,RetainedBytes 大致反映該批中任一檔案所需的最大工作集,這也解釋了為何有個高原期一直撐到元件釋放。TemporaryObjectElisionCount 則計數直接讀進 arena、而非另建臨時名稱物件的字典鍵
GetDocumentStringInternStatistics 描述每份文件一個的池,負責去重 PDF 名稱、內容串流運算子與短字串。1 到 64 位元組的字串符合資格。池最多容納 65,536 個條目與 4 MiB,這些上限會以 MaxStringLength、MaxEntryCount 與 MaxRetainedBytes 回傳到記錄裡。空字串、超過 64 位元組、或池滿時新出現的字串,都計入 BypassCount 並當成普通字串保留。因此會生成大量唯一名稱的檔案,成本大約等於沒有這個池時的成本,不會更多
var
  Arena: THPDFParserArenaStatistics;
  Intern: THPDFDocumentStringInternStatistics;
begin
  if Pdf.GetLastParserArenaStatistics(Arena) then
    Log(Format('arena: %d blocks, %d bytes held, peak %d, ' +
      '%d new blocks for %d allocations, %d tokens',
      [Arena.RetainedBlockCount, Arena.RetainedBytes, Arena.PeakUsedBytes,
       Arena.BlockAllocationCount, Arena.AllocationCount, Arena.TokenCount]));

  if Pdf.GetDocumentStringInternStatistics(Intern) then
  begin
    Log(Format('intern: %d of %d requests hit, %d bypassed, %d bytes reused',
      [Intern.HitCount, Intern.RequestCount, Intern.BypassCount,
       Intern.ReusedBytes]));
    // 你自己的檢查,不是庫的呼叫:標記已撞上限的池
    if (Intern.EntryCount >= Intern.MaxEntryCount) or
       (Intern.RetainedBytes + Intern.MaxStringLength >
        Intern.MaxRetainedBytes) then
      Log('intern pool at its cap: later strings were not deduplicated');
  end;
end;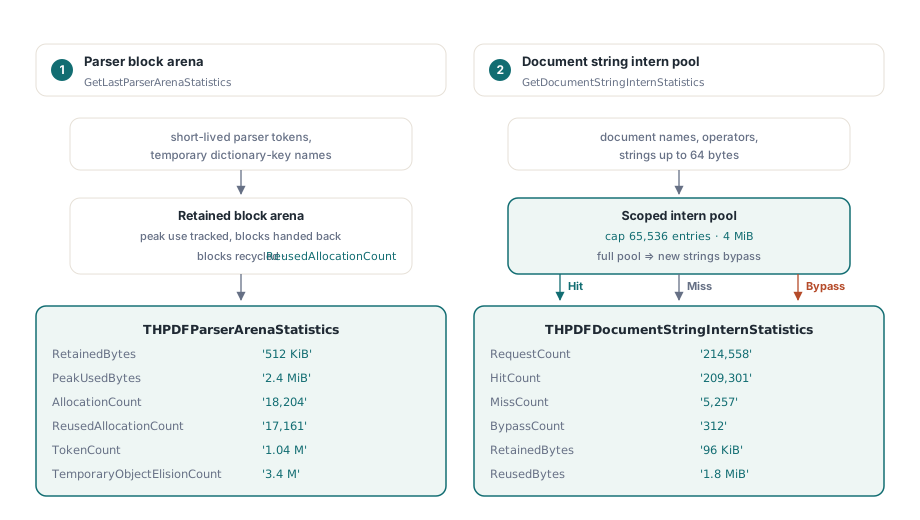
典型的 PDF 會重複一小組名稱與運算子字彙,所以 HitCount 貼著 RequestCount,ReusedBytes 隨頁數增長。不大的檔案卻出現逼近 RequestCount 的 BypassCount,就不尋常了。在處理不可信上傳的接入路徑上,把它記進日誌
記憶體投訴的排查順序
從 CatalogRetainedBytes 開始。若它接近你在行程裡量到的增長,記憶體就在文件裡,保留量榜首會點名是誰。若遠低於此,記憶體住在圖量不到的地方,例如自己的快取、渲染出的點陣圖或剖析器 arena,下一步就是讀 arena 記錄
- 按
EstimatedRetainedBytes排名節點,並讀前十名的連入Path。榜首的 XObject 目標多半指向掃描為重的內容,降取樣有回報;/FontFile、/FontFile2或/FontFile3目標指向整組內嵌的字型程式,其實用子集就夠;大的/Contents串流多半來自生成式向量輸出,例如地圖或 CAD 匯出 - 用
TotalEstimatedBytes減CatalogRetainedBytes。差值很大就是受困物件,該在存檔步驟下手 - 最後才讀 arena 與 intern 記錄。它們很少解釋得了 GB 級的量,但能解釋文件全關之後行程依然肥大的現象
按這個順序跑。第一步就能解決大多數投訴;而對非常大的文件,結構性答案往往是不再把整個物件圖握在手裡,直接檔案 API 工作流程正是為此而生
這三個診斷都是普通方法呼叫、回傳普通記錄,所以能直接接上 Delphi 或 C++Builder 應用程式既有的日誌或遙測管線。HotPDF 以附完整原始碼的原生 VCL 元件出貨;文件與試用版下載在HotPDF Delphi PDF component 頁面