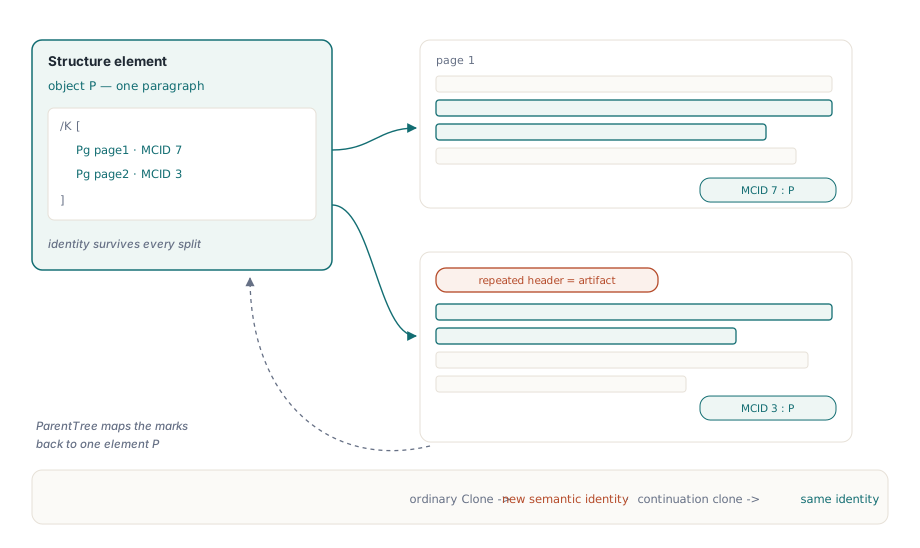
一個從第 4 頁底部開始、在第 5 頁頂部結束的段落,對讀者來說就是同一個段落。但在標記化 PDF 裡,它分屬兩個內容串流,而每一頁都各自為自己的標記內容序列編號,所以結構樹需要單一一個 P 元素,其 /K 陣列同時指向(比方說)第 4 頁的 MCID 7 與第 5 頁的 MCID 3。如果先用座標程式碼把頁面畫出來、事後再把標記硬補上去,無障礙檢查工具裡的標籤樹通常會把原本一個段落顯示成兩個,外加每張續頁表格的資料中間都夾著一組重複的欄位標題
座標式做法還有第二種代價,而且來得更早。報表的第一版能動。接著客戶地址長成三行、在地化後的標題換了行、表格多了四十列,於是那個點以下的所有 y 座標全錯了。換頁檢查最後散落在業務邏輯各處,而一段只認得 x 和 y 的程式碼,等到兩年後無障礙需求找上門時,根本不知道段落從哪裡開始
在 Delphi 中建置 HotPDF 版面配置樹
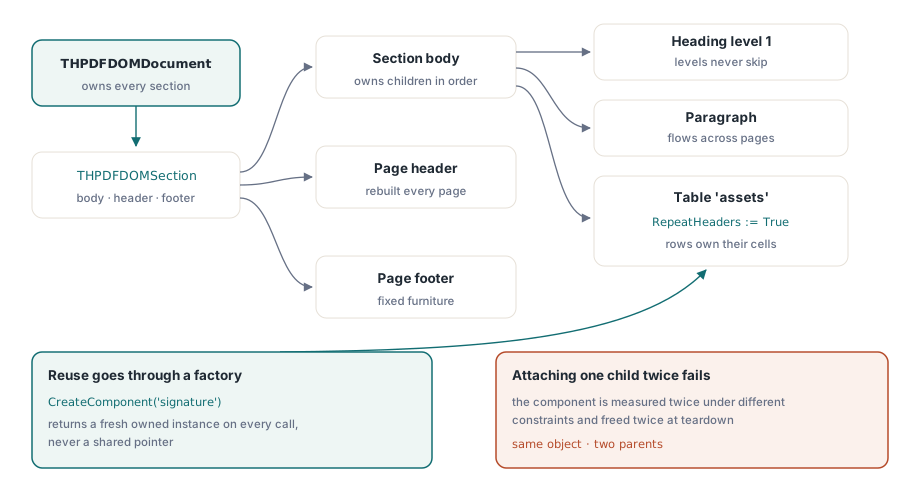
HotPDF 用 HPDFLayoutDOM 單元裡的宣告式版面配置樹一次回答這兩個問題。一個 THPDFDOMDocument 持有多個區段;每個 THPDFDOMSection 有自己的頁面尺寸、邊界、可選的頁首與頁尾,以及一個 Body 堆疊,你把文字、標題、間隔、清單、影像、容器與表格加進去。樹裡沒有任何東西帶 y 座標。THPDFDOMRenderer 量測這棵樹、決定換頁位置、在每一頁畫上頁首頁尾,而且因為 GenerateStructure 預設為 True,它會一邊轉譯一邊寫出結構樹
樹裡的所有權很嚴格。文件擁有它的區段,區段擁有它的主體、頁首與頁尾,堆疊、容器與表格擁有各自的子項,所以 Section.Body.Add(Table) 一呼叫,表格就徹底交出去了。一個同時掛在兩個父節點下的元件,會在不同的限制條件下被量測兩次,並在拆卸時被釋放兩次。因此像簽名區塊這類重複出現的部件,要透過 Clone、SetHeaderClone / SetFooterClone,或是用 RegisterComponent 註冊的工廠來取得,之後每次呼叫 CreateComponent('signature') 都會回傳一個全新的實例
uses
  SysUtils, HPDFDoc, HPDFLayoutDOM;

type
  TAssetRow = record                    // 你自己的資料型別
    Name, ServiceDate, Status: WideString;
  end;

function BuildMaintenanceReport(const Assets: array of TAssetRow): THPDFDOMDocument;
var
  Doc: THPDFDOMDocument;
  Section: THPDFDOMSection;
  Heading: THPDFDOMText;
  Table: THPDFDOMTable;
  Row: THPDFDOMTableRow;
  I: Integer;
begin
  Doc := THPDFDOMDocument.Create;       // GenerateStructure = True,Language = 'en-US'
  try
    Section := Doc.AddSection;          // 預設 A4 直向,邊界 36 pt
    Section.MarginLeft := 56;
    Section.MarginRight := 56;
    Section.Style.FontName := 'Helvetica';
    Section.Style.FontSize := 10;
    Section.Style.LineHeight := 13;
    Section.Body.Style.Spacing := 6;    // 主體子項之間的間距
    Section.Footer := THPDFDOMText.Create('Plant maintenance - internal');

    Heading := Section.Body.AddHeading('Annual maintenance report', 1);
    Heading.Style.FontSize := 18;
    Heading.Style.LineHeight := 22;     // LineHeight 不會跟著 FontSize 變動
    Section.Body.AddText('Every asset inspected during the reporting ' +
      'period is listed below, grouped by site.');

    Table := THPDFDOMTable.Create('assets');  // RepeatHeaders 預設為 True
    Table.AddColumn(3);                 // 權重,不是以點為單位的寬度
    Table.AddColumn(1);
    Table.AddColumn(1);
    Row := Table.AddRow(18, True);      // 標題列必須排在最前面
    Row[0].Text := 'Asset';
    Row[1].Text := 'Last service';
    Row[2].Text := 'Status';
    for I := 0 to High(Assets) do
    begin
      Row := Table.AddRow(16);
      Row[0].Text := Assets[I].Name;
      Row[1].Text := Assets[I].ServiceDate;
      Row[2].Text := Assets[I].Status;
    end;
    Section.Body.Add(Table);            // 從這裡開始表格歸主體所有
    Result := Doc;
  except
    Doc.Free;
    raise;
  end;
end;這段程式裡有兩個預設值常讓人中招。LineHeight 除非樣式鏈中有人設定,否則一律解析為 12 點,不管 FontSize 是多少,所以一個沒有自訂 LineHeight 的 18 pt 標題會拿到 12 pt 的行高,然後跟下一行疊在一起。另外,表格列的高度就是傳給 AddRow 的那個數值:儲存格文字只會輸出成一行,所以請依你選的字型來決定列高
Render 會自己開啟並關閉文件
THPDFDOMRenderer.Render(Doc, Pdf) 會對目標呼叫 BeginDoc、轉譯每一個區段,並在回傳前呼叫 EndDoc。不要再用你自己的 BeginDoc / EndDoc 把它包一層。凡是必須在文件開始前設定好的東西,都先設在 THotPDF 實例上:FileName、Title,以及如果輸出要宣告符合 PDF/UA 的話,還有 PDFUACompliance。結構產生開啟時,Render 也會順帶打開 EnableTaggedPDF,並在你沒填 Pdf.Lang 的情況下把 Doc.Language 複製過去
var
  Doc: THPDFDOMDocument;
  Pdf: THotPDF;
  Renderer: THPDFDOMRenderer;
  Stats: THPDFDOMRenderStatistics;
begin
  Doc := BuildMaintenanceReport(Assets);
  Pdf := THotPDF.Create(nil);
  Renderer := THPDFDOMRenderer.Create;
  try
    Pdf.FileName := 'maintenance-report.pdf';
    Pdf.Title := 'Annual maintenance report';
    Pdf.PDFUACompliance := True;        // 同時啟用圖形替代文字檢查
    // 這裡不呼叫 BeginDoc / EndDoc:Render 會自己開啟並關閉文件
    Stats := Renderer.Render(Doc, Pdf);

    Writeln(Format('%d page(s), %d placement(s), %d split(s)',
      [Stats.PageCount, Stats.PlacementCount, Stats.SplitCount]));
    Writeln(Format('structure elements=%d marked content=%d artifacts=%d',
      [Stats.StructureElementCount, Stats.MarkedContentCount,
       Stats.ArtifactCount]));
    Writeln(Format('header draws=%d footer draws=%d deepest chain=%d',
      [Stats.HeaderDrawCount, Stats.FooterDrawCount,
       Stats.MaximumContinuationDepth]));
  finally
    Renderer.Free;
    Doc.Free;
    Pdf.Free;
  end;
end;每次執行都把統計紀錄記下來,因為它能揭露那些從不丟出例外的樣板退化。SplitCount 在樣板變更後暴增,通常代表某個元件量出來的高度,已經比它原本塞得下的空間還高。MaximumContinuationDepth 逐步攀升,指向某個元件的 Split 每頁搬動的內容太少。ArtifactCount 涵蓋頁首頁尾、表格預設 0.5 pt 外框之類的裝飾邊線,以及重複的標題列,所以拿同一份樣板前後幾次執行的數字互相比較即可,別去對照手算出來的目標值
長表格如何分頁,卻不必每頁都複製自己?
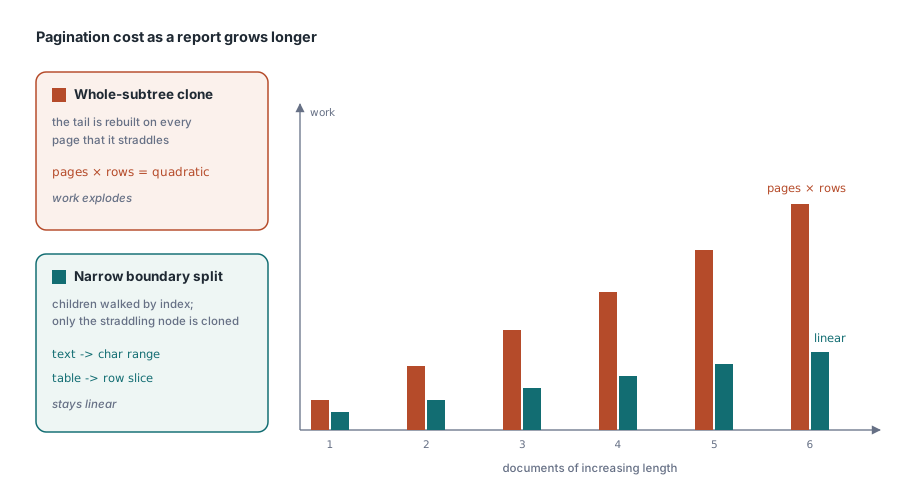
轉譯器只拆分真正橫跨頁面邊界的東西。最天真的分頁法是把裝不下的部分整個複製一份帶到下一頁;對一張有 10,000 列的表格來說,這等於每頁都要複製一次剩餘的列,把線性工作變成二次方工作。HotPDF 依索引走訪主體子項,從不複製整個區段或主體。跨越頁面邊界的巢狀堆疊或容器,只有受影響的子樹會被複製,而兩種重量級的葉節點類型帶的則是游標,不是副本
續接的段落就是一個指向原始文字的參照,加上它還欠著的字元範圍,而且會沿用已針對該寬度算好的斷行結果。續接的表格則是一個指向原始表格的參照,加上尚待放置的那段列切片。一個 300 行的段落,不管斷一次還是斷五次,成本都一樣
放置本身走的是公開的 THotPDF.PlaceLayoutElement。它用剩餘的主體高度量測元件,裝得下就整個畫出來,裝不下就要求元件 Split,重新量測放得下的那一半、畫出來,再把剩餘部分當成溢位物件回傳,由轉譯器帶到新的一頁。Measure 絕不能畫任何東西;同一次放置它可能會被執行好幾次。DOM 轉譯器則在這個程序之上,再加上頁面裝飾元素、子項之間的間距,以及是否另起新頁的決策
為什麼一列標題就能讓整個轉譯停下來?
重複的表格標題有兩條規則,兩條都是為了避免報表產生出沒有資料的頁面。標題列必須構成最前面那一段連續的列:在任何內容列之後呼叫 AddRow(Height, True),會丟出 EInvalidOpException,訊息是 "Table header rows must precede body rows"。而表格的第一次拆分必須容得下所有標題列加上至少一列內容列。一張會讓標題孤零零留在頁尾的表格,會整張改到下一頁開始
第二條規則有個硬邊界。如果標題列加一列內容列連空白頁都塞不下,那就沒有任何一頁能讓這張表格開始,Render 會丟出 "Layout component ... cannot fit an empty body page",並附上元件路徑,例如 Sections[0]/Body/Items[2]/assets。這才是值得擁有的行為。一個抱著「下一頁也許寬敞一點」的希望不斷加頁的版面引擎,會把一個過高的標題變成塞滿磁碟的迴圈
自訂元件也享有同樣的保護。繼承 THPDFDOMComponent,實作 Clone、Measure、Draw 與 Split,轉譯器就會計算每個主體子項產生了多少延續段。一旦超過 THPDFDOMRenderer.MaximumContinuationDepth(預設 100,000),轉譯會以 "exceeded the continuation depth limit" 停下。一個老是回傳等效尾段、永遠沒有進展的 Split,會帶著元件路徑失敗,而不是一路跑到磁碟塞滿
在延續頁上,標題列會重新繪製一次,但是包在 /Artifact 標記內容序列裡,結構樹中則只保留原始的那一個 TR。因此文字擷取不會在資料列之間插入一列重複的標題,輔助科技也不會在表格中途再把欄位標題唸一遍。每個標題儲存格都標記為 TH,並帶有 /Scope /Column 屬性
一個邏輯段落、多個頁面片段
被拆開的段落仍然是同一個 P 結構元素。每個可見片段都在自己所在的頁面上開啟一段新的標記內容序列,HotPDF 會在該元素的 /K 陣列中附加一個標記內容參照字典 << /Type /MCR /Pg page /MCID n >>,並把這個 MCID 登記到該頁的 ParentTree 項目中,指回同一個元素。這正是 ISO 32000-1 §14.7.4 針對跨頁內容項目所描述的安排,也是標籤樹檢視能在頁面顯示成兩塊時,仍只呈現一個段落的原因
語意身分正是延續複本與你自己做的複本行為不同的原因。呼叫 Clone 的意思是「新的邏輯內容」,結果在繪製時會得到一個新的結構元素。分頁過程中產生的複本則繼承它們所延續的那個元件的身分,所以一個拆到三頁的堆疊仍然只產生一個 Div,一個拆到兩頁的清單仍然只產生一個 L。頁首與頁尾走的是另一條路:它們在每一頁都被包成 /Artifact << /Type /Pagination /Subtype /Header >>(或 /Footer),從不進入結構樹
樹在轉譯時就檢查的結構規則
開啟 GenerateStructure 後,轉譯器會直接拒絕那些日後會被 PDF/UA 驗證打回票的結構。第一個標題必須是 H1,後續標題不得跳級,所以 H1 之後直接接 H3 會丟出 "Semantic heading levels cannot skip an intermediate level"。LI 需要 L 作為父節點,Lbl 與 LBody 需要 LI,TR 需要表格或列群組,TH / TD 則需要 TR。目標設定了 PDFUACompliance 時,沒有替代文字的 Figure 同樣會被拒絕。每一項違規都會讓 Render 以例外停下
var
  List: THPDFDOMList;
  Bmp: TBitmap;                         // Vcl.Graphics
begin
  Section.Body.AddHeading('Findings', 2);     // H1 已先出現,所以 H2 合法

  List := THPDFDOMList.Create('Decimal');     // 標記為 L,ListNumbering /Decimal
  List.AddItem('1.', 'Replace the intake filter on pump P-14');
  List.AddItem('2.', 'Re-torque the flange bolts on line 3');
  Section.Body.Add(List);                     // AddItem 會建立 LI、Lbl 與 LBody

  Bmp := TBitmap.Create;
  try
    Bmp.LoadFromFile('site-plan.bmp');
    // 影像會複製一份圖形;在 PDFUACompliance 下空白的替代文字會失敗
    Section.Body.Add(THPDFDOMImage.Create(Bmp, 240, 160,
      'Site plan of plant 3 with the inspected pumps circled'));
  finally
    Bmp.Free;
  end;
end;
在轉譯過程中檢查,是這些規則最合適的位置,理由就在時機。一個等檔案寫完才回報缺少替代文字的驗證工具,只能告訴你一批 10,000 份對帳單得重新產生;而 Render 期間丟出的例外會點名是哪條規則失敗,此時產生它的那筆資料紀錄還在作用範圍內。正式的合規檢查仍然該留在流程中,而且因為 Render 回傳後文件的物件仍可讀取,它可以馬上接著跑。PDF/A、PDF/X 與 PDF/UA 驗證 一文涵蓋了那個步驟,結構順序與文字擷取 則說明標籤樹如何決定擷取工具讀回來的內容
什麼時候該繼續手動繪製
這棵樹畫在與直接 API 相同的 THPDFPage 物件上。由於 Render 從 BeginDoc 到 EndDoc 全程掌握文件,像簽名影像這種手動定位的圖案應該放進樹裡:自訂元件的 Draw 會收到頁面與它的邊界,可以在那裡呼叫一般的頁面方法。頁面的關閉仍由 AddPage 與 EndDoc 負責,所以在 THotPDF 實例上設定 ImmediateFlushLayout 之後,完成的頁面會隨著轉譯進度即時寫出,轉譯器手上不會留著任何已完成的頁面;此時記憶體用量取決於尚未結束的延續段、字型資源與文件的物件圖
DOM 文字元件以每個字元平均前進量約為 0.55 × 字型大小的估計值來斷行,並讓每一行都使用解析後的 LineHeight。這讓量測既便宜又在每台機器上結果一致,對資料驅動的報表來說綽綽有餘。字形較寬的文字,例如全大寫、粗體段落或 CJK 文字,實際會比估計值寬,所以欄寬要留點餘裕,並拿最長的真實字串把版面測一次。需要精確字形度量、同一行混用多種字型,或者段落要左右對齊的排版頁面,更適合直接使用文字 API;文字對齊排版 一文走過那條路徑,而如果表格分頁是唯一的痛點,在 PDF 中產生表格 是改動較小的選擇
版面配置樹、它的轉譯器、本文描述的標記機制與直接繪圖 API,全都包在同一個適用於 Delphi 與 C++Builder 的元件裡;版本與完整功能清單請見 HotPDF Delphi PDF 元件頁面