HotPDF 內嵌帶 CFF2 外框的 OpenType 可變字型時,會在選定的軸值上把它們轉換成 PDF 閱讀器本來就懂的 CID-keyed CFF1 字型程式。透過 RegisterUnicodeTTF 註冊的普通原生文字走字型自己的 cmap 與 hmtx 表,寫出器在 /FontFile3 下以 /Subtype /CIDFontType0C 內嵌轉換後的程式,讓每個 CID 都等於原始字形 ID
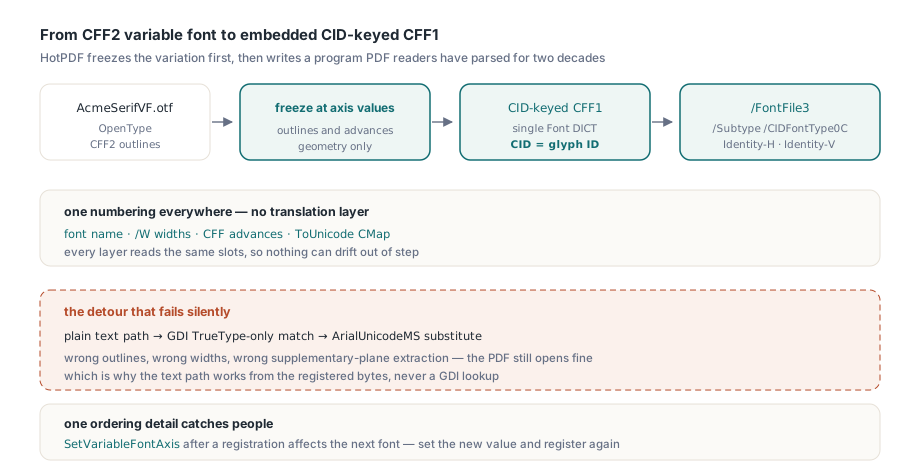
那條看起來顯而易見的路值得一講,因為它會無聲地失敗。解析並快取 CFF2 表之後,讓普通文字路徑透過 Windows GDI 以純 TrueType 條件解析字型:GDI 完全不知道怎麼處理 CFF2 外框,會悄悄換成 ArialUnicodeMS。下游任何讀到替換字型的東西都拿到錯的外框、錯的寬度,補充平面字元的擷取也是錯的;PDF 照樣打得開,只是排的字型不是你指定的那個——這正是文字路徑必須從註冊的位元組出發、不走 GDI 查找的原因
為什麼 PDF 不能直接內嵌 CFF2 字型?
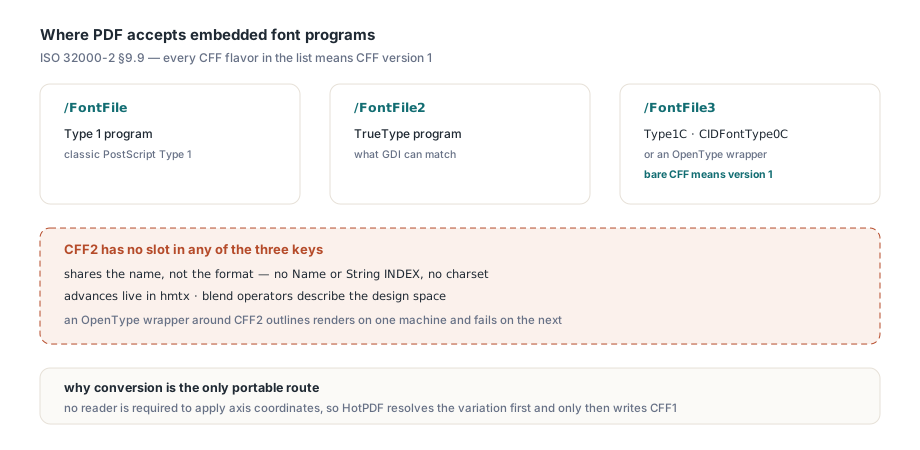
PDF 沒有給 CFF2 程式的位置。ISO 32000-2 §9.9 列出閱讀器必須處理的內嵌字型程式類型: CFF2 是恰好同名的另一種格式。它拿掉 Name 與 String INDEX、拿掉 charset,把字形前進量從 CharStrings 移出去交給 hmtx,並加上 blend 運算元讓一份外框描述整個設計空間;CFF1 解析器遇到 CFF2 表毫無猜測的依據,PDF 規格也沒有任何條文要求它嘗試。把 CFF2 字型包進 OpenType 串流然後聽天由命,正是那種在這台機器渲染正常、下一台就掛掉的檔案,所以 HotPDF 不這麼做 轉換也必須是靜態的。如可變字型靜態實體化一文所說,PDF 字型是一組帶固定度量資訊的固定外框,沒有任何閱讀器被要求套用軸座標;HotPDF 因此先解析變化,然後才寫 CFF1 對應用程式碼來說,CFF2 字型的行為和其他已註冊的 Unicode 字型一樣:選軸值、註冊檔案、按名稱選字族、開畫。 字形 ID 來自註冊的 cmap,前進量來自註冊的 hmtx。前進量真的是零的字形就保持零,不會退回 GDI 量測;一個 UTF-16 代理對正好產出一個前進量,不是兩個。BMP 字元、補充平面字元與合成 shaping 載體各自維持所屬字型的 Unicode 映射,所以切換到另一個內嵌字型或開新頁面,都不會讓別的字型動到這個字型的子集狀態,也不會借用它的字形 ID 量測走同樣的位元組。 PDF 這一側,子代是帶 寬度需要一個小技巧。CFF1 的 Type 2 CharString 把前進量存成相對 幾何也獲得同樣的照料。 轉換器是 可變輸入在給定座標上走純幾何的靜態實體化,外框與前進量一併涵蓋;靜態 CFF2 字型只接受空選取,傳軸值給它視為錯誤而不是被忽略。結果是裸的 CFF1 程式,不是 sfnt 容器,別把它交給期望 OpenType 檔的程式碼 在預期情況下,失敗回報為空的 選用的第三個參數 預算超支與取消以例外回報,刻意與空結果路徑區隔開來:空陣列代表這個字型轉不動,例外代表這一次嘗試被中止。錯誤處理裡請把這兩種分開,因為換更大的預算重試一個轉不動的字型不會有任何幫助 最該先盤算的是檔案大小:HotPDF 對 CFF2 字型內嵌完整轉換後的字形集, 相關的大小功能遵循同一條規則。轉換後的 CFF2 字型是整顆內嵌,所以CompressDocument 啟用的精簡字型子集與持續性字型子集快取都不適用它;同一份文件裡的 TrueType 字型照常被子集化與快取。保留全部字形的唯一好處,是授權禁止子集化的字型得以用尊重授權的形式內嵌 這些資源上限是有限的轉換上限,CFF1 本身也限制單條 CharString 的容量。轉換後 CharString 超過 65535 位元組的字形,或吃光工作預算的字型,都會以看得見的方式失敗,而不是帶著空外框被寫出;這是刻意為之的取捨:罕見字型上一次響亮的失敗,勝過一份悄悄缺字的文件 原生 CFF2 文字與這個可攜的 CFF1 轉換器隨HotPDF Delphi PDF component 出貨,供 Delphi 與 C++Builder 使用,可變字型實體化、彩色字形與字型子集化等功能也一併涵蓋/FontFile 下的 Type 1、/FontFile2 下的 TrueType,以及 /FontFile3 下的裸 CFF 程式(Type1C 或 CIDFontType0C
以 CFF2 字型書寫原生文字
RegisterUnicodeTTF 另存一份原始 name 表副本,所以 SetFont 能以字族名、全名、PostScript 名或 typographic 字族名配對,並選中凍結後的靜態字型位元組,過程不涉及 Windows 安裝或 GDI 查找var
Pdf: THotPDF;
begin
Pdf := THotPDF.Create(nil);
try
Pdf.FileName := 'brochure.pdf';
Pdf.BeginDoc;
// 軸值套用在此呼叫之後註冊的字型
Pdf.SetVariableFontAxis('wght', 650);
Pdf.RegisterUnicodeTTF('C:\Fonts\AcmeSerifVF.otf');
// name 表裡的字族名、全名、PostScript 名或 typographic 字族名
Pdf.CurrentPage.SetFont('Acme Serif VF', [], 12, DEFAULT_CHARSET);
Pdf.CurrentPage.UnicodeTextOut(72, 100, 0, 'Variable weight 650, CFF2 outlines');
Pdf.EndDoc;
finally
Pdf.Free;
end;
end;THPDFPage.GetWideTextWidth 與 THPDFPage.GetWideCharAdvances 讀的是選中的位元組後端字型的度量,所以斷行與靠右對齊跟實際畫出來的一致。有一個順序細節常抓人:SetVariableFontAxis 在註冊之後做的改變,影響的是下一個你註冊的字型,不是已經凍結的那個實體;要第二個字重,就設新值再註冊一次HPDFConvertCFF2ToCFF 怎麼建出 CID-keyed 程式?
HPDFConvertCFF2ToCFF 產出帶單一 Font DICT 的原始 CID-keyed CFF1 程式,其中每個位置——包括空位置和未使用的位置——CID 都等於原始字形 ID;這個恆等關係就是整個設計的核心。字型名、PDF 的 /W 寬度、CFF 前進量與 ToUnicode CMap 全部指向同一套編號,沒有任何一層需要在字形 ID 與 CID 之間翻譯,也就沒有東西可能失去同步Identity-H 或 Identity-V 編碼的 CIDFontType0 字型,程式串流放在 /FontFile3 下、/Subtype /CIDFontType0C。因為 CID 本來就等於 GID,子代不帶 /CIDToGIDMap,這條串流也被排除在稍後給已註冊 TrueType 字型用的串流替換掛鉤之外;與 /Subtype /OpenType 包裝不同,轉換後的串流不會拉高 PDF 1.6 的版本需求nominalWidthX 的選用首運算元,而整數運算元限於有號 16 位元範圍;OpenType 前進量卻是無號 16 位元值,最大 65535。HotPDF 把 nominalWidthX 設成 32768、defaultWidthX 設成 0,然後把每個前進量明確寫成 advance - 32768:零前進量變成 -32768,65535 前進量變成 32767,整個 uint16 範圍都表達得出來,不用對任何字形做截斷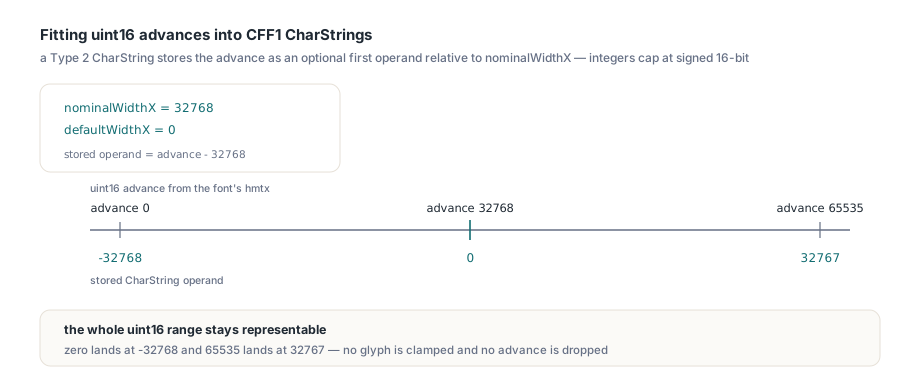
FontMatrix 是 [1/UnitsPerEm 0 0 1/UnitsPerEm 0 0],2048 單位的字型保住原生座標;單一運算元裝不下的相對移動與直線被拆成可表達的步進,三次曲線以保持形狀的方式細分;原始的版權與授權記錄、原始 name 表與內嵌旗標則隨 CFF Notice 字串一起帶上在文件之外呼叫轉換器
HPDFOpenTypeAdvanced 單元裡的公開函式,純 Pascal 實作,不依賴 HarfBuzz,也沒有安裝系統字型這一步;因此它可以獨立使用,例如在建置期預先轉換字型,或檢查 PDF 寫出器將來會內嵌什麼uses
System.SysUtils, System.IOUtils, HPDFOpenTypeAdvanced;
procedure ConvertWeight650;
var
Source, Cff: TBytes;
Axes: THPDFVariableFontAxisValueArray;
begin
Source := TFile.ReadAllBytes('C:\Fonts\AcmeSerifVF.otf');
SetLength(Axes, 1);
Axes[0].Tag := 'wght';
Axes[0].Value := 650;
Cff := HPDFConvertCFF2ToCFF(Source, Axes);
if Length(Cff) = 0 then
raise Exception.Create('Not convertible: not CFF2, embedding denied or bad axes');
TFile.WriteAllBytes('AcmeSerif-650.cff', Cff);
end;TBytes 而不是例外:輸入不是 CFF2、實體化器不接受某組軸選取、NaN 之類的非有限值,以及 OS/2 fsType 設了限制授權內嵌(0x0002)或僅點陣內嵌(0x0200)的字型。請務必檢查長度;在 EndDoc 裡寫出器會代勞並擲出「StoreFont: CFF2 outline conversion failed」,這是對的取捨——出貨 PDF 裡一個空白字型程式,遠比 log 裡一條看得見的錯誤糟糕伺服器工作負載的預算與取消
THPDFVariableFontControl 為記憶體設上限,並讓你能取消一次漫長的轉換。不傳時轉換器用自己的預設:輸入與輸出各 128 MiB 上限、1 GiB 累計工作預算,以及 CFF1 每條 CharString 65535 位元組的限制type
TFontJob = class
private
FCancelled: Boolean;
procedure CheckCancel;
public
function Convert(const Source: TBytes): TBytes;
property Cancelled: Boolean read FCancelled write FCancelled;
end;
procedure TFontJob.CheckCancel;
begin
if FCancelled then
Abort; // 從 HPDFConvertCFF2ToCFF 一路往外拋
end;
function TFontJob.Convert(const Source: TBytes): TBytes;
var
Control: THPDFVariableFontControl;
begin
Control := THPDFVariableFontControl.Create(
32 * 1024 * 1024, // 輸出位元組上限
Int64(256) * 1024 * 1024, // 累計工作預算
CheckCancel);
try
// nil 選取:可變字型的預設實體,或靜態 CFF2 字型
Result := HPDFConvertCFF2ToCFF(Source, nil, Control);
finally
Control.Free;
end;
end;內嵌一個 CFF2 字型有多大?
EnableFontSubsetting 開關都不影響。一個數千字形的字型會把全部字形加進每份用到它的文件,就算頁面上只有一行標題也一樣;做型錄還能接受,做一次寫出上千份小 PDF 的報表伺服器就是必須先量測再承諾的真實成本