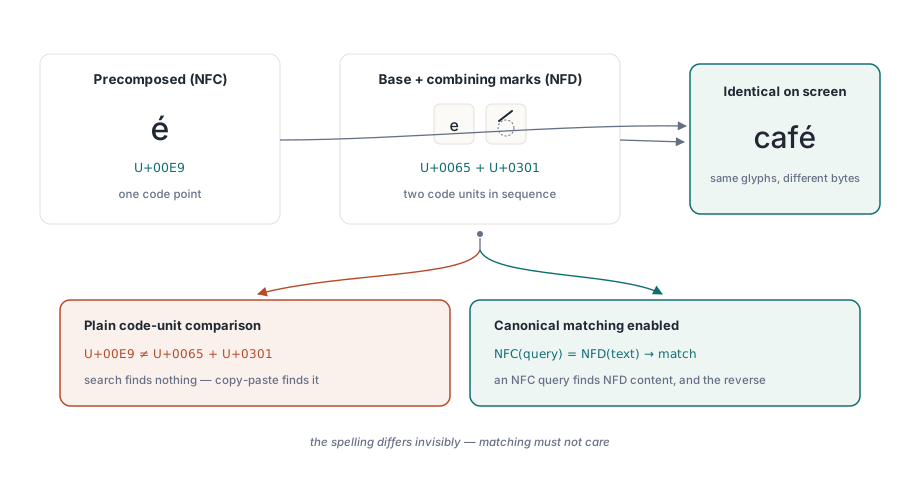
使用者在搜尋框輸入 Müller,沒有結果;把同一個名字從 PDF 裡複製出來、貼回搜尋框,突然就有了。在偵錯器裡看這兩個字串:Length 對輸入的那個回報 6,對貼上的那個回報 7。輸入的詞帶 U+00FC——單一個預組合 ü;文件裡存的是普通 u 後面跟著 U+0308 COMBINING DIAERESIS。兩者渲染成相同字形,而編碼單元比較永遠不會認為它們相等
為什麼看起來一模一樣的字串比對起來不相等?
Unicode 刻意允許同一個抽象字元有多種編碼,並稱這些編碼正規等價。Unicode Standard Annex #15 定義了對搜尋重要的兩種正規形式:NFC 偏好預組合碼點;NFD 把每個預組合字元拆成基礎字母加上按固定順序排列的組合符號。帶變音符號的拉丁字母兩種形態都存在。諺文音節也一樣,可以是一個預組合音節,也可以是兩三個組合字母(jamo)的序列
PDF 裡最終是哪種形態,取決於產生它的軟體、它跑過的平台,有時還取決於字型的 ToUnicode 表是怎麼建的。一台機器上輸入、另一台上編輯的文件,可以在同一頁混用兩種形態。搜尋的人對這些一無所見:他們的鍵盤與輸入法通常產出 NFC,所以檔案裡任何拆解形式的內容,從他們那邊就是搜不到的
最直覺的繞法是把它丟進大小寫折疊同一個籃子:兩邊轉小寫、去掉變音符號、再比較。這條路會斷,是結構性的原因。大小寫折疊與去變音符號在編碼單元層級是一對一的,折疊後文字與原文長度完全相同,折疊副本裡位置 17 的命中就是擷取文字裡位置 17 的命中。正規化會改變長度:一個預組合字母變成兩三個編碼單元,一個拆解序列收合回一個,諺文音節展開成 jamo——轉換之後,你拿回的位置就不再指向你擷取的那份文字
在 PDF Library for Delphi 裡用 soCanonicalEquivalent 搜尋
在 PDF Library for Delphi 裡,TPDFlibSearchOptions 的 soCanonicalEquivalent 成員讓 SearchText 以查詢與頁面文字的正規分解做比較,NFC 查詢找得到 NFD 內容,NFD 查詢也找得到 NFC 內容。這個選項是集合的一員,所以能與 soWholeWord、soCaseSensitive、soWildcards、soDiacriticInsensitive 直接組合,不需要任何額外 API:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // 填 ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // 空頁面範圍 = 每一頁

    // Found 計所有命中;只有前 Length(Hits) 筆被複製
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;這個迴圈裡有兩個容易絆倒人的細節。SearchText 即使緩衝區更小也回傳命中總數,所以在大文件上迭代到 Found - 1 會走出 500 元素陣列的盡頭;用 Min 收邊,或改用 SearchTextEach——它把每個命中交給 callback,完全不需要緩衝區。另外,MatchText 是包含命中的整個文字區塊,MatchStart 是從 1 起算的索引,所以命中的詞本身就是上面那個 Copy
拿它去跑一份把 Bäcker 存成拆解形式的檔案,印出的長度是 7;跑 NFC 檔案則是 6。同一個查詢、同一組選項,切出來的永遠是文件裡原樣的文字
讓命中座標持續指向原始文字
最後這個性質,正是讓正規化搜尋超出「有或沒有」、真正可用的關鍵。PDF Library for Delphi 為正規化器產出的每個編碼單元記錄它來自的原始 UTF-16 範圍的起訖:遞迴分解繼承父項的範圍,組合合併輸入的範圍;找到命中時,搜尋掃描映射區間,取最小起點與最大終點
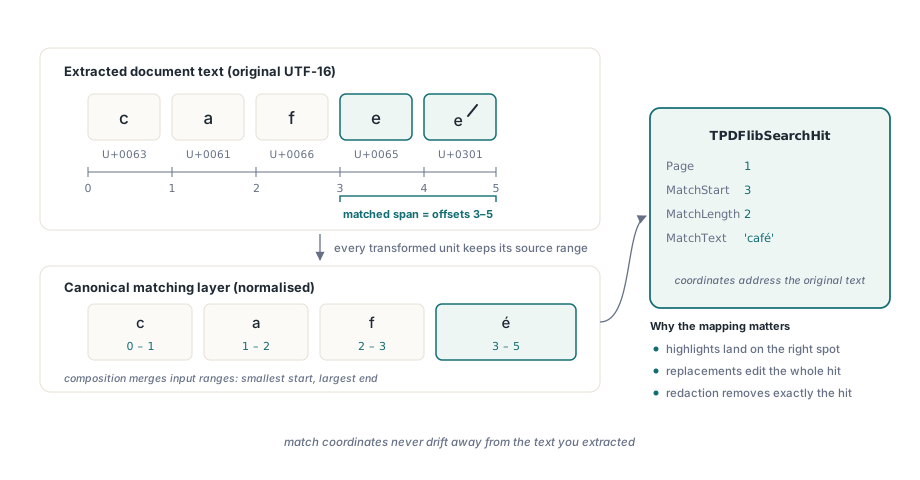
於是 MatchStart、MatchLength、ContextBefore、ContextAfter 與兩個取代進入點,定址的都是呼叫端早已持有的擷取文字。一個只能說「這個區塊裡有命中」、卻說不清確切位置的搜尋,當結果計數還行,其他一切都是錯的:高亮每遇到一個帶變音符號的字母就漂移一兩個字元,取代則會改寫到錯的那段文字
正規化器隨函式庫出貨。它帶著來自 Unicode 15.1 的緊湊表格——正規分解、組合與正規組合類別——諺文走演算法規則而不查表,NFD 期間穩定地重排組合符號。不載入任何外部資料檔、不呼叫作業系統的正規化,所以 Windows 服務、Linux 常駐程式與 Free Pascal 建置對同一份檔案回傳完全相同的命中。即使 Windows 上作業系統能代勞,我們還是偏好這樣:在一台伺服器上建、在另一台上查詢的搜尋索引,不該因為兩台機器的 Unicode 版本不同而各說各話
這個選項預設關閉,而這個預設是合理的。建 NFD 文字與位置映射要花時間,只含 ASCII 的發票搜尋永遠用不到。設了 soCanonicalEquivalent 時,每個文字區塊保留兩份轉換副本——帶組合符號的與不帶的——所以對同一區塊的一批查詢只正規化一次。普通的大小寫折疊繼續走較便宜的一對一路徑
命中停在一個字元中間時,會出什麼錯?
正規等價回答的是「這是不是同一段文字」,對命中可以停在哪裡隻字未提。只用 soCanonicalEquivalent 在拆解形式的 café 裡搜 cafe,前四個編碼單元比對成功,後面那個組合的銳音符被留在命中之外。soWholeWord 抓不到這種情況:它的「字元」遵循識別字規則(ASCII 字母、數字與底線),組合符號算是邊界。高亮蓋住 cafe,取代則留下一個孤零零的聲調,懸在後面接手的字上
同樣的事遠遠超出拉丁變音符號的範圍。國旗 emoji 是兩個區域指示符碼點;家庭 emoji 是幾個人形以零寬連接符串起來;天城文的連字是一個輔音加一個 virama 再加另一個輔音;越南文的母音可以疊兩個符號。基本多文種平面之外的任何東西在 UTF-16 裡都是代理對,從中間切一半就產生未配對代理,很多文字管線會把它換成 U+FFFD
soGraphemeClusters 要求每個命中——字面或萬用字元——的兩端都落在 Unicode Standard Annex #29 定義的擴充字位叢集邊界上。切分涵蓋 CR/LF 配對、控制字元、諺文音節類型、Extend 與 SpacingMark、Prepend、emoji ZWJ 序列、區域指示符配對與印度文字連字斷點,而且絕不會把邊界放在代理對中間。設了這個旗標,cafe 根本配不到拆解形式的 café;如果你要的本來就是不分聲調的比對,再加上 soDiacriticInsensitive
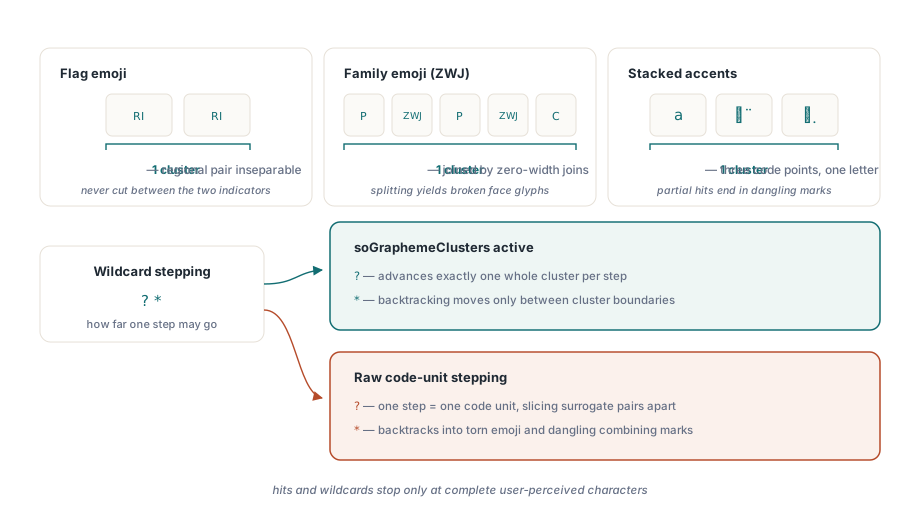
萬用字元是這個旗標改變結果最明顯的地方。在 soCanonicalEquivalent 之下,頁面文字以 NFD 做比較,所以 côté 變成 c o U+0302 t e U+0301,不管檔案當初怎麼存。沒有 soGraphemeClusters 時,c?té 裡的 ? 恰好吃掉一個編碼單元(那個 o),接著期待 t,卻遇到 U+0302。沒有命中。有旗標時,? 前進一整個叢集,* 的回溯也只在叢集邊界之間移動:
// "?" 一次走一個使用者感知字元,所以這能配到 côté
// 無論 PDF 存的是預組合還是拆解形式
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// 取代用同一套叢集安全範圍,所以絕不會
// 切開 emoji 或留下一個孤兒聲調
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent 改寫頁面內容裡的文字,回傳取代的命中數。回傳零時,GetLastUnicodeReplacementDiagnostics 會說明原因,例如命中無法映射回繪出它的內容。另一個進入點 SearchAndReplaceText 接受同一組選項,改為在命中的區塊上繪製取代內容
為真實工作負載選擇選項
三種組合涵蓋多數應用。文件檢視器裡給終端使用者的搜尋框:用 soCanonicalEquivalent 加 soDiacriticInsensitive——兩種編碼形式都比對得到,帶聲調與不帶聲調的拼法也通吃,這是大家被網頁搜尋養出的期待。法務或合規審查——誤報要賠上一個下午的那種:用 soCanonicalEquivalent 搭 soCaseSensitive 與 soWholeWord,聲調折疊保持關閉,等價精確、只無視檔案剛好用了哪種編碼
任何會改動文件的操作,每一次都要加上 soGraphemeClusters。這是我們不交給個人品味的地方:回傳範圍短了一個編碼單元的搜尋,只是誤導看結果的人;用同一個範圍的取代或移除,卻會把錯誤寫進檔案,直到頁面被印出或再次擷取才有人發現。必須銷毀內容而不只是覆蓋的移除是另一個主題,見真正的遮蔽與內容移除
同一份文件要跑多個詞時,優先用 SearchTextBatch。它趁頁面文字區塊還在記憶體裡時求值每個非空查詢,每頁只擷取一次、每個區塊只正規化一次,而且每個查詢帶自己的選項集合:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // 諺文:檔案裡可能是 NFC 或 jamo
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;命中按頁、區塊、查詢的順序回來,QueryIndex 是你傳入陣列裡從零起算的位置。SearchTextBatchEach 是 callback 形式,給無法預先估大小的結果集用。文字區塊最初是怎麼擷取出來的,文字搜尋與頁面元素列舉一文有描述
正規等價不是選配的文字系統
對韓文,正規等價決定名字找不找得到,因為預組合音節與拆解 jamo 在真實文件裡都會出現。越南文在可能已帶短音符號(breve)或揚抑符(circumflex)的母音上再疊聲調,組合形式完全看產生者心情。對天城文、孟加拉文與其他印度文字,連字規則決定命中邊界是否落在讀者認得出來的位置。日文與中文在搜尋這一側相對簡單,排版那一側可不是——見日文與中文的直式排版
我們的建議很直白。語料裡只要含有英文以外的任何語言,先把 soCanonicalEquivalent 打開,只有在自己的文件上實測之後、確認成本不可接受,才考慮關掉。它擋下的那種失敗,恰好砸在使用者最常搜的那些名字上
同一套 Unicode 感知引擎在 Delphi、C++Builder 與 Free Pascal 下驅動搜尋、擷取、取代與遮蔽;選項集合、批次 API 與其餘文字工具列在 PDF Library for Delphi 產品頁