PDFlibPas 這套 Delphi PDF Library 能匯入 JPEG 壓縮超出 8-bit baseline 的 TIFF 影像:12-bit extended sequential(SOF1)、Huffman 無失真(SOF3)、算術編碼(SOF9 與 SOF10),以及帶表格偏移的舊式 TIFF 6.0 JPEG。PDF 的 DCTDecode 帶不動這些處理流程,所以 PDFlibPas 以原生 Pascal 解碼,並用每通道 8 或 16 位元取樣無失真內嵌
完整支援需要 v3.724.0 或更新版本,而它瞄準的正是掃描器、醫療與科學擷取軟體,以及凍結在 1990 年代的檔案系統產出的 TIFF。下面說明這些變體為什麼不能原樣複製進 PDF、PDFlibPas 怎麼安置它們,以及途中發現的 Pascal 陷阱
為什麼 12-bit JPEG 不能直接放進 PDF?
12-bit JPEG 無法直接塞過去,因為 PDF 沒有任何 filter 被要求解得開它。ISO 32000-1 §7.4.8 把 DCTDecode 定義在 JPEG baseline 格式上,PDF 1.3 加入漸進式延伸,但整條條文都沒有涵蓋 12-bit 取樣精度、ITU-T T.81 附錄 H 的無失真流程,或附錄 D 的算術熵編碼器。在 DCTDecode 串流裡遇到 SOF1 12-bit frame 或 SOF9 marker 的閱讀器,有權利什麼都不畫,而大多數檢視器也確實這麼做
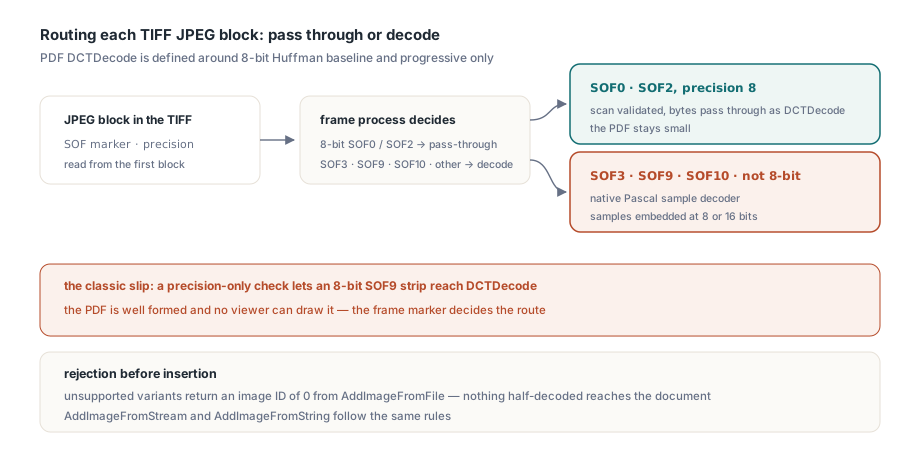
構成大多數 JPEG-in-TIFF 檔案的 8-bit Huffman baseline 與 progressive strips,PDFlibPas 仍會驗證每一個 scan,並把壓縮位元組以 DCTDecode 直接帶過,讓 PDF 保持小巧;其餘全部解碼。PDFlibPas 讀第一個 JPEG 區塊的 frame marker 與取樣精度,一旦看到 SOF3、SOF9、SOF10 或精度不是 8,頁面就走取樣解碼器而不是直通路徑。靠 frame marker 偵測算術編碼比聽起來重要:只看取樣精度的檢查會讓一張經典 TIFF 把 8-bit SOF9 strip 偷渡進 DCTDecode 路徑,產出閱讀器畫不出來的 PDF
PDFlibPas 改寫進 PDF 的是什麼
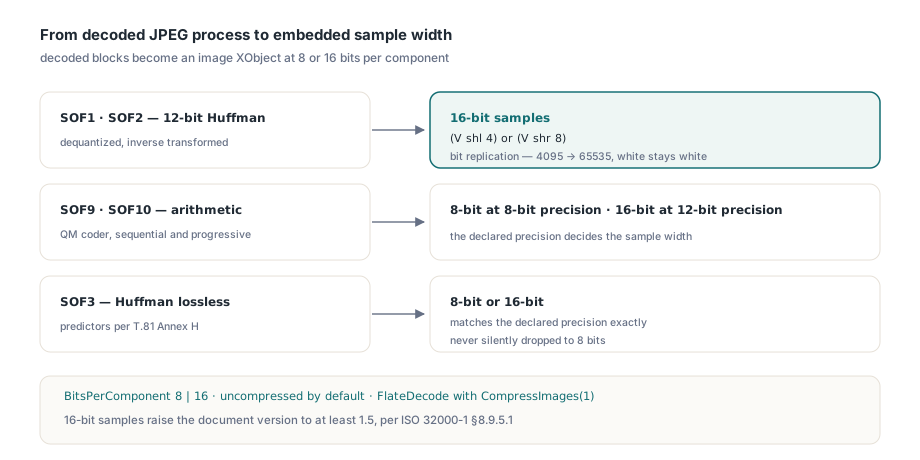
PDFlibPas 把解碼後的 JPEG 區塊變成普通的影像 XObject,BitsPerComponent 為 8 或 16。取樣預設不壓縮儲存;加入影像前先呼叫 CompressImages(1),PDFlibPas 就以 FlateDecode 寫出。ISO 32000-1 §8.9.5.1 允許 PDF 1.5 起使用每通道 16 位元,所以只要加入 16-bit 取樣的影像,PDFlibPas 就把文件版本拉到至少 1.5;多 strip 與 tiled 影像也包含在內,它們的根物件是 Form XObject,本身沒有 BitsPerComponent 可以查看
每種 JPEG 流程的映射是固定的:
- 12-bit Huffman JPEG(sequential SOF1、progressive SOF2)經反量化、反轉換後拓寬成 16-bit 取樣
- 算術編碼 JPEG(sequential SOF9、progressive SOF10)在 8-bit 精度下成為 8-bit 取樣,在 12-bit 精度下成為 16-bit 取樣
- Huffman 無失真 JPEG(SOF3)成為 8-bit 或 16-bit 取樣,與其宣告的精度完全一致
12 拓寬到 16 位元用的是位元複製,(V shl 4) or (V shr 8),4095 映到 65535,白色還是白色,不會卡在 65520。PDFlibPas 絕不會背著你把這些影像降成 8 位元;函式庫為自己的顯示表面把這種頁面點陣化時用的是每個取樣的高位元組,但內嵌的 PDF 影像保留全部十六個位元
代價是檔案大小:就算開了 CompressImages(1),Flate 壓縮的 16-bit 取樣還是比原本的 DCT 資料大,不開就更大。對診斷與典藏工作流程來說,這筆交換通常是對的;若某個案子大小更要緊,Delphi 縮減 PDF 檔案大小指南會說明位元組實際都花在哪裡
用 TPDFlib 匯入這些 TIFF
呼叫端程式碼完全不用改。TPDFlib.AddImageFromFile(Const FileName: WideString; Options: Integer): Integer 在 Options 收 1 起算的 TIFF 頁碼,回傳影像 ID,頁面無法匯入時回傳 0。不支援的 JPEG 變體在影像插入前就會被退回,所以 0 代表沒有任何解到一半的資料進到文件裡
uses
  PDFlibrary;

function TiffToPdf(const TiffName, PdfName: WideString): Boolean;
var
  Lib: TPDFlib;
  Page, PageCount, ImageID: Integer;
  DPI, W, H: Double;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    Lib.SetMeasurementUnits(0);   // 預設使用者空間,1/72 吋
    Lib.SetOrigin(1);             // DrawImage 用左上原點
    Lib.CompressImages(1);        // 解碼取樣用 Flate
    PageCount := Lib.GetImagePageCount(TiffName);
    if PageCount = 0 then
      Exit;
    for Page := 1 to PageCount do
    begin
      ImageID := Lib.AddImageFromFile(TiffName, Page);  // Options = TIFF 頁碼
      if ImageID = 0 then
        Exit;                     // 不支援或損壞的影像資料
      Lib.SelectImage(ImageID);
      case Lib.ImageResolutionUnits of
        2: DPI := Lib.ImageHorizontalResolution;          // 每吋點數
        3: DPI := Lib.ImageHorizontalResolution * 2.54;   // 每公分點數
      else
        DPI := 0;
      end;
      if DPI <= 0 then
        DPI := 300;
      W := Lib.ImageWidth * 72 / DPI;
      H := Lib.ImageHeight * 72 / DPI;
      if Page > 1 then
        Lib.NewPage;
      Lib.SetPageDimensions(W, H);
      Lib.DrawImage(0, 0, W, H);
    end;
    Result := Lib.SaveToFile(PdfName) = 1;
  finally
    Lib.Free;
  end;
end;
不需要任何按格式的分支,記憶體裡的 TIFF 資料用 AddImageFromStream 與 AddImageFromString 也遵循同樣規則
舊式 JPEG:表格在偏移處,strip 沒有檔頭
自 v3.713.0 起,PDFlibPas 能匯入表格來自 JPEGQTables、JPEGDCTables 與 JPEGACTables 偏移標籤,或來自純表格 JPEGInterchangeFormat 串流的舊式 JPEG TIFF(Compression = 6)。TIFF 6.0 第 22 節定義了那種版面,TIFF Technical Note 2 後來用 Compression = 7 加共用 JPEGTables 標籤取代它,但掃描器又寫了好幾年舊格式
容器那一側(BigTIFF 與 tiled 版面)在TIFF 解碼器強化一文有交代,這裡聚焦 JPEG 負載。每個表格偏移標籤指向一張原始的 64 位元組量化表,或一張 16 個 counts 加上其值的 Huffman 表,每個元件一組。PDFlibPas 把它們變成合成 JPEGTables 串流裡的 DQT 與 DHT 區段;每條裸熵編碼資料的 strip 再取得自己的檔頭:SOI、帶該 strip 列數的 frame marker、JPEGRestartInterval 有設定時的 DRI、SOS、熵資料與 EOI。這些 strip 不能黏成一個 scan,因為舊式 JPEG 在每個 strip 邊界重新開始 DC 預測
有兩個細節容易出錯。YCbCr 影像的三個元件的表格偏移常常指向同一批位元組,所以 PDFlibPas 在指派表格編號前先按內容去重;同一類的 Huffman 表若剩下超過兩張,合成 frame 改用 SOF1 而不是 SOF0,因為 baseline frame 最多只能參照兩張 DC 表和兩張 AC 表。當 JPEGInterchangeFormat 指向的是帶 scan 的完整 JPEG 串流時,PDFlibPas 把那條串流當成整張影像,以單一條新式 strip 匯入。無失真、tiled 與獨立平面的舊式 JPEG 一律以明確錯誤退回,不靠猜,請在上游先轉成新式 JPEG
為什麼 TIFF 裡的 CMYK JPEG 會跑出反轉結果?
TIFF 裡的 CMYK JPEG 跑出反轉結果,是因為匯入器把屬於獨立 JPEG 檔的 Adobe APP14 慣例套了上去。Photoshop 把反轉 CMYK 寫進獨立 JPEG,所以 PDF 產生器傳統上會補一個 /Decode [1 0 1 0 1 0 1 0] 來抵銷;TIFF PhotometricInterpretation 5 則把取樣定義成墨量,0 代表沒有墨,主流 TIFF 閱讀器看解碼後的 JPEG 取樣就直接用,不理 APP14
PDFlibPas 內嵌 JPEG 壓縮的 CMYK TIFF strip 時不帶反轉 Decode 陣列,無論有沒有 APP14 marker。APP14 transform 旗標仍然決定 YCCK 是否轉成 CMYK,而這一步 DCTDecode 自己處理。獨立的四通道 JPEG 檔保留反轉的 Adobe 慣例,所以同樣的 JPEG 位元組會因容器不同而受到不同待遇,這正是兩種格式各自的要求
為什麼無失真 JPEG 解碼會栽在一個 Pascal 移位上?
無失真 JPEG 解碼在 Pascal 上會出錯,因為預測器 5 和 6 需要算術右移,而 Pascal 的 shr 是邏輯移位。SOF3 從左(Ra)、上(Rb)與左上(Rc)鄰居預測每個取樣,只編碼差值;T.81 表 H.1 的七個預測器裡,預測器 5 是 Ra + ((Rb - Rc) >> 1)、預測器 6 是 Rb + ((Ra - Rc) >> 1),而括號裡的差值在左上鄰居比較亮時就會變負。把負 Integer 餵給 shr,符號位元就成了大小位元,影像便碎成雜訊
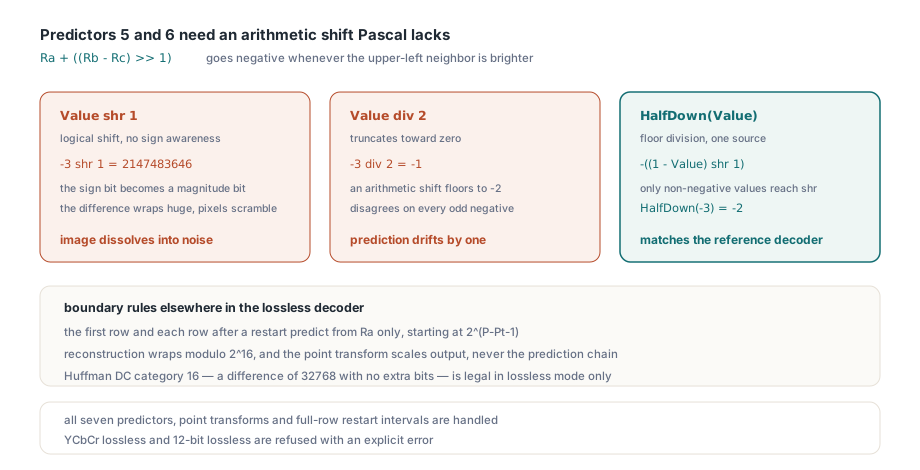
把移位換成 div 2 也救不回來:div 向零截斷,算術移位則向負無窮取整,兩者在每個奇數負值上都不同。Free Pascal 的 System 單元有 SarLongint,Delphi 沒有對應物,所以 PDFlibPas 用一個在兩邊編譯出相同行為的幫手:
// 算術右移一位:floor(Value / 2)
// shr 是邏輯移位,div 2 則向零截斷
function HalfDown(Value: Integer): Integer;
begin
  if Value >= 0 then
    Result := Value shr 1
  else
    Result := -((1 - Value) shr 1);
end;

// Value = -3: -3 shr 1 = 2147483646, -3 div 2 = -1, HalfDown(-3) = -2同一類問題的型別寬度面向,見Delphi Linux64 的 Longint 與指標陷阱
無失真解碼器的其餘部分另有自己的邊界規則。第一列,以及每個 restart marker 後的第一列,只從左鄰居預測,並從精度 P、點轉換 Pt 的 2^(P−Pt−1) 起步;之後每一列都從上方取樣出發。重建對 2^16 取模循環,點轉換只縮放輸出,不碰預測鏈。Huffman DC 類別 16——沒有附加位元的 32768 差值——只在無失真模式合法,所以表格解析器得在知道 frame 會宣告哪種流程之前就先接受它
PDFlibPas 支援全部七個預測器、點轉換,以及涵蓋整列的 restart interval。JPEG 精度必須等於 BitsPerSample 且為 8 或 16,每個元件取樣必須是 1x1;YCbCr 無失真資料與 12-bit 無失真 JPEG 以明確錯誤退回
原生 Pascal 裡的 12-bit DCT 與算術編碼
PDFlibPas 的 12-bit 與算術解碼器共用同一個反 DCT,只在熵解碼上不同。12-bit Huffman JPEG 的 DC 類別到 15、AC 類別到 14,量化表可以帶 16 位元項目,DC 預測在每個 scan 和每個 restart 重置。係數一路保持 zigzag 順序直到反量化——反量化必須取同一個 zigzag 索引上的量化值——然後才換成自然順序做可分離兩趟 IDCT;解碼取樣落在獨立浮點參考解碼器的 ±1 之內
算術編碼用 T.81 附錄 D 的 QM coder 取代 Huffman:114 項機率狀態表、64 格的 DC 統計區與 256 格的 AC 區,由 DAC 區段的條件參數驅動(預設 L = 0、U = 1、Kx = 5)。統計、DC context 與預測在每個 restart interval 和每個 scan 開頭重置;這正是 PDFlibPas 為算術影像正規化共用 JPEGTables 時保留 DAC 區段的原因——拿掉它們,每條 strip 都會用錯的統計模型解碼
v3.723.0 把子取樣元件與用 JFIF 方程式的 YCbCr 轉 RGB 加進這些解碼路徑,v3.724.0 再加上 12-bit Huffman(SOF2)與算術(SOF10)資料的 progressive scans。子取樣色度以複製放大到全解析度,不做平滑,這正是參考解碼器關掉 chroma smoothing 時的產出。階層式 JPEG 與算術編碼無失真 JPEG(SOF11)以明確錯誤退回
在 Delphi 測試二進位 JPEG 測試素材
在 Delphi 單元測試裡手工打造的 JPEG 測試素材,可以用一種極像解碼器出錯的方式失敗。由 #$xx 字元組成、長度超過 255 字元的字串常數會被定型為 UnicodeString,指派給 AnsiString 時便透過當前字碼頁轉換;熵編碼資料裡常見的 $80 到 $9F 位元組就在進場時被改寫。執行期組 marker 檔頭也有同樣陷阱:在 Delphi 裡 AnsiChar + AnsiChar 產生 UnicodeString,所以請把單一位元組附加到 AnsiString,或用 SetLength 加索引指定寫入。測試素材請存成十六進位文字,執行期再解碼:
uses
  SysUtils, PDFlibrary;

function HexToBytes(const Hex: AnsiString): AnsiString;
var
  I: Integer;
begin
  SetLength(Result, Length(Hex) div 2);
  for I := 1 to Length(Result) do
    Result[I] := AnsiChar(StrToInt('$' + string(Copy(Hex, I * 2 - 1, 2))));
end;

// 測試素材保持純 ASCII,任何字碼頁都碰不到它
ImageID := Lib.AddImageFromString(HexToBytes(TiffHex), 1);產生測試影像時注意:jpegtran -arithmetic 寫的是 sequential SOF9,SOF10 還要加上 -progressive。另外,非零的影像 ID 只證明匯入被接受;請真的渲染頁面並比對像素,因為直通路徑上的錯誤會產出一份格式完好卻沒有任何檢視器畫得出來的 PDF
把老舊掃描檔案庫帶進 PDF
這些 JPEG 變體往往在檔案庫遷移時一次全部現身。PDFlibPas 用與其他影像同一個 AddImageFromFile 呼叫讀取 12-bit、無失真、算術與舊式 JPEG TIFF,在 PDF 裡保留完整精度,並對這組之外的少見流程以明確錯誤退回。授權、完整功能清單與試用下載請見PDFlibPas PDF Library for Delphi 產品頁