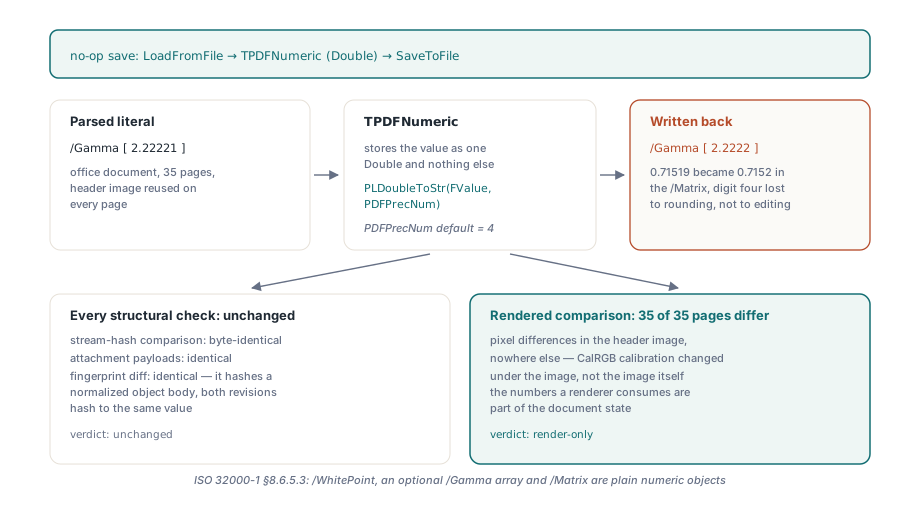
載入一份校準過的 PDF,什麼都不改,換個名字存檔,然後比對色彩空間字典:/Gamma [2.22221 2.22221 2.22221] 進去,出來的是 /Gamma [2.2222 2.2222 2.2222]。寫入器重新格式化了一個它根本不必碰的數字,頁面的顏色於是產生了細微偏移。解方是把每個解析到的十進位數當成兩個身分同時看待:做算術用的值,和輸出用的字面值;在真的有人指派新值之前,持續輸出那個字面值
為什麼一次無操作的存檔會搬動 CalRGB 顏色
像素會動,是因為圖像位元組原封不動、渲染器拿到的校準資料卻差了一點。ISO 32000-1 §8.6.5.3 用必填的 /WhitePoint、選配的三元素 /Gamma 陣列和選配的九元素 /Matrix 定義 CalRGB 色彩空間,三者在色彩空間字典裡都是普通數值物件。把它們塞進 Double、再用固定四位小數的格式器輸出,2.22221 變成 2.2222,0.71519 的矩陣條目變成 0.7152。Gamma 值是套在每個經過該空間之像素每個分量的指數,所以這個空間用在哪裡,變化就顯現在哪裡
假如一份檔案為了在 35 頁重複使用的頁首圖像宣告了一個 CalRGB 空間,那 35 個頁首全部換了顏色,頁面上其他東西紋風不動。人們第一時間想的檢查全都乾淨過關。解碼串流的雜湊比的是圖像資料,圖像資料確實一模一樣;損害坐在字典裡。修訂層級一文描述的修訂差異比對指紋化的是正規化後的物件主體,兩個修訂版在那裡也雜湊出同一個值。能抓住它的,是渲染比對。對任何改寫他人軟體產出 PDF 的管線,我們會把逐頁渲染比對排在所有結構檢查之前
PDF 實數長什麼樣才算合法
ISO 32000-1 §7.3.3 把實數定義為十進位字串:選配的正負號、數字、小數點、再一段數字。沒有底數記法,沒有指數形式。列出實作限制的附錄 C,預期小數部分約五位有效數字會被尊重。所以預設輸出精度四位,本來就比規範要求讀取端保留的還少一位;檔案用五位,一點也沒做錯
在零附近,天真的格式器比丟一位數字更糟。把 Double 按 N 位輸出的常見做法是乘以 10^N、四捨五入成整數、再把數字寫出來;整數是零時,輸出就是 0。把 0.00001 0 0 1 0 0 cm 的第一個運算元按四位交給它,結果是 0 0 0 1 0 0 cm——一個奇異矩陣,其下繪製的一切憑空消失。-0.000012345 的 /Matrix 條目也走同一條路
當 PDF Library for Delphi(PDFlibPas)必須親自格式化 Double 時,對小於精度步長的非零值,它保留要求的位數而不是寫 0。四位之下,0.00001 寫成 0.00001、0.0000123 寫成 0.0000123;只有量級低於約 5E-16 的才輸出 0。這讓新寫出的數字保持理智。解析來、從不需要重新格式化的數字則是另一回事,函式庫的處理方式是:根本不去重新格式化
PDFlibPas 怎麼守住它解析到的字面值
TPDFStructure.Decode 為它詞法化的每個標準實數保留原始文字——帶小數點、不帶指數記號的記號——就放在轉換後的 Double 旁邊。TPDFNumeric.Output 只要那個文字存在就原樣寫回,不存在時才按結構的 PDFPrecNum 格式化 Double。TPDFNumeric.SetTo 丟掉文字,因為被編輯過的數字就是新數字,理應遵循目前的輸出精度
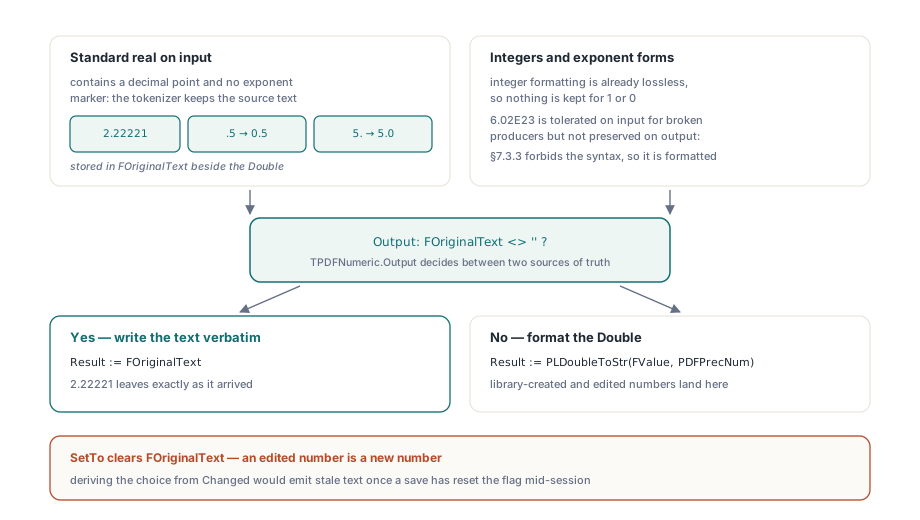
把重置綁在 SetTo 上是深思熟慮的。順手的捷徑是除非物件的 Changed 旗標亮起才輸出原始文字——那個旗標每個物件本來就有。但存檔管線在物件寫出後就清掉 Changed,於是同一個會話裡「編輯、存檔、再編輯」的值,第二次存檔又會吐出過期的舊字面值。把清除動作放進指派本身,字面值和值就永遠不可能不一致
幾個邊界是刻意設計的。整數不以文字保存,因為整數格式化本來就無損。6.02E23 這類指數形式在輸入端照收——為的是硬要這樣寫的產品——但輸出時按函式庫產生的一般數字格式化,因為原樣抄回去等於把 §7.3.3 排除的語法繼續流傳。詞法器儲存文字前還會做它慣常的小修復:前導點字面值如 .5 保留為 0.5,尾隨點字面值如 5. 保留為 5.0。每一對在所有讀取端眼裡都是同一個數,而修復後的寫法接受度高得多
下面的片段讓 CalRGB 的值直接走物件層,不必開 PDF 檔就能看清每條規則。Assert 那幾行是我們建議加進你自己測試的檢查;它們不是對函式庫的呼叫
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // 你自己的檢查:未編輯的輸入逐字存活,包括天真的
    // 四位格式器會塌成 0 的那個值
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // 編輯會丟掉原始文字、遵循 PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // 微小的新值保留有效數字,不會變成 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // 之後調低精度,碰不到未編輯的輸入
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
寫這類斷言有一個陷阱:Delphi 的 Round 用銀行家捨入,而 0.000012345 * 1e8 在二進位裡算出 1234.4999…,不是 1234.5。檢查近零格式化路徑時我們正好撞上這個值。當斷言依賴最後一位怎麼進位時,測試輸入請挑不是二進位中點的數
SetPrecision 到底控制什麼?
TPDFlib.SetPrecision 設定函式庫寫出的數字的小數位數:經繪製器畫出的圖形、從 Double 建立的數字(例如經 NewNumeric),以及解析後已被 SetTo 改動的值。它接受 2 到 8,範圍外一律回傳 0。沒人編輯過的解析十進位數,無論設定為何都保留輸入文字;LoadFromFile 之後改設定,也回頭碰不到它。傳給 SetObjectFromString 的來源走同一個詞法器、以同樣方式保留
我們的建議是:除非你產生的幾何需要更細的步長,別動 SetPrecision。調高它來保護輸入檔案毫無收益——未動過的輸入本來就保留自己的位數——卻讓你畫的每個數字變長。次點級繪圖工作選五位合理;八位多半只是灌大內容串流
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // 治理從這裡之後寫出的數字;解析到的 /Gamma、
    // /Matrix 和 /WhitePoint 陣列保留原始文字
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // 繪出的數字用五位
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
內容串流:編輯保留運算元,正規化是選配
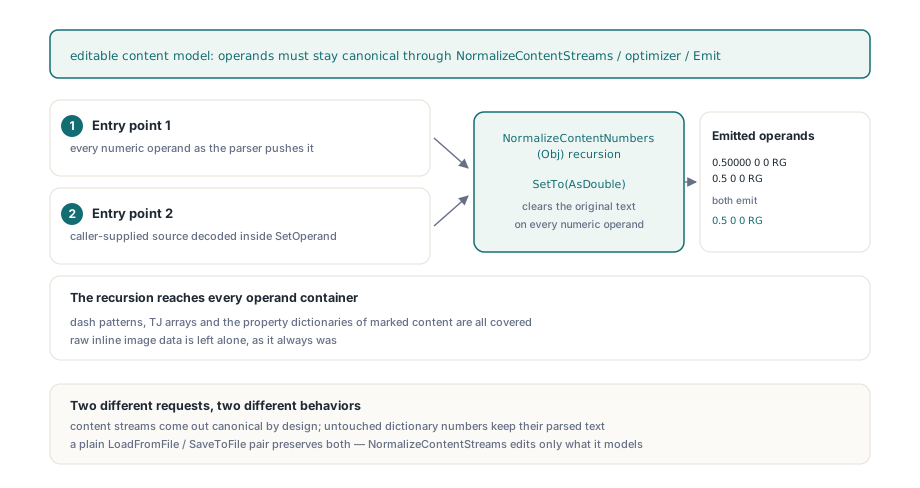
可編輯內容模型預設保留運算元文字,只有在規範化輸出正是呼叫目的時才正規化數字。TPDFContentProgram.CanonicalNumbers 預設 False,所以 ParsePageContentLayer 回傳的層——圖形狀態追蹤器採用的同一模型——會把每個未觸碰的數值運算元按原樣重新輸出。整層改寫的頁面編輯,包括 ScalePage、TransformPageElement、DeletePageElement、RedactRegion、ConvertTextToPaths 以及你用 WritePageContentLayer 寫回的自家程式,都只改動編輯碰到的那些運算元
另一個預設看起來整齊:每次解析都正規化,編輯路徑和 NormalizeContentStreams 永遠產出同樣拼寫。我們認為對編輯而言這是錯的預設。對含 0.123456 w 的層呼叫 ScalePage 會寫回 0.1235 w,層裡所有其他運算元也跟著重寫,儘管呼叫端要的只是縮放。規範形式屬於那些目的就是可比輸出的操作
那些操作照樣拿得到。NormalizeContentStreams 和存檔時的內容最佳化器以 CanonicalNumbers 設為 True 解析,因為它們的職責是從任意輸入產出穩定輸出;如果 0.50000 0 0 RG 和 0.5 0 0 RG 輸出得不一樣,每個下游比對都會隨產品的格式化習慣漂移。正規化會遞迴穿過陣列和字典,虛線樣式、TJ 陣列、標記內容屬性字典都在涵蓋範圍內,原始內嵌圖像資料則保持原樣。經 SetOperand 提供的運算元無視旗標一律正規化。每個內容程式自帶固定四位小數的數字存放,獨立於 SetPrecision,所以被編輯的運算元以四位輸出。只有 Parse 讀這個旗標,意味著必須在解析之前設定;對 ParsePageContentLayer 已解析過的程式,設好旗標後呼叫 Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // 改一個線寬;其他所有運算元保留原始文字
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // 輸出為 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // 正規化副本僅供比對,不寫回:
      // Parse 是旗標唯一的讀取者,設定後要重新解析
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit 現在把 0.50000 和 0.5 拼成一樣
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
合起來,給呼叫端的規則很短。純粹的 LoadFromFile 加 SaveToFile,未觸碰的內容串流和未觸碰的字典數字原樣保留。經內容模型編輯過的頁面,保留編輯未改動的每個運算元的文字。NormalizeContentStreams、存檔壓縮內容時跑的最佳化器,以及任何以 CanonicalNumbers 設為 True 解析的程式,按設計產出規範數字,文件其餘部分依然原封
代價是什麼,以及保證到哪裡為止
每個 TPDFNumeric 多帶一個 AnsiString 引用,每個解析到的十進位數只要物件活著就讓原始文字活著。在動輒數百萬個實數的文件上,這是量得出來的記憶體,值得列入你跑的任何大型文件基準。這份保證也以數字所屬的文件為界。跨文件複製物件、或經物件 API 重建值,產出的都是新數字,新數字遵循輸出精度
保留數字與位元組級相同的輸出是兩個獨立性質。對未動過文件做一次載入存檔,保住渲染器消費的校準數字;但位元組一致還取決於物件編號、串流壓縮和 確定性 PDF ID 一文涵蓋的 trailer 識別碼。指紋差異持續雜湊正規化後的主體,這代表其他工具寫出的檔案裡的捨入差異落在它比對的範圍之外;那些仍靠渲染比對來抓
數值處理與 SetPrecision 的精確語義,連同上文用到的內容模型呼叫,都記載於 losLab PDF Developer Library 的參考文件