PDF Library for Delphi 可透過 DeduplicateSimilarImages,合併 PDF 中看起來相同、但位元組並不完全一致的圖片。精確去重複只會合併字典與編碼負載完全相符的圖片;這項功能則比對圖片實際看起來的樣子,使用感知雜湊搭配兩項像素誤差門檻,並把每一處參照全部重新導向同一個標準物件
最能從中受益的檔案,通常是那些因為意外而變大的檔案。例如一批掃描檔,每一頁都帶有同一個標誌,但各自被不同掃描器重新編碼過;例如一份由多個來源組合而成的報告,每個來源都嵌入了同一張圖表,只是 JPEG 品質略有不同;又例如一份縮圖被兩套不同工具重新產生過的型錄。每種情況下,檔案裡都存在同一張圖片的許多份副本,而精確去重複對這些副本一律無能為力
「夠相似」究竟該怎麼定義
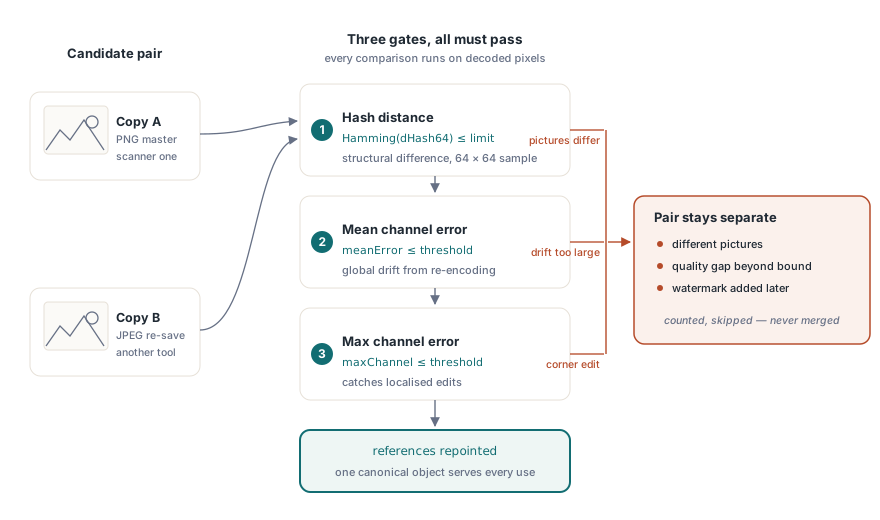
兩張圖片要被合併,必須同時滿足三項門檻,每一項各自捕捉一種不同的差異。感知雜湊距離限制的是結構性差異:一個 64 位元的差異雜湊值,是從解碼後圖片的 64x64 取樣區塊計算而來,允許的漢明距離範圍是 0 到 7。平均色版誤差限制的是整體漂移,這正是重新編碼會產生的效應。單一色版最大誤差限制的是局部性差異,這正是小幅編輯會產生的效應
要求三項條件同時成立,正是讓這次合併站得住腳的關鍵。一張只在某個角落多了浮水印的圖片,平均誤差低、但最大誤差高,因此會被最大誤差這道關卡擋下。一張被重新壓縮過的圖片,則是各處誤差都很小,因此能通過檢查。這正是大小最佳化工具需要區分出來的差別
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // 雜湊距離 2、平均誤差 2、單一色版誤差 4
    // 選項可要求試跑模式,讓內容不受任何修改
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
語意相同優先於視覺相似
在比對任何像素之前,候選圖片必須先在語意上一致。函式庫會從完整的圖片字典建立一個穩定簽章,排除 /Length、/Filter 與 /DecodeParms,因此尺寸、色彩空間、位元深度、遮罩、/Decode 陣列、內插方式、選用內容成員身分與中繼資料,全部都必須相符
這樣的先後順序,能防止一整類錯誤合併。兩張圖片在 64x64 取樣下可能看起來完全相同,但在頁面上的表現卻不同:一張 /Interpolate 為真、另一張不是,縮放時的平滑處理方式就會不同;而屬於某個選用內容群組的圖片,會在該圖層被隱藏時消失。跨越這些邊界進行合併,會得到一份更小、但是錯誤的文件
只有間接的 Image XObject 會被掃描。內嵌影像是另一種結構,經濟性也不同,而無法解碼的圖片則會被保守地略過並計數,而不是憑信任進行合併——沒有像素證據,就不合併
搜尋如何維持低成本
把每張圖片與其他每張圖片逐一比對,是二次方複雜度,在一份含有數千張圖片的文件上是無法接受的。因此雜湊值會被切成八個 8 位元的區段,每個區段各自建立一份有序索引
剩下的工作交給鴿籠原理完成:若兩個雜湊值最多相差 7 個位元,那麼它們在八個區段中必定至少有一段完全一致。因此逐區段查找候選項,就能在不進行窮舉配對掃描的情況下,找出每一個符合條件的相符項,而公開的上限值 7,正是因為這項保證只在該距離範圍內成立才訂出來的
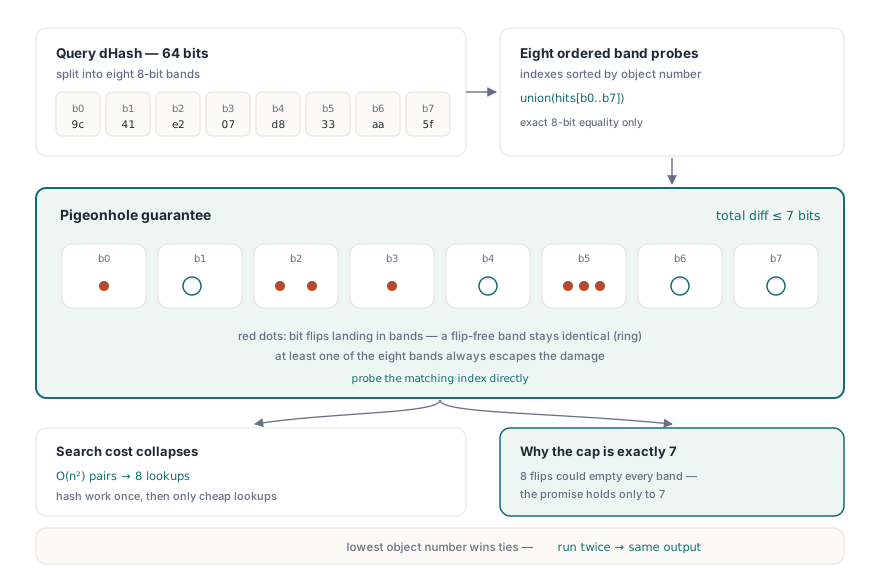
候選項與區段命中結果,都依物件編號與世代編號做確定性排序,物件編號最小的那一個會成為標準物件。這讓輸出結果具備可重現性:對同一份輸入執行兩次最佳化,得到的標準物件選擇會完全相同,這在結果需要被比對或簽署時十分重要
試跑與誠實的報告
由於被合併的圖片本來就不完全相同,這在某種意義上是一種有損最佳化,因此明智的做法是三思而後行。試跑選項會回報哪些圖片會被合併、能回收多少負載大小,卻不實際修改物件圖,這讓批次作業能記錄下這個效果,也讓人可以一次核准門檻設定,而不必逐一檔案核准
報告中有兩點誠實揭露值得一提。可回收的數字,估算的只是重複串流的編碼負載,並未計入字典、間接物件與交互參照的額外開銷,因此實際的檔案大小縮減幅度,會略大於報告數字,而不是更小。此外報告也會揭露實際被接受的最大誤差與比對工作量,讓你能看出這次合併與你設定的門檻究竟有多接近
固定使用 64x64 取樣網格是一種刻意採用的近似做法,它有一項後果值得明白說清楚:即使把門檻設為零,小於一個取樣格的差異仍可能不被察覺。掃描頁面中一個更動過的單字,可能無法在這種取樣下存活下來。當需要位元組層級的證明時,請改用精確去重複路徑——它只合併真正完全相同的資源,完全不做任何視覺判斷
在縮減檔案大小的流程中該擺在哪裡
依風險高低排列各個處理步驟。先執行精確資源去重複,因為它無損且幾乎零成本。接著是字型子集化,同樣無損,且通常是文字密集文件中效果最大的單一手段,涵蓋於PDF 檔案大小最佳化與字型子集化一文。若目標媒介允許,接著是圖片重新壓縮或降低取樣。感知去重複應該排在這些步驟之後,因為它是唯一一個結果取決於主觀判斷的步驟
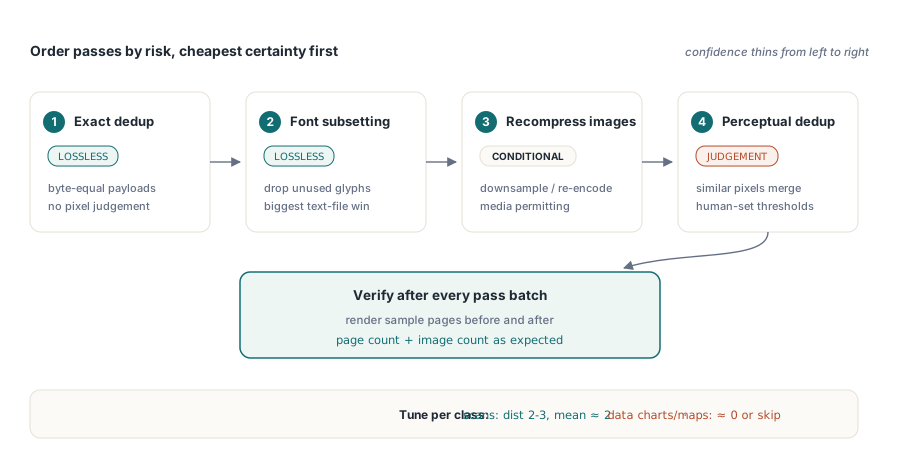
門檻值應依文件類別設定,而不是全站統一。對於每一頁都帶有相同信頭的掃描批次,雜湊距離設為 2 到 3、平均誤差約為 2,就能可靠地合併信頭。對於圖片本身承載資料的文件——圖表、地圖、醫學影像——則應使用零或接近零的門檻,或乾脆略過這個步驟,因為兩張只差一個繪製點的圖表,無論在 64x64 下看起來多相似,本質上仍是兩張不同的圖表
最佳化之後,務必驗證。渲染最佳化前後的一批頁面樣本並互相比對,並確認頁數與圖片數量的變化符合預期。要檢視一份文件實際包含哪些內容,可參考依類別稽核 PDF 檔案大小一文,這也是釐清圖片究竟是不是問題根源最快的方法
感知去重複、精確資源去重複與大小稽核,在 Delphi、C++Builder 與 Free Pascal 中都運作於同一個物件圖;完整功能清單請見PDF Library for Delphi 頁面