losLab 的 Delphi PDF Library(PDFlibPas)從 v3.539.45 起,以明確堆疊加已造訪集合走訪 PDF 名稱樹與數字樹,環狀 /Kids、共用的子節點與數千層深的樹不再燒光呼叫堆疊、也不再重複條目。從 v3.539.51 起,缺失、畸形或反向的 /Limits 對再也藏不住握有鍵值的分支。具名目的地、頁面標籤、附件與文件層級 JavaScript 全都從這兩條程式路徑讀取,這使它們成為任何不是您自己產出的 PDF 之攻擊面的一部分
觸發它的東西很少見得刁鑽。fuzzer、惡意上傳或有毛病的增量儲存,寫出一條指回祖先的 /Kids 條目,遞迴走訪器就在兩 KB 的檔案上死於堆疊溢位。更安靜的失敗,是查找信了一個壞掉的 /Limits 陣列,對明明就在那裡的目的地回報「找不到」
名稱樹與數字樹在 PDF 裡出現在哪裡?
凡是 PDF 要把一大組鍵值映射到物件的地方,就會出現名稱樹與數字樹,而 PDFlibPas 至少有四處經公開 API 讀它們。ISO 32000-1 §7.9.6 定義名稱樹(字串鍵,表 36),§7.9.7 定義數字樹(整數鍵,表 37)。兩者都是大致平衡的樹:根與中間節點帶 /Kids,葉節點在 /Names 或 /Nums 裡帶排序過的鍵值對,非根節點帶一個兩元素的 /Limits 陣列,記下其下最小與最大的鍵
| 樹 | 所在位置 | 規格條目 | PDFlibPas 讀取 API |
|---|---|---|---|
| 具名目的地 | 名稱字典裡的 /Dests | §12.3.2.3 | GetNamedDestination,接著 GetDestPage / GetDestType |
| 頁面標籤 | 目錄裡的 /PageLabels(數字樹) | §12.4.2 | GetPageLabel |
| 附件 | 名稱字典裡的 /EmbeddedFiles | §7.7.4, §7.11.4 | EmbeddedFileCount、GetEmbeddedFileStrProperty |
| 文件層級 JavaScript | 名稱字典裡的 /JavaScript | §7.7.4 | GlobalJavaScriptCount、GlobalJavaScriptPackageName |
表裡有兩個細節容易漏看。具名目的地還有 PDF 1.1 的舊形式:目錄裡一個以 name 物件為鍵的普通 /Dests 字典,GetNamedDestination 會先查那個字典,才深入 PDF 1.2 的名稱樹。另外 GetDocJavaScript 根本不是名稱樹讀取器:它回傳的是目錄 /AA 字典裡掛在文件觸發器上的腳本(WS、DS、WP、DP、DC),而文件開啟時執行的具名腳本套件住在 /JavaScript 名稱樹裡
那些結構的每一個位元組都來自檔案。規格書說的是寫入端該產出什麼,它攔不住讀取端收到別的東西——強化 Pascal PDF 剖析器以抵禦惡意檔案背後是同一課,這裡套用的對象是樹的形狀,不是緩衝區大小
環狀 /Kids 陣列為什麼會讓遞迴樹走訪器崩潰?
環狀 /Kids 陣列會讓遞迴走訪器崩潰,是因為遞迴過程裡沒有任何東西注意到「這個節點我見過」,於是引用自己祖先的子節點把有限的檔案變成無限下探。v3.539.45 之前,NameTreeLookup、NumTreeLookup、EnumNumTree 與內部的 TPDFNameTree.ProcessNode 都是每個子節點呼叫自己一次。單一個自引用就足以終結行程,而一棵合法但極深的樹什麼環都不用,也能做到同樣的事
溫和一點的變體不改崩潰、改弄髒結果。兩條 /Kids 條目引用同一片葉子時,天真的列舉會造訪它兩次,附件計數或腳本套件清單就報出了不存在的條目
修法是用堆積上明確的後進先出堆疊加一個以字典身分為鍵的已造訪集合,取代遞迴。節點在彈出時標記、不是推入時標記,所以環狀引用可能在堆疊上短暫停留,但一回彈上來就遭丟棄。每個相異節點恰好展開它的子節點一次,總工作量因此以相異字典數量加上 /Kids 陣列總長度為上界。深度不再要緊:4,096 層的鏈只是迴圈的 4,096 次迭代,加雜湊集合裡的 4,096 個條目
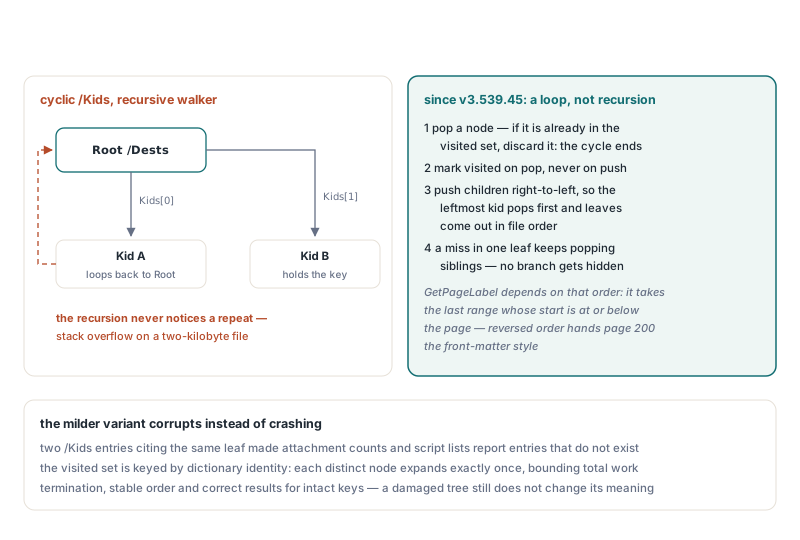
不過順序仍然要緊,堆疊得倒著餵才保得住它。子節點從最後一個索引推到第一個,所以最左邊的孩子最先彈出,葉子出來的順序正是產生者寫下的由左至右。GetPageLabel 指望這一點:它走訪每一個列舉到的範圍、套用起始索引不大於頁碼的最後一個,列舉一旦反序,第 200 頁會不聲不響拿到前置頁的樣式。下面的骨架以抽象節點型別示範這個模式,不綁任何 PDF 物件模型
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // 葉節點上為空
    Keys: TArray<string>;      // 葉鍵,規矩的產生者會排序
    Values: TArray<Integer>;   // 與 Keys 平行
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits 只是提示:只有格式完好且有序的對才能修剪分支
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // 環或共用子節點:見過了
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // 由右至左推入,最左邊的孩子最先彈出
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // 這片葉子裡沒找到不代表結論:繼續彈兄弟
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
查找為什麼不能在第一個範圍匹配的分支上停手?
查找不能在第一個範圍匹配的分支上停手,因為真實檔案裡的 /Limits 範圍可能重疊、可能說謊,宣稱握有鍵值的分支不必然是真正握著它的分支。v3.539.45 之前的查找,對第一個 /Limits 覆蓋鍵值的子節點設下 Found 旗標、深入其中、再也不看別的兄弟。那個孩子若空空如也、內容過期、或是繞回根節點的環,答案就是 nil,哪怕隔壁兄弟明明握著鍵值
重寫的 FindTreeValue——如今 NameTreeLookup 與 NumTreeLookup 都靠它——會推入每一個範圍不排除鍵值的子節點,持續彈出直到找到匹配或堆疊清空。某片葉子裡撲空就只是某片葉子裡撲空。格式完好的樹上這不花額外成本;損壞的樹上多付幾次節點造訪,換回正確的答案
葉內搜尋走同一套哲學。ISO 32000-1 要求 /Names 陣列裡的鍵按位元組值排序,所以葉內先做二元搜尋。失敗的話,PDFlibPas 後備成對鍵值對的線性掃描,因為亂序的葉子若不如此,會讓存在的鍵隱形。排序是快速路徑,不是過濾器
對一種結構矛盾,查找也拒絕猜。表 36 讓節點攜帶 /Kids 或 /Names、絕不同時擁有兩者,查找路徑把兩者皆備的節點當畸形、直接跳過,不替它挑一種解讀。EnumNumTree 這類列舉路徑則寬鬆些,兩者都在時跟著 /Kids 走
讀取端可以拿 /Limits 信什麼?
讀取端對 /Limits 最多只能信到「省掉一些工作」,絕不能信到「斷定鍵值不存在」,而且前提是那個對格式完好。表 36 說中間與葉節點應攜帶 /Limits,以最小與最大鍵組成的兩元素陣列,但實務上手動編輯之後條目會不見、名稱樹裡會裝著數字、邊界會對調著送來。PDFlibPas v3.539.45 與 v3.539.51 對每種情況一視同仁:範圍讀不成正確型別的有序對,子節點就保持可搜尋
- 缺失的
/Limits:舊範圍檢查回傳 False、子節點整個被跳過,忘了寫條目的產生者於是讓整棵子樹不可達。v3.539.45 起子節點會被搜尋 - 型別錯或長度錯,例如名稱樹裡裝數字、或只有一個元素的陣列:v3.539.45 起按缺失條目完全相同的方式處理
- 反向邊界,如
[(Z) (A)]或[9 0]:v3.539.45 仍照用它們,而Lo > Hi時沒有任何鍵能滿足Lo <= Key <= Hi,分支於是對每次查找都被排除。v3.539.51 起,範圍只有在下界不大於上界時才用於修剪 - 格式完好、有序且正確:用來跳過分支,這正是這個條目存在的全部意義
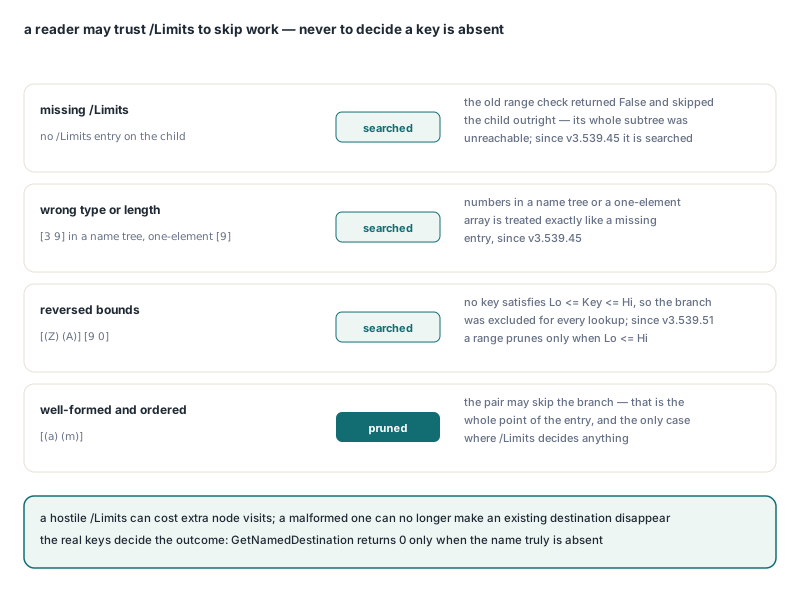
每一種情況下,裁決結果的都是真正的鍵。惡意的 /Limits 能讓 PDFlibPas 多造訪一些節點,但畸形的一個再也無法讓一個存在的目的地憑空消失。呼叫端什麼都不用改:GetNamedDestination 在名稱真的不存在時回傳 0,否則回傳目的地 ID,接下來交給目的地函式
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // 先查目錄 /Dests(PDF 1.1),再查 /Dests 名稱樹
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;對一份手工打造的檔案跑這段程序——/Dests 根節點有一個子節點在 [(a) (z)] 範圍下繞回根節點、另一個子節點在反向的 [(z) (a)] limits 下握著真正的條目——它會把目的地解析到第 2 頁、檢視型別 2(Fit)。v3.539.45 之前,同樣的查找回傳 0,因為繞圈的子節點先認領了鍵值,搜尋永遠到不了它的兄弟;只有 v3.539.45 時仍回傳 0,因為反向範圍把真正的葉子排除了。接著要讀指向這些目的地的書籤大綱的話,在 Delphi 讀取 PDF 書籤與註解動作那篇姊妹文涵蓋動作那一側
32,769 個名稱的葉子是怎麼弄壞 TPDFNameTree 的?
32,769 對名稱/值的葉子弄壞了 TPDFNameTree,因為它內部的 FindIndex 把兩個數字打包進一個 32 位元 Integer:高 16 位放葉子在內部陣列清單裡的位置,低 16 位放條目在該葉 /Names 陣列內的偏移。每對佔兩個陣列槽位,所以第 32,769 對——對索引 32,768——起始偏移是 65,536,即 $10000。這個值進位到高半部,解碼時被讀成下一片葉子的偏移 0
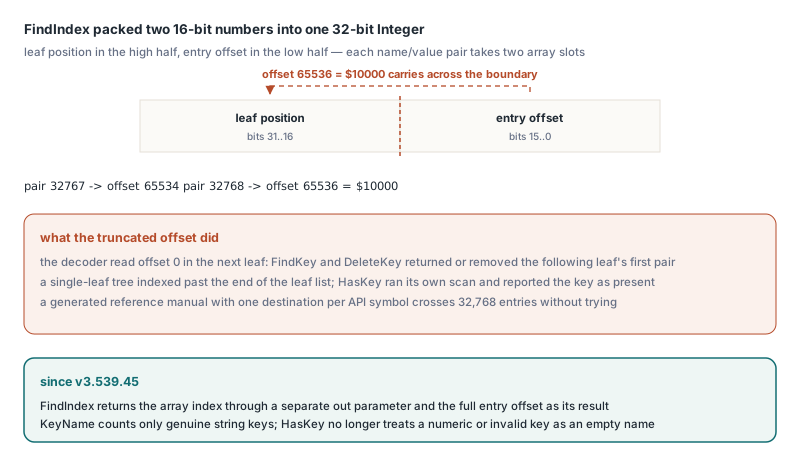
附件、全域 JavaScript 套件與具名目的地寫入背後的類別都是 TPDFNameTree,後果因此很具體。單葉樹沒有下一片葉子,FindKey 與 DeleteKey 便索引過了葉清單的結尾;多葉樹裡它們回傳或刪掉的是下一片葉子的第一對、而不是您要的那對。與此同時 HasKey 跑自己的掃描、如實回報鍵存在,類別於是自相矛盾。每個 API 符號一個具名目的地的自動產生參考手冊,毫不費力就突破 32,768 個條目,而有些產生者把它們全部寫進一片扁平的大葉子
從 v3.539.45 起,FindIndex 用獨立的 out 參數回傳陣列索引、以函式結果回傳完整條目偏移,兩個值都不再被截斷。同一版還收緊了兩個鄰居。KeyName 現在只計數並回傳真正的字串鍵,索引為 0 或以下時回傳空字串——先前它會把無效鍵後面跟著的任何物件硬轉型。HasKey 不再把數字或其他無效鍵當成空名稱。對 [(Valid) 42 123 456] 這樣的葉子,HasKey('') 現在是 False,KeyName(2) 回傳空字串
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // /PageLabels 數字樹;沒有的檔案回傳普通頁碼
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // /EmbeddedFiles 名稱樹;索引從 1 起算,非字串鍵跳過
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // 名稱、MIME 類型
    // /JavaScript 名稱樹:列出套件名稱,什麼都不執行
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;同一份手工檔案——/PageLabels 根節點把一片葉子列了兩次、還引用自己——跑這段稽核,兩頁各印出 i 與 A-1,每個範圍恰好一次,外加來自同樣指回自己根節點的 /JavaScript 樹的那個腳本套件。頁面標籤的寫入端跟 /Kids 根節點也有一段歷史,見 修正存放在 /Kids 數字樹裡的 PDF 頁面標籤;AddPageLabels 插入前會先把這種根節點攤平,靠的正是這裡描述的 EnumNumTree 列舉
這番強化仍然不保證什麼?
這番強化保證終止、順序穩定,以及對真實鍵值完好的樹給出正確結果;它不能讓損壞的樹變回作者原本想表達的意思。在它之上蓋東西之前,有幾條界線值得知道
- 已造訪集合按物件身分運作。兩個內容相同但各自獨立的字典是兩個節點,用複製代替引用的產生者照樣會產出重複條目
- 格式完好、有序但內容錯誤的
/Limits照樣修剪。把範圍當最佳化的讀取器,不可能同時對一個騙得很像樣的範圍免疫;唯一的替代方案是完全無視/Limits、掃每一片葉子 - 列舉保留檔案順序、但不排序。
GetPageLabel套用列舉到的不大於頁碼的最後一個範圍,亂序寫範圍的產生者得到的就是檔案順序語意 - 記憶體隨相異節點與條目數量增長。走訪只是多了一個清單與一個雜湊集合,僅此而已,但 100 MB 的名稱樹剖析完還是 100 MB 的名稱樹
- 同一片葉子裡的重複鍵不予回報。二元搜尋回傳先撞見的那個匹配對;線性後備保留掃到的最後一個匹配
速查:從不可信檔案讀取 PDF 樹
- 升級到 v3.539.45 以上,名稱樹與數字樹的走訪才環安全、堆疊安全;升級到 v3.539.51 以上,反向的
/Limits才藏不住鍵值 GetNamedDestination回傳 0 視為「不存在」,GetDestPage回傳 0 視為「存在但不可用」/JavaScript名稱樹用GlobalJavaScriptCount與GlobalJavaScriptPackageName;GetDocJavaScript讀的是目錄/AA觸發器- 附件與腳本套件從 1 索引到函式庫回報的數量;無效鍵不計入
- 您自己的樹程式碼:彈出時標記已造訪、反向推入子節點,
/Limits只有在型別正確且有序時才准修剪
預檢工具、壓縮解包器與檢視器在任何頁面渲染之前就要讀這些樹,所以它們必須扛得住上傳佇列送來的任何東西。上述樹讀取器隨 PDFlibPas(Delphi PDF Library)出貨,Delphi 與 Free Pascal 都能建置