LZW 編碼器的字典永遠比即將讀取它輸出的解碼器多一筆條目,所以兩側無法共用單一的碼寬門檻。PDFlibPas 讓 TPLLZWEncoder 與 TPDFLZWDecompressor 各自持有一組由同一個 EarlyChange 旗標推導出的門檻,而這一筆的領先正是這個旗標存在的全部理由
幾乎每個手刻的 LZW 實作都會在同一個地方搞錯。你先寫解碼器,因為開檔需要它。它能用。接著寫編碼器,因為 LZW 看起來對稱,就把解碼器邏輯一行行照抄,跑一輪 round-trip 測試,過了。你出貨。六個月後客戶用別家的檢視器打開你的輸出,從串流中段某處開始全是垃圾。鏡像複製就是 bug:LZW 的兩半並不對稱,假裝它們對稱,只會產生只有你自己的程式讀得懂的串流
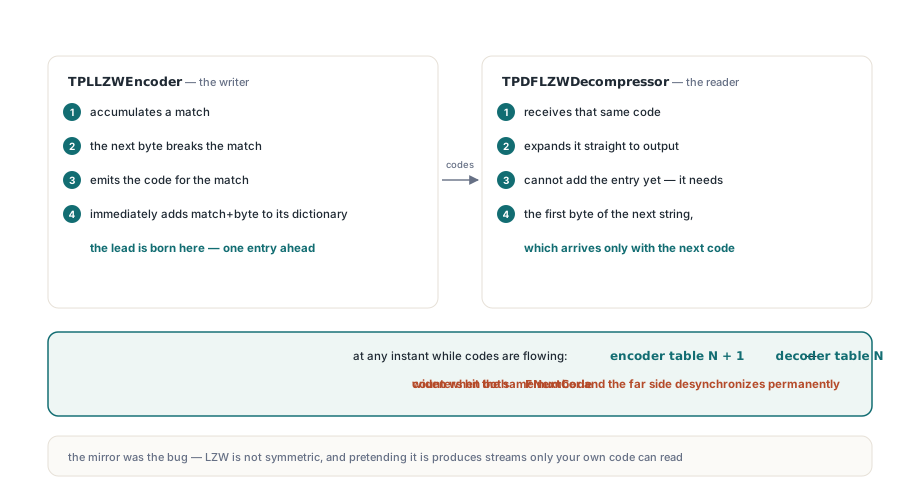
編碼器為什麼需要與解碼器不同的門檻
因為編碼器學會每個字典條目的時機比解碼器早一步。這不是 PDFlibPas 的設計選擇,而是 LZW 的內在性質,每個正確實作都必須在某處補償它。走一遍迴圈就能看出領先從哪來。編碼器累積一個配對,發現下一個位元組會打破它,就發出配對的碼,然後立刻把配對加位元組加入自己的字典。解碼器收到同一個碼並展開它,但此刻還不能加入對應條目,因為新條目需要下一條字串的第一個位元組,而它要隨下一個碼才會到達。所以只要碼在流動,編碼器表格就比解碼器表格多一筆。如果兩側在自己的 FNextCode 碰到同一個數字時都把碼從 9 位元加寬到 10 位元,它們會差一個碼加寬,遠端的位元讀取器就永久失去同步。在 TPDFLZWDecompressor.ResetDictionary 裡,解碼器門檻只算一次並存入 FChangeCode:
// TPDFLZWDecompressor.ResetDictionary:門檻的解碼器這一側
FCodeSize := FInitialCodeSize;                 // 對 PDF LZWDecode 而言是 9
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // 當 FNextCode 到達 511 時加寬
else
  FChangeCode := FBitMask + 1;                 // 當 FNextCode 到達 512 時加寬
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
解碼迴圈在追加條目之後立刻加寬,測試 (FNextCode = FChangeCode) and (FCodeSize < 12),並為新寬度重算 FBitMask 與 FChangeCode。九位元在 511 或 512 觸發,十位元在 1023 或 1024,十一位元在 2047 或 2048,而十二位元是天花板,字典必須用 ClearCode 清空而不是繼續長大。編碼器不能沿用任何一個數字。它的 GrowCodeSize 會加一來補償領先,所以設了 EarlyChange 時它在 512 加寬,而解碼器在 511 加寬:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 在 9 位元時是 512
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 在 9 位元時是 513
  // 解碼器在讀 EOI 之前會先加入它最後一個待處理條目。
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;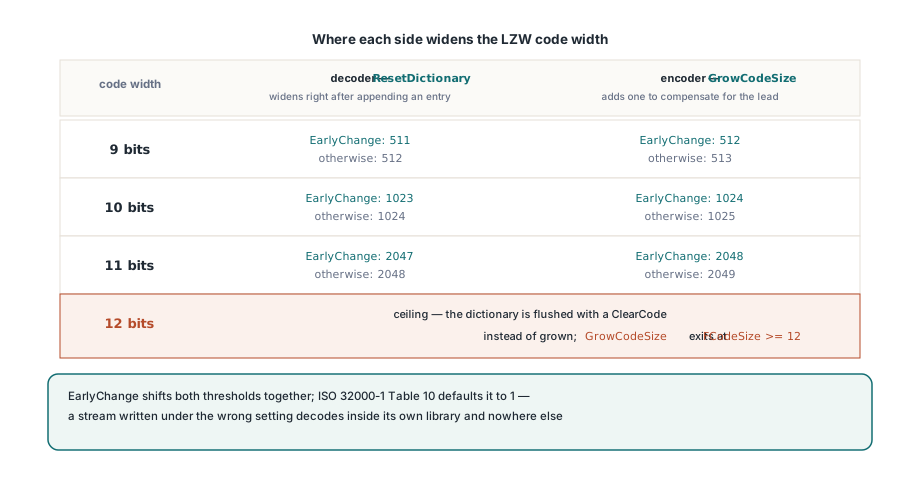
最後一個資料碼是兩側終於會合的地方
串流結尾是編碼器唯一必須停止領先、像解碼器一樣思考的地方,這就是 GrowCodeSize 的 FinalDataCode 參數的用途。用錯寬度發出 EOI 碼,之前的一切仍然完全有效,所以缺陷會藏在幾千個正確位元組後面。過程是這樣的。編碼器發出最後一個資料碼,而且不像之前的每一次疊代,之後不再往自己的字典加任何東西,因為已經沒有下一個位元組可以延伸配對了。解碼器相反:它收到那個最後的碼,到現在才能完成從上一個碼就握著的條目。在最後一步解碼器追上,領先歸零,而它用來讀 EOI 的寬度是由一個編碼器從未建立的條目決定的。Dec(ChangeCode) 就是編碼器在恰好一次呼叫裡假裝自己是解碼器:
// TPLLZWEncoder.Compress,串流的尾端
EmitCode(CurCode);      // 最後的資料碼,用目前當下的寬度
GrowCodeSize(True);     // 可能用減一後的門檻加寬
EmitCode(FEOICode);     // 用解碼器實際會讀的寬度發出 EOI
FlushBits;
FlushOutput;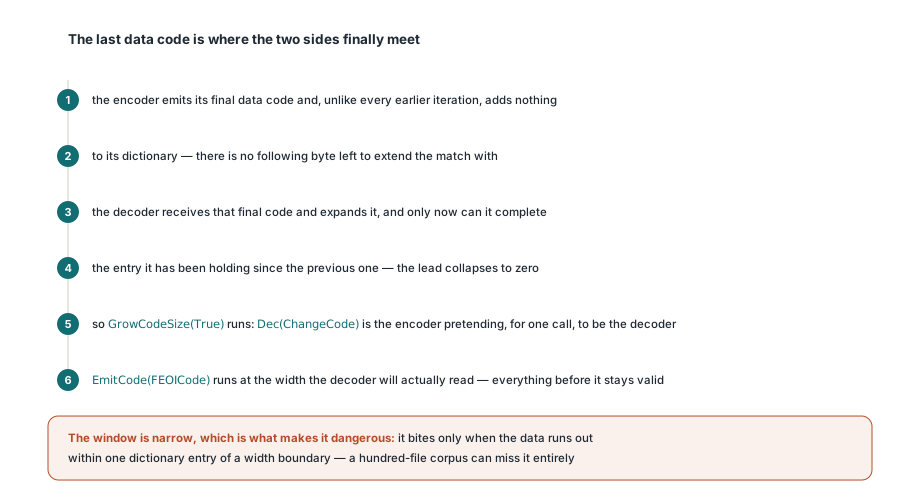
這件事要緊的窗口很窄,這正是它危險的地方。它只在資料剛好在寬度邊界一個字典條目內耗盡時咬人,一百個測試檔案可以完全漏掉它,而某個客戶檔案每次都會命中。Compress 的邊界案例必須刻意驅動:構造字典落在 510、511、512 條目的輸入,然後手動從串流讀出發出的 EOI 位元寬度,而不是從一次成功的解碼去推斷
為什麼通過的 round-trip 測試仍可能藏著壞掉的串流
因為犯了同一個錯誤的兩個實作會彼此認同。如果你的編碼器與解碼器都早一個碼加寬,或都晚一個碼加寬,它們會保持同步,round trip 逐位元組重現輸入,測試套件全綠,而你產出的串流別的東西都讀不了。這是整件事最值得帶走的一課:對 LZW 來說,自我一致性作為證據一文不值。所以自我 round-trip 不能當主要測試,PDFlibPas 改用另外三種方式驗證 LZW 路徑。手建碼串,把預期的位元模式逐位元組手寫出來,讓斷言針對位元組本身,而不是針對解碼它們的結果。與獨立實作的雙向互通,讓這個編碼器產出的串流在別處解碼、別處產出的串流由 TPDFLZWDecompressor 解碼。以及差分解碼,把同樣的位元組用 EarlyChange 兩個方向各讀一次,讓一個在錯誤設定下仍能乾淨解碼的串流告訴你寬度邊界根本沒被碰到:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // 刻意使用對 PDF 而言錯誤的規則
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A 必須與來源一致;B 一定不能一致。如果 B 也一致,
// 代表輸入太短,沒能跨過任何碼寬邊界。
真正給出覆蓋的是外部輸入。目前的測試素材跨過 9、10、11、12 位元寬度,並在單一串流中強制 34 次字典重設,這是唯一能在 4095 天花板上證明 ClearCode 路徑真的可行的實際方式。如果你的 fixtures 從不超過幾 KB,那段程式碼一次都沒跑過。而當某個修復改變了你的編碼器產出時,把舊輸出當成壞掉的東西,而不是值得保留的相容性基準;混錯碼寬的串流不是老舊格式,是碰巧被寫進磁碟的 bug
PDF 說 1,TIFF 說看情況
PDFlibPas 在 TPLLZWEncoder 與 TPDFLZWDecompressor 上都把 EarlyChange 預設為 True,因為 ISO 32000-1 Table 10 把 EarlyChange 定義為 LZWDecode 的解碼參數,預設值 1,意思是碼長度提前一個碼增加。這是與 predictor 參數一起寫在 ISO 32000-1 第 7.4.4.2 節的,想要另一種行為的 PDF 必須在 /DecodeParms 字典裡明確寫 /EarlyChange 0。TIFF 是這個旗標成為屬性而非常數的原因:TIFF 6.0 第 13 節描述 LZW 壓縮時沒有同樣毫不含糊的陳述,實際世界的編碼器向來在此分歧,這很可能正是 PDF 規格覺得需要命名這個參數的原因。在 TIFF 轉 PDF 的管線上,這個設定不是任何一端可以寫死的。TIFF 那一側最終需要的值必須明確帶進 PDF 的 /DecodeParms,否則你就把一個原本開得起來的檔案轉成開不起來的。同樣的小心也適用在 FillOrder 上,foTop 與 foBottom 選擇位元讀取器從位元組哪一端開始填,以及 TIFF Predictor 2 的水平差分,由 TPDFLZWParms 透過 Predictor、Colors、BitsPerComponent、Columns 帶過去。強化內建 TIFF 解碼器以應付 BigTIFF 與平鋪版面的筆記涵蓋那條路徑的其餘部分
兩個值得一提的小陷阱
兩者都很容易在把編碼器與解碼器物件並排打開、又預設對稱性在那裡也成立時接錯:
InitialCodeSize在兩個類別上的意義不同。TPLLZWEncoder.InitialCodeSize是根符號寬度,驗證範圍 2 到 8,InitDictionary以1 shl FInitialCodeSize推導FClearCode並把FCodeSize設為FInitialCodeSize + 1。TPDFLZWDecompressor.InitialCodeSize是第一個碼寬度,驗證範圍 2 到 9,ResetDictionary以1 shl (FCodeSize - 1)推導FClearCode。對一般 8 位元 PDF 資料,預設值分別是 8 與 9,你永遠不會注意到;手動把它們設成同一個數字,你就建了一組不匹配的配對- 解碼不受信任的 LZW 首先是記憶體安全問題,然後才是正確性問題,因為字典索引直接來自檔案。
TPDFLZWDecompressor拒絕任何高於 4095 或等於高於FNextCode的碼,拒絕在超過 4095 之後加入條目,每次GetNextCode前先檢查剩餘輸入的位元數,並暴露SawExplicitEOI,讓呼叫端分辨正常終止的串流與只是位元組用盡的串流。被截斷的串流不是部分成功。強化 Pascal PDF 剖析器以應付惡意檔案的廣域調查涵蓋這些守衛關閉的缺陷類型
這一切留給你的是什麼
LZW 看起來對稱,其實不然。編碼器字典在串流主體中領先一筆,領先在最後一個碼時消失,所以正確實作要帶兩組門檻加一個特例,而 EarlyChange 旗標會一起平移兩組門檻。任何一側差一個碼,你就產出直到某個點都有效、過了就壞的輸出,沒有任何錯誤、任何例外,只有某個檢視器在渲染雜訊。誠實的界線是這一切從內部都無法測試:你自己套件裡的任何東西都無法區分正確串流與一貫錯誤的串流,所以互通性檢查不是可選的額外一輪,而是你唯一能得到真正證據的地方。兩個類別都隨 PDF Library for Delphi 出貨,它也處理 物件串流與交互參照串流筆記中描述的周邊結構工作,支援 Delphi 與 C++Builder 在程式庫支援的所有編譯器版本