拿一段報表產生器可能寫出的內容串流,BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET,把 1 0 0 1 0 0 Tm 刪掉,因為它的六個數字拼出單位矩陣。渲染結果,"Total" 不再從文字空間原點出發,而是從 "Invoice" 結束的地方出發,在同一條基線上。單位 Tm 只在文字矩陣與文字行矩陣已經是單位矩陣時才多餘:緊跟在 BT 之後,或緊跟在另一個單位 Tm 之後
這個刪除很誘人,因為同樣六個數字放在 cm 前面確實是死重量。把兩個運算子一視同仁的內容串流優化器,能正確縮小很多串流。然後它遇上一個拿單位 Tm 當歸位字元用的產生器,文字就挪位了
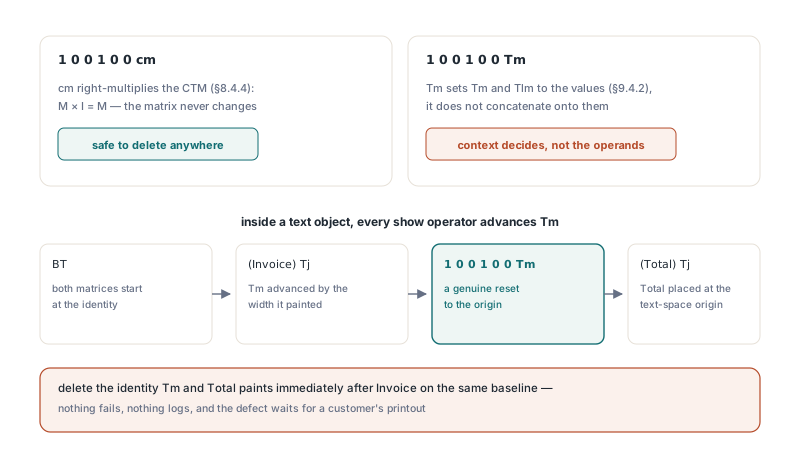
為什麼 1 0 0 1 0 0 Tm 不總是無操作?
兩個運算子做的是不同的算術。ISO 32000-1 §8.4.4 定義 cm 把它的運算元串接上當前變換矩陣;任何矩陣乘單位矩陣都得到原矩陣,所以 1 0 0 1 0 0 cm 出現在什麼地方都能刪。Tm 是賦值。按 §9.4.2,它把文字矩陣與文字行矩陣都設成自己的運算元,丟掉兩者原本持有的值,所以它是否改變了什麼,完全取決於它前面的運算子
§9.4.1 說 BT 把兩個矩陣都置為單位矩陣。從那裡開始,文字物件裡的幾乎一切操作都會移動其中至少一個。Td、TD、T* 與非單位的 Tm 重設文字行矩陣。每個顯示文字的運算子(Tj、TJ、' 與 ")都按剛畫出的字形寬度推進文字矩陣,後兩個還會先換新行。這些操作一旦跑過,單位 Tm 就是一次貨真價實的跳回原點。上面的發票串流依賴的正是這一跳
手動追蹤一遍串流就能立刻定案。把發票範例餵給內容串流 CTM 與文字矩陣狀態追蹤器,記錄顯示 cm 是往 CTM 上串接,而 Tm 直接覆寫兩個文字矩陣——相同的運算元背後藏著兩條不同的更新規則
PDF Library for Delphi 如何決定刪哪個單位 Tm
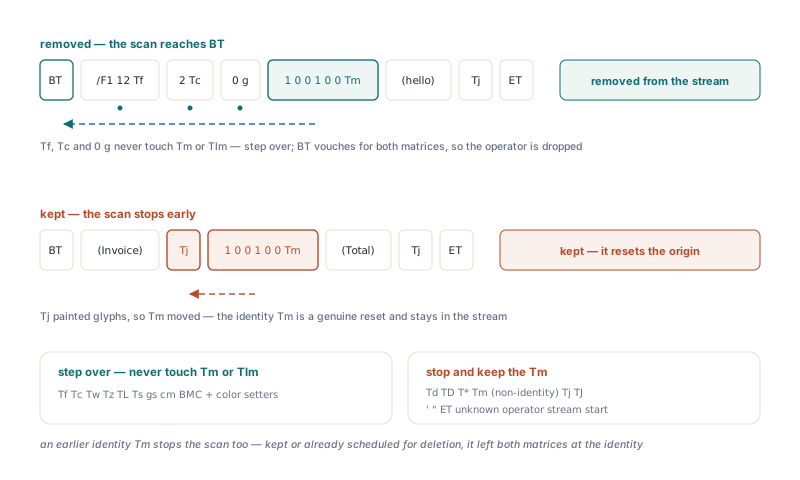
PDF Library for Delphi 在 peephole 階段刪掉每一個單位 cm,而單位 Tm 只有當從該運算子往回掃描、在遇到任何可能動過文字矩陣的東西之前先碰到 BT 或另一個單位 Tm 時才刪。「單位」的判定是數值性的:運算子必須帶恰好六個等於 1、0、0、1、0、0 的數字運算元,所以 1.0 0 0 1.0 0 0 Tm 同樣合格。往回走時,掃描把遇到的每個運算子歸入兩組之一:
- 停下並保留 Tm:
Td、TD、T*、非單位的Tm、Tj、TJ、'、"、ET、剖析器不認得的任何運算子,以及串流的起點 - 跨過並繼續掃描:從不觸碰文字矩陣與文字行矩陣的運算子,例如
Tf、Tc、色彩設定、gs、標記內容運算子、Do與cm
更早的單位 Tm 也會結束掃描、判決刪除,無論優化器是保留它還是已把它排入刪除。無論如何,它都把兩個矩陣留在了單位狀態,與 BT 留下的狀態相同。這就是 BT 之後連著三個單位 Tm 會縮減為零的原因
保守的停點是刻意的。未知運算子可能是什麼都做得出來的廠商擴充,掃描拒絕對它做任何推理。在 ET 之後沒有開啟的文字物件,坐在那裡的單位 Tm 沒有任何 BT 為矩陣值作保。掃描一次也只看一個內容串流。這對 /Contents 是陣列的頁面很重要:PDF 允許一個文字物件從一個串流開始、在下一個串流延續,所以在文字物件中間開場、自己沒有 BT 的分層,即使前一層會讓它變得多餘,也保留它的單位 Tm
我們認為該往保守的一側犯錯。跨串流邊界追蹤矩陣,或模擬未知運算子,換來的大概是每份奇怪檔案十四位元組的未壓縮文字。做錯了,印出來的發票上就挪了一個字形。成本與風險根本不在同一個量級
有一個連帶效果值得知道,因為它改變你在輸出裡看到的東西。同一個階段也會移除裡面空無一物的文字物件,所以 BT 1 0 0 1 0 0 Tm ET 整個消失:單位 Tm 先走,留下的 BT/ET 對是空的
在內容串片段上跑優化器
優化器作用於同一個剖析後的 TPDFContentProgram 模型,就是你在字元到內容位元組映射走讀裡用來在指令層級編輯頁面文字的那個模型。這讓你在把規則交付給整份文件之前,先拿一個字串試刀變得容易。下面的輔助函式剖析解碼後的串流,跑 TPDFContentPeepholeOptimizer,並按每行一條指令輸出結果。在 Parse 之前設 CanonicalNumbers,與存檔階段的行為一致——它在固定精度上改寫每個數字
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // 與存檔階段相同的數字處理
    if not Prog.Parse(Source) then
      Exit; // 結構嚴重損壞:位元組原樣保留
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // 回傳移除的指令數
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // 每行一條指令,以 #10 分隔
  finally
    Prog.Free;
  end;
end;

// 移除:BT 之後的 Tm,以及連續兩個單位 Tm 中的第二個
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// 保留:Td 之後、Tj 之後、非單位 Tm 之後,或 BT 之外的 Tm
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
把發票串流丟進去,單位 Tm 活下來,因為往回掃描遠在碰到 BT 之前就撞上 Tj。在 BT 與單位 Tm 之間放 /F1 12 Tf、2 Tc 與 0 g,它仍然被刪,因為那些都不碰文字矩陣。有趣的案例是 BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm:它恰好失去一個運算子。第一個單位 Tm 抵消了 Td 的移動,只有第二個是多餘的
Parse 只在嚴重損壞——未結束的字串或字典之類——時回傳 False。未知運算子剖析正常、留在程式裡,成為掃描的硬停點
peephole 優化器實際什麼時候執行?
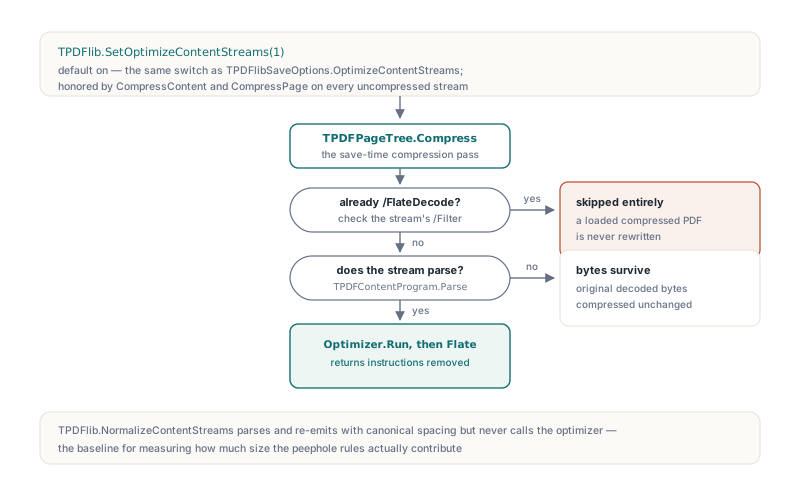
優化器只在壓縮階段內執行,而且只作用於尚未 Flate 壓縮的頁面內容串流。TPDFlib.SetOptimizeContentStreams(1) 是預設值,同一個開關也以 TPDFlibSaveOptions 的 OptimizeContentStreams 欄位出現;CompressContent 與 CompressPage 都遵循它。/Filter 已是 /FlateDecode 的串流完全跳過,所以載入一份典型已壓縮的 PDF 再存一次,它的運算子原封不動。以未壓縮形式存放的串流則被解碼、優化、然後 Flate 壓縮。串流剖析失敗時,其原始解碼位元組原樣壓縮
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // 未壓縮的頁面串流先過 peephole 規則,再 Flate 壓縮
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // 經由整組存檔選項做同一個選擇;False 表示退出
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
讓預設開著。階段裡的每個變換都輸出等價,而單位矩陣規則針對的是很多產生器都會寫的模式——每個文字物件都以 BT 1 0 0 1 0 0 Tm 開場。把它關掉主要在兩種情況有意義:你想拿自己的未壓縮輸出與你寫下的內容做 diff,或你需要一條基準線。要那條基準線,TPDFlib.NormalizeContentStreams 以正規的間距與數字剖析並重新輸出內容,但從不呼叫優化器,正規化存檔與優化存檔之間的體積差,就是 peephole 規則貢獻的部分。與搭配字型子集化的 PDF 檔案體積優化一文描述的那些更大收益相比,預期它只是零頭
覆蓋一種形狀的測試定義不了規則
把 BT 1 0 0 1 0 0 Tm (hello) Tj ET 餵給優化器、斷言沒有 Tm 殘留的測試,釘死的是一種形狀:緊跟 BT 之後的單位 Tm 會被移除。它對 Td 之後或已顯示文字之後的單位 Tm 隻字未提。把這條單一斷言讀成「單位 Tm 總是可移除」是個容易犯的錯,而且代價高昂,因為樣本兩種情況下都通過。任何這類規則的測試,都需要把必須保留的形狀寫在可移除形狀的旁邊
下面的輔助函式數出存活的 Tm 運算子,然後對照一張輸入表檢查。把 ExpectTm 換成你測試框架的斷言;它不是函式庫的一部分
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 表示剖析失敗
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// 你自己的檢查輔助函式,這裡僅建議;請換成真正的斷言
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // 可移除的形狀
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // 必須保留單位 Tm 的形狀
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // 沒有外層 BT
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // ET 之後
end;
最後兩行看起來無厘頭,直到你想起分層的 /Contents 陣列產出的正是這種片段。從文字物件中間開場的串流沒有 BT;ET 之後的單位 Tm 不屬於任何文字物件。兩個都留下。最後一行裡空的 BT ET 對由空文字物件規則移除,所以計數檢查的是 Tm 運算子,而不是比較整串字串
這條規則放棄的,是文字物件中間偶爾出現的單位 Tm——在 Flate 看到它們之前每頁幾個位元組。它換來的是優化器設計所依賴的保證:階段裡的任何變換都不改變可見的頁面。一個會挪動文字的體積優化器,是一個壓縮比不錯的渲染 bug
如果你在 Delphi 或 C++Builder 中產生或後處理 PDF 內容,PDF Library for Delphi and C++Builder 隨附內容串流剖析器、這個 peephole 階段與上面展示的存檔選項,還有用來產生乾淨、未優化基準線以供對照的 NormalizeContentStreams