FDF 註解匯入器可能回傳它解析了幾條條目,卻一條也沒加進文件:每條都被計數,每條都被丟棄。losLab PDF Library 的 TPDFlib.ImportAnnotationsFromFDFString 以任意鍵序讀取、正確且與地區無關地解析 /Rect、回傳實際加入的註解數,而配套的匯出器寫出註解真實的 /Rect,於是一次匯出、匯入再匯出得到位元組相同的 FDF。這篇筆記的其餘部分說明:一個錯誤的起始位移如何造就一場完美的無聲失敗、它背後藏著哪三個陷阱,以及如何自己驗證匯入而不是相信回傳值
場景再平常不過。審閱者在合約上做了標註,註解以一份 FDF 檔傳來(Acrobat 稱之為 Export Comments),您的 Delphi 服務用一次 FDF 匯入呼叫把它們合併進乾淨的副本。呼叫回傳 7,日誌寫著「已匯入 7 條註解」,工作亮綠燈,而輸出的 PDF 一條註解都沒有。沒有例外、沒有警告,那個數字看起來又合理——因為它正是檔案裡條目的真實數量。這是 bug 能有的最糟形狀:一個函式唯一的成功訊號,是一個與它宣稱回報的工作互相獨立計算出來的計數器
FDF 匯入為什麼可能回報成功、卻什麼都沒加?
因為名稱讀取器可能從錯的位置起步,而計數器可能住在真正做工的程式碼之外。一個回傳 /Subtype 之後緊鄰位置的鍵搜尋,落點是值前面的空白。從那個空白起步、遇到第一個空白字元就停的 ReadName,什麼都沒讀就停了,於是每個 subtype 都回傳空字串。像 AddAnnotationToPage 這樣、沒有 subtype 就拒絕建立註解的輔助函式,單獨看是正確的防禦選擇;但如果它是個沒有回傳值的 procedure,而呼叫端的 Inc(Result) 又在它外面,兩道防護合起來就把「什麼都沒成功」翻譯成「全部成功」。正確的名稱讀取器會跳過空白、要求 PDF 名稱物件的前導 /、並停在任何分隔符上——包括 [、( 與 )——所以 /Subtype/Text 與 /Subtype /Text 都得到 Text;losLab PDF Library 就是這樣讀名稱的
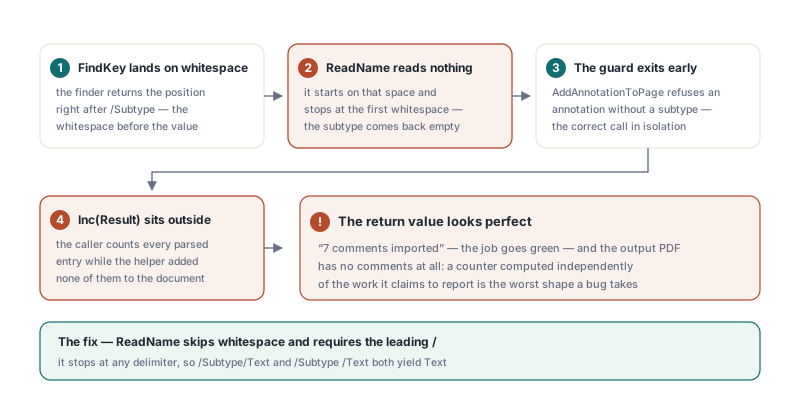
回傳值在這之外也值得細究。一個對 /Annots 陣列裡每個格式完好的字典都遞增的匯入器,在條目帶著超出範圍的 0 起算 /Page 或缺少 /Subtype 時仍然多報——這兩種條目都會被跳過。losLab PDF Library 裡,ImportAnnotationsFromFDFString 與 ImportAnnotationsFromFDF 回傳實際加入的註解數,與 XFDF 匯入一致:FDF 輔助函式 AddAnnotationToPage 回傳 Boolean,計數器只在成功時前進。量測文件仍是更強的檢查,因為無論數字出自哪段程式碼它都成立,所以下面的草稿在匯入前後比較每一頁的 AnnotationCount
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // 按選中的頁計數,含 widget
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // 每條條目都落到頁面上時兩者相等
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
躲在第一個陷阱後面的另外三個
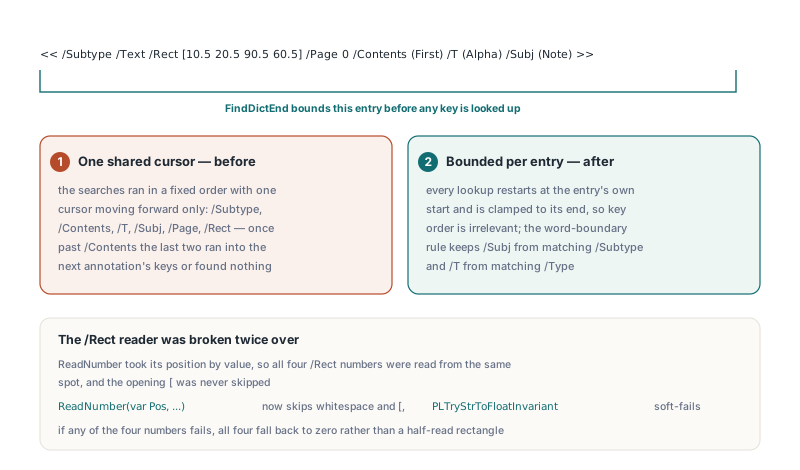
只修 subtype,同一類解析器裡還會接連浮出三個陷阱;只要從來沒有註解真正落到頁面上,它們每一個都是隱形的。第一,把位置當值參數的 ReadNumber,為 /Rect 的四個數字依序呼叫時會在同一個位置讀四次;而如果它不跳過開頭的 [,實務上等於什麼都沒讀。第二,讓所有查詢共用一個只會前進的游標的 FindKey,命運取決於鍵序。匯出器可能按 /Subtype、/Rect、/Page、/Contents、/T、/Subj 的順序寫,而匯入器按 /Subtype、/Contents、/T、/Subj、/Page、/Rect 的順序搜;游標一過 /Contents,對 /Page 與 /Rect 的搜尋就衝出當前條目,要嘛一無所獲、要嘛配到下一條註解的鍵——匯入器連自家匯出器的輸出都讀不了。第三,經由追隨系統小數分隔符的常式(如 PLStrToFloat)解析數字,在逗號地區的機器上就會出錯。ISO 32000-1 §12.7.7 把 FDF 定義成 PDF 物件語法,而 PDF 的字典鍵無序(§7.3.7),所以任何假設鍵序的 FDF 解析器在構造上就是錯的,無論檔案出自哪個工具
losLab PDF Library 先為每個條目定界。FindDictEnd 從開頭的 << 走到配對的 >>,追蹤巢狀字典、連同反斜線跳脫一起跳過字面量字串的內容,所以註解裡像 (see section >> 4) 這樣的 >> 無法提前結束條目。之後每次鍵查詢都從條目自己的起點出發、以它的結尾為界,鍵序從此無關緊要,一條註解也借不到別條的 /Page。鍵比對還接受名稱後緊跟的分隔符,因為 /Contents(Hi) 與 /Contents (Hi) 一樣合法;而單詞邊界規則讓 /Subj 配不到 /Subtype 的開頭、/T 配不到 /Type。ReadNumber 把位置宣告成 var 參數,跳過空白與 [,用 PLTryStrToFloatInvariant 解析——遇到畸形 token 溫和失敗而不是擲例外。四個矩形數字裡任何一個失敗,四個全部退回零,而不是產出半讀的矩形
為什麼 FDF 往返一趟,每條註解就可能上移自己的高度?
因為把矩形寫進錯的座標模型實在太容易。註解的 /Rect 是預設使用者空間裡的 [llx lly urx ury](ISO 32000-1 §12.5.2,矩形定義見 §7.9.5),FDF 帶的也是同一種陣列。但 GetAnnotRectEx 回報的是函式庫繪圖座標裡的 Left、Top、Width、Height——由 SetOrigin 控制的那個空間。把這四個值序列化成 [L T L+W T+H] 的匯出器,交給匯入器四個數字;原樣寫回成 PDF 矩形時,上緣落在左下角該在的位置,於是每往返一趟,每條註解就上移自己的高度。losLab PDF Library 的匯出器複製註解自己的 /Rect 數字——三位小數、點分隔、無指數——只有儲存陣列缺失或不是四個數字時才退回計算出的矩形
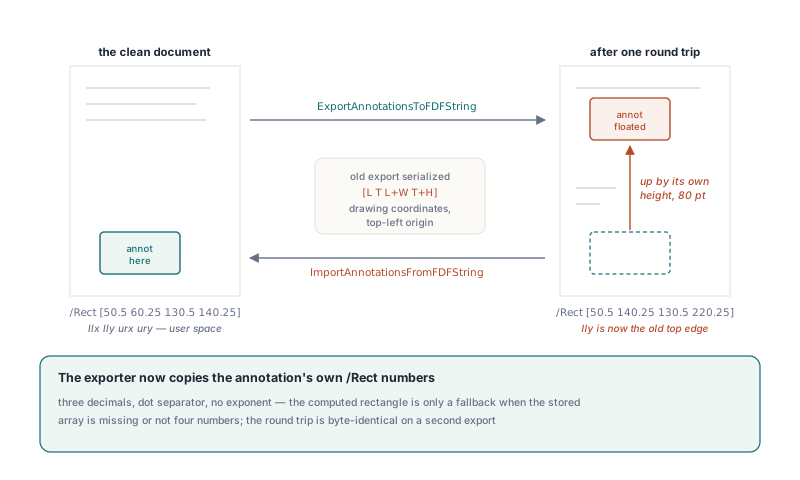
值得照抄的往返測試,斷言的是文件狀態與第二次匯出,而不是匯入器的回傳值。注意期望值是 2:AddNoteAnnotation 會建立一條 Text 註解加上它的 Popup,兩個都會跟著走。這個測試也在逗號小數分隔符下執行匯出與匯入——這個故事的另一半就住在那裡
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // 現在共兩頁
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // 模擬德語或法語的桌面環境
    try
      FDF := Source.ExportAnnotationsToFDFString;   // 仍寫出 /Rect [50.5 ...
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // 便條註解與它的 popup
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
FDF 這條路徑圍繞註解的核心字典建構。匯入器把每個條目重建成帶 /Type、/Subtype、/Rect、/Contents、/T 與 /Subj 的字典;匯出器則把 Widget 註解留給表單資料方法——表單欄位本來就屬於那裡。在依賴 FDF 傳遞顏色、旗標、框線樣式、popup 連結或外觀串流之前,先看FDF、XFDF 與 XFA 表單資料交換總覽裡「哪些資料走哪個方法」的完整地圖;如果需要檢查實際送達了什麼,GetAnnotType、GetAnnotTitle 與 GetAnnotContentsEx 這些按索引讀取的方法,見書籤、註解與動作的內省一文
怎麼讀逗號小數的 FDF 與 XFDF 檔?
FDF 的答案毫不含糊:逗號在 PDF 語法裡不是分隔符,所以一個恰好含一個逗號、不含點的數字 token,只可能是逗號地區機器寫出的小數。這種檔案確實存在,例如用系統地區格式化數字的匯出器寫出的 /Rect [10,500 20,250 40,750 60,125],而 ReadNumber 會在解析前把那個孤零零的逗號換成點。帶兩個逗號、或一個逗號加一個點的 token 則被拒收,不猜測。讀取器也不吃指數記法,這與 ISO 32000-1 §7.3.3 一致:PDF 數字從不使用指數
XFDF 比較麻煩,因為在 XML 屬性裡逗號就是分隔符。標準 XFDF(ISO 19444-1)寫 rect="50.5,80.25,70.75,100.125" 與 dashes="4,2";逗號地區系統上追隨地區的寫入器則產出 rect="50,500 80,250 70,750 100,125" 與 opacity="0,600"。losLab PDF Library 在兩個方向上都不變式地讀寫 XFDF 數字,並且只在「屬性按空白切開恰好得到預期數量的 token(rect 四個、opacity 與 width 一個)且每個 token 都是數字-逗號-數字的形狀」時,才透過 XFDFNormalizeLegacyDecimals 認出舊式形狀。標準的 rect 永遠不會誤配:它要嘛是帶三個逗號的單一 token,要嘛是逗號收尾的 token。dashes 刻意不動,因為 4,2 可能是兩段虛線長度,也可能是舊式的 4.2,沒有規則能分辨
const
  // 鍵序與匯出器相反,並帶逗號地區匯出的逗號小數
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // 新文件有一頁
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // 以點小數重新匯出為 XFDF:rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
註解匯入測試到底該斷言什麼?
有用的匯入測試斷言的是目標文件的狀態,絕不只有匯入器對自己的說法;在無聲歸零的失敗裡,回傳值恰恰是唯一完好無缺的數字。三個斷言就能抓出本文描述的每一個陷阱:預期頁面上的註解數、用 GetAnnotType 或 GetAnnotContentsEx 讀回一個欄位、以及第二次匯出與第一次逐位元組比對。同樣的紀律適用於任何批量改寫文件結構的 API,包括合併重複表單欄位一文中描述的欄位整合:檢查產生的樹,而不是回傳的總數。FDF 與 XFDF 註解方法及其檔案與字串變體,隸屬 losLab PDF Library for Delphi and C++Builder 出貨