供應商的 PDF 在螢幕上看起來完美無瑕,PDF/A 驗證器卻以一行話退件:00030 At least one font is not embedded。檢視器從頭到尾都在跟你的機器借字型。打開檔案裡的字型描述器,內嵌字型需要的東西幾乎都在——連字幹寬度與邊界框都有;缺的是一條握著字型程式本體的串流參照
跑封存接入管線的人對這件事的批次版再熟悉不過。發票、合約與掃描表單從供應商與事務所湧進來,全公司每一台電腦都渲染得妥妥的,驗證器卻拿同一行話退掉一份又一份檔案。上游沒有人會重出任何東西。管線得修好收到的檔案,這正是本文的工作。它的姊妹篇——以預檢報告偵測 PDF/A 與 PDF/UA 違規一文——告訴你哪些檔案壞了;這篇處理它們壞掉的最常見方式
錯誤 00030 實際要的是什麼
ISO 19005-1 §6.3.4 要求合規檔案用到的每一個字型,都把字型程式帶在檔案裡。道理是再樸素不過的封存邏輯:五十年後、在一台與製作方毫無共用字型的機器上打開的文件,必須渲染得一模一樣,而非內嵌字型只是一句「去找個叫 Arial 的東西」的指示——找誰?找當下恰好負責閱讀的那套系統。替代者有什麼字形與度量,讀者就看到什麼
不內嵌的習慣源自 Standard 14 約定。早期的 PDF 承諾每個檢視器都內建 Helvetica、Times、Courier、Symbol 與 ZapfDingbats,於是生產器學會按名引用、什麼都不嵌。至今仍有大量工具這麼做。PDF/A 撤銷了這條豁免,而 losLab PDF Library for Delphi 在寫出端落實同樣標準:PDF/A 或 PDF/X 模式啟用時,AddStandardFont 不選字型、回傳 0,因為程式庫不附帶 Standard 14 的字形輪廓,也不會寫出一條自己兜不出程式的參照。PDF/A 模式下,Embed=0 的 AddTrueTypeFont 會升級為完整內嵌,Embed=2(子集)原樣通過,因為子集仍是內嵌的程式
以上管的是你自己寫的檔案。供應商的檔案更麻煩:字型字典是別人的生產器寫的,你無從要求它再試一次。對這類檔案,程式庫提供 EmbedMissingFonts,就地修復已載入的文件——把每一個缺失的程式從已安裝字型複製進文件既有的描述器
為什麼非內嵌字型只缺一個鍵?
寫出非內嵌 TrueType 字型的生產器,照樣產出完整的 FontDescriptor:FontName、FontBBox、Flags、Ascent、Descent、StemV、CapHeight。它省掉的是握著字型程式的串流——TrueType 輪廓從描述器以 /FontFile2 參照,CFF 為本的 CID 字型以 /FontFile3。所以 EmbedMissingFonts 補的正是這一項:讀出程式位元組、以帶 /Length1 項目的新 Flate 壓縮串流寫出、把參照掛到已經在那裡的描述器上
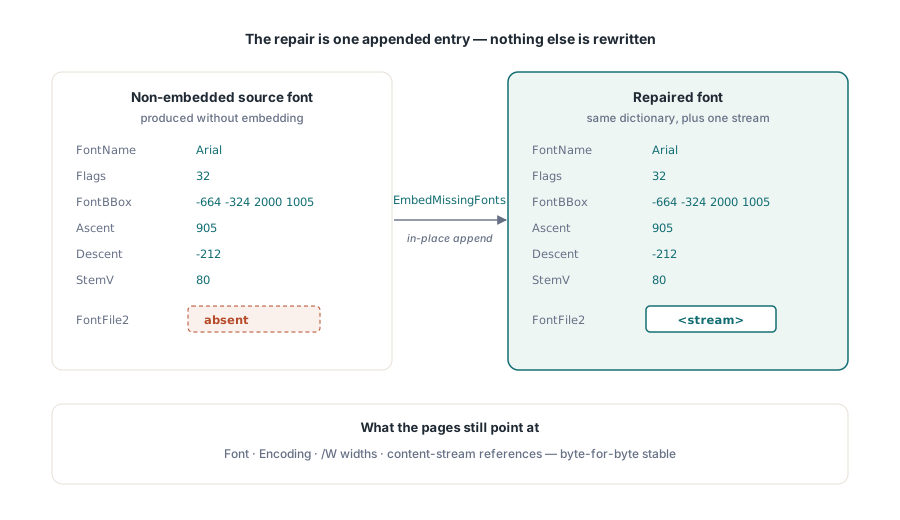
我們認為對繼承而來的檔案,這種就地修補是正確的預設,理由在 Widths 陣列。PDF 內容串流裡的文字位置早已定案;檢視器按原始生產器記錄的寬度前進。從已安裝字型重建字型字典,會把那些寬度換成新量出來的,一旦安裝版本與作者使用的版本有絲毫出入,你改動的正是本該原樣保存的文件。字典、編碼、寬度與每一條內容串流一概不動,頁面於是繼續指向同樣的資源名稱、帶著同樣的度量
這趟走訪涵蓋檔案裡每一個 Font 字典,不只頁面資源可達的那些,所以只出現在註解外觀、或跨頁共用的字型也一併抓到。複合 Type0 字型——為 CJK 文字與多數現代 Unicode 輸出產出的那種——經其子代 CIDFont 處理。整個修復是對已載入文件的一次呼叫:
var
  PDF: TPDFlib;
  Repaired: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('supplier-invoice.pdf', '') <> 1 then
      raise Exception.Create('Could not load PDF');

    // 回傳補到程式的字型數。已內嵌的字型
    // 不動;沒有安裝對應的字型被跳過、
    // 也不計入。
    Repaired := PDF.EmbedMissingFonts;
    Writeln(Format('%d font program(s) embedded', [Repaired]));

    PDF.SaveToFile('supplier-invoice-repaired.pdf');
  finally
    PDF.Free;
  end;
end;
已安裝字型的查找怎麼比對名稱
真實檔案裡的 BaseFont 名稱,很少與 Windows 認得的家族名對得上。EmbedMissingFonts 在查找之前先正規化每個名稱:
- 子集前綴(六個大寫字母加一個加號,如
KQBWTE+Calibri)被剝除 - 第一個逗號或連字號之後的一切視為樣式,所以
Arial,BoldItalic與Arial-BoldMT都在要粗體,Italic或Oblique則要斜體 - 尾部的
MT與PS後綴被丟棄,所以ArialMT解析為Arial - 字體面住在 TrueType Collection(.ttc)裡時,表偏移經過調整,讓內嵌程式成為獨立合法的字型
更麻煩的問題是 Windows 的字型對映器從不說不。向 GDI 要一個沒安裝的家族,它二話不說交回替代字體面;向只有常規體的家族要粗體,它在螢幕上把輪廓加粗。兩種結果都會給你一個載得好好的、卻是錯誤字型的程式。所以查找會核對 GDI 實際選中的字體面與要求的家族——忽略空格與大小寫——並核對字體面自身的粗體與斜體位元與要求的樣式。任一不符,該字型就跳過
這是刻意的取捨。更寬鬆的查找會讓每個批次的修復數字都漂亮起來,其中某些「修復」會把 Arial Regular 嵌在文件宣稱 Arial,Bold 的字型底下。ISO 19005-1 §6.3.6 要求字型字典裡的寬度與內嵌程式一致,於是一次擦邊球可能把錯誤 00030 換成寬度一致性錯誤,最壞的情況是通過驗證、渲染卻與作者的本意略有出入。我們寧可回報一筆跳過,也不把猜測封存進檔案
查找經 Windows GDI 讀取已安裝字型。Linux 或 macOS 建置上,系統路徑回傳空,下一節的檔案式呼叫就是供應程式的管道
字型沒有安裝時會怎樣?
回傳值會告訴你。若 EmbedMissingFonts 回報的字型數比你確知缺失的少,差額就是這台機器沒有的字型,或沒有正確樣式的字型。對這些,EmbedFontProgramFromFile(FontName, FileName) 從你提供的 .ttf 或 .otf 檔附上程式,管線因此可以隨車帶著預期會碰到的企業字體、並刻意回退到它們
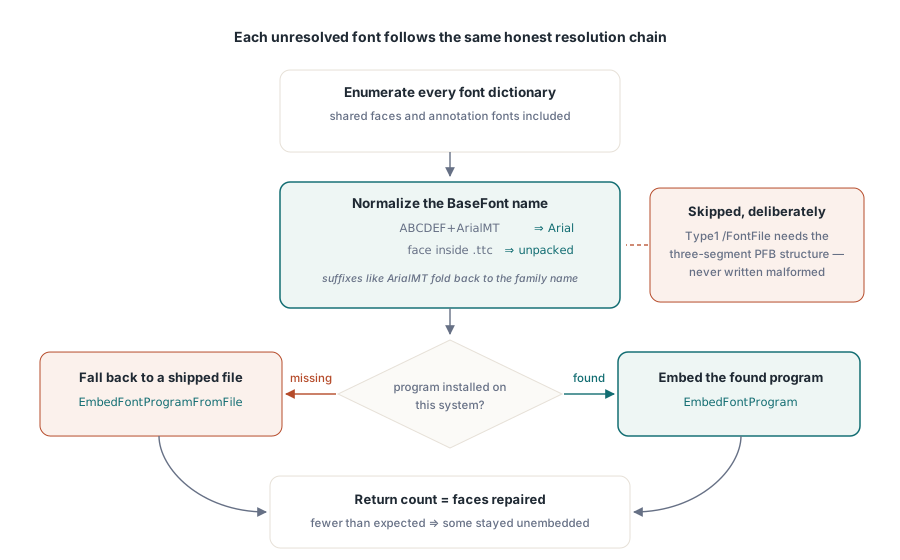
實務上最順手的模式是兩趟。跑 EmbedMissingFonts 並存檔,然後重新載入結果、列舉仍未內嵌的字型,把剩下的每個名字交給你自己的字型資料夾。重新載入這一步省不得:GetFontIsEmbedded 對列舉字型回報的內嵌旗標,反映的是 FindFonts 執行當下的檔案狀態,與修復同一工作階段裡列舉,會拿到過期的答案
function FontFileFor(const BaseFont: string): string;
begin
  // 你自己的輔助函式(不是程式庫的一部分):把文件
  // 字型名稱對應到應用程式隨附的字型檔。
  // 空結果讓 EmbedFontProgramFromFile 回傳 0,
  // 不碰檔案系統。
  if Pos('CorporateSans', BaseFont) > 0 then
    Result := ExtractFilePath(ParamStr(0)) + 'fonts\CorporateSans.ttf'
  else
    Result := '';
end;

procedure EmbedFromShippedFonts(const InFile, OutFile: string);
var
  PDF: TPDFlib;
  I, FontID: Integer;
  Name: string;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile(InFile, '') <> 1 then
      Exit;
    PDF.FindFonts;
    for I := 1 to PDF.FontCount do
    begin
      FontID := PDF.GetFontID(I);
      if (FontID > 0) and (PDF.SelectFont(FontID) = 1) and
         (PDF.GetFontIsEmbedded = 0) then
      begin
        // 名稱照儲存的原樣傳入,子集前綴在內
        Name := PDF.FontName;
        if PDF.EmbedFontProgramFromFile(Name, FontFileFor(Name)) = 0 then
          Writeln('Still not embedded: ', Name);
      end;
    end;
    PDF.SaveToFile(OutFile);
  finally
    PDF.Free;
  end;
end;
三個細節決定這個迴圈成不成。按名呼叫——已安裝字型的 EmbedFontProgram 與檔案的 EmbedFontProgramFromFile——以文件儲存的 BaseFont 原樣比對、並作用在第一個帶該名稱的 Font 字典上,這正是迴圈直接傳 PDF.FontName、而非清潔過的家族名的原因。程式格式必須合於字型類型:TrueType 或 CIDFontType2 字型要字形輪廓的 TrueType 資料,CIDFontType0 字型要 OpenType CFF 程式(以 OTTO 標籤開頭),後者寫出為帶 OpenType 子類型的 /FontFile3。把 CFF 檔塞給 TrueType 字型,呼叫回傳 0。修復路徑涵蓋 TrueType 與 CID 字型;Type1 字型的 /FontFile 需要帶明確長度鍵的三段式 PFB 版面,所以 Type1 參照被跳過、留給回傳計數去標記。Standard 14 的參照多半寫成 Type1,預期會在那份剩餘清單裡見到它們
還有一個程式庫替你答不了的問題。TrueType 字型的內嵌許可屬於它的鑄字方,把有授權的程式寫進即將離開組織的文件,需要有人確認授權允許。程式碼會內嵌你指給它的任何檔案;你是否有權這麼做,是法律問題
用 CreatePreflightReport 收攏迴圈
退掉檔案的那道稽核,應該就是放行檔案的那道。帶 ComplianceTests = 1 的 CreatePreflightReport 跑 PDF/A 檢查,00030 這項發現對整份檔案只報一次,所以一個漏網的字型就能讓它留在報告裡。對來源跑一次,修復、存檔,再對輸出跑一次
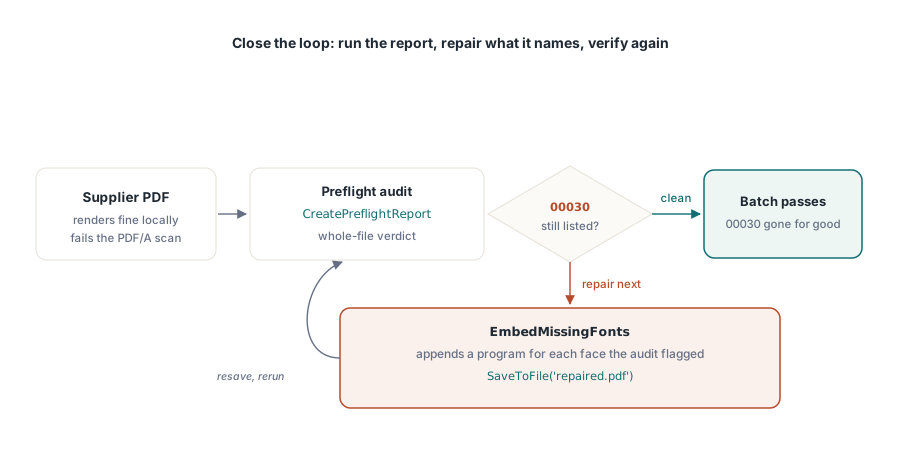
function HasFontEmbeddingViolation(PDF: TPDFlib;
  const FileName: string): Boolean;
var
  Report: string;
begin
  // ComplianceTests = 1 代表選擇 PDF/A 檢查
  Report := PDF.CreatePreflightReport(FileName, '', 1, 0);
  Result := Pos('00030', Report) > 0;
end;
第一次會讓人吃驚的結果有一個。字型檢查無視只在文字渲染模式 3 下以不可見方式繪製的字型——多數 OCR 引擎正是這樣把可搜尋文字層疊在掃描影像上。所以掃描檔可以過 00030、FindFonts 卻仍列出未內嵌的字體面。這與 PDF/A 對不可見文字的處理一致,也意味著逐字型清單與逐檔案判定在同一份文件上可以名正言順地不一致
批次日誌需要精確點名哪個檔案的哪個字體面仍未內嵌時,逐字型清單是更好的工具:載入輸出、呼叫 FindFonts,再對每個條目 SelectFont 與 GetFontIsEmbedded。從已載入 PDF 擷取文字、影像與字型一文用同一套列舉餵抽取而非修復
內嵌只消掉一項發現,你自己的輸出不該需要它
內嵌字型消掉錯誤 00030、僅此而已。還在加密、缺 XMP 中繼資料、沒有 OutputIntent 的裝置相依色彩空間、或字型缺 ToUnicode 對應表上翻車的檔案,程式全部補齊之後照樣不過,所以修復該住在預檢迴圈裡、按報告點名的項目逐一推進。尺寸是另一筆成本:一份完整 CJK 字型程式可達數 MB,內嵌幾份足以讓一頁發票變成原來的好幾倍;PDF 檔案尺寸最佳化與字型子集化一文講的是把每個內嵌程式裁到頁面實際用到的字形
寫出端,SetEmbedAllFonts(1) 讓你自己的程式碼不再產出本文修復的這種檔案。它把 PDF/A 模式用的那套升級,套用到普通文件:之後任何帶 Embed=0 的 AddTrueTypeFont 呼叫都內嵌完整程式。這個設定屬於目前選定的文件、影響呼叫之後加入的字型,所以放在 NewDocument 之後立刻設。我們的建議:凡是可能進封存的東西都開著它,管它 PDF/A 不 PDF/A——你今天造出的檔案,就是日後讀它的人繼承的檔案
PDF.NewDocument;
PDF.SetEmbedAllFonts(1);
// 從這裡起,AddTrueTypeFont('Segoe UI', 0) 會內嵌完整
// 程式,與 AddTrueTypeFont('Segoe UI', 1) 完全相同
PDF.AddTrueTypeFont('Segoe UI', 0);
載入-修復-存檔路徑、檔案式回退與寫出端防線,都裝在供 Delphi、C# 與 VB.NET 使用的 losLab PDF Library 裡,連同上文用來確認結果的預檢引擎;產品頁記載其餘的字型 API,包括逐字型檢查與子集化