用 .otf 檔裡的 Noto Sans SC 排版中文發票,在 mutool 裡開啟時,客戶名稱的位置可能跳出一堆不相干的漢字,換成 TrueType 字型同一頁卻又正常。癥結在字型的 CFF charset;PDFlibPas 內嵌字型時會把內嵌副本的 charset 改寫成 identity,讓字形索引碼直接命中正確的字形
字型會不會踩到這個問題,取決於它當初怎麼建出來。TrueType 程式以 CIDFontType2 字型內嵌時會拿到 Identity 的 CIDToGIDMap,內容串流裡的碼就直接落在正確的字形上。多數帶 CFF 輪廓的拉丁 OpenType 字型是 name-keyed,而 name-keyed 的 CFF 程式直接把收到的 CID 當字形索引用。ISO 32000-1 甚至在 §9.7.4.2 特別註明,許多字型的 CID 與 GID 是同一套編號。但不是所有字型都如此。以 CID-keyed 字型建置的大型 CJK 字族——Noto Sans CJK 和它的 Source Han 同源兄弟都在內——各自帶一套自己的 CID 編號,產生端若把字形索引直接塞進這套編號,畫出來的就是恰好持有那個 CID 的字形,跟您想要的未必是同一個
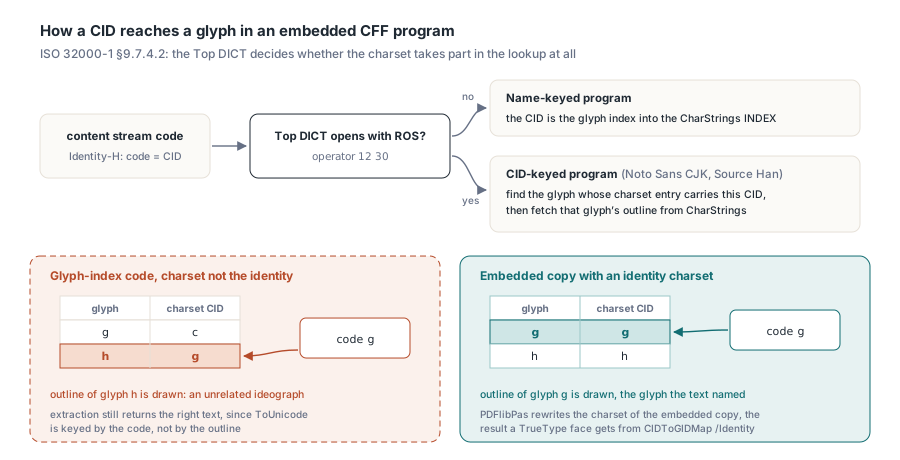
CID-keyed CFF 程式拿到 CID 之後怎麼處理
ISO 32000-1 §9.7.4.2 依 Top DICT 把內嵌的 CFF 程式分成兩種情況。Top DICT 若使用 CIDFont 運算子——實務上就是以 ROS(運算子 12 30:registry、ordering、supplement)開頭——閱讀器會從內容串流取出 CID,找到 charset 條目帶著這個 CID 的字形,然後才到 CharStrings INDEX 撈出輪廓。沒有 CIDFont 運算子時,CID 就是字形索引,charset 完全使不上力。所以任何照 §9.7.4.2 字面實作的閱讀器,只要 charset 不是 identity,字形索引碼就會畫出錯的字形,換哪套檢視器都一樣。charset 本身定義於 Adobe Technical Note #5176,有三種布局外加兩種特例:
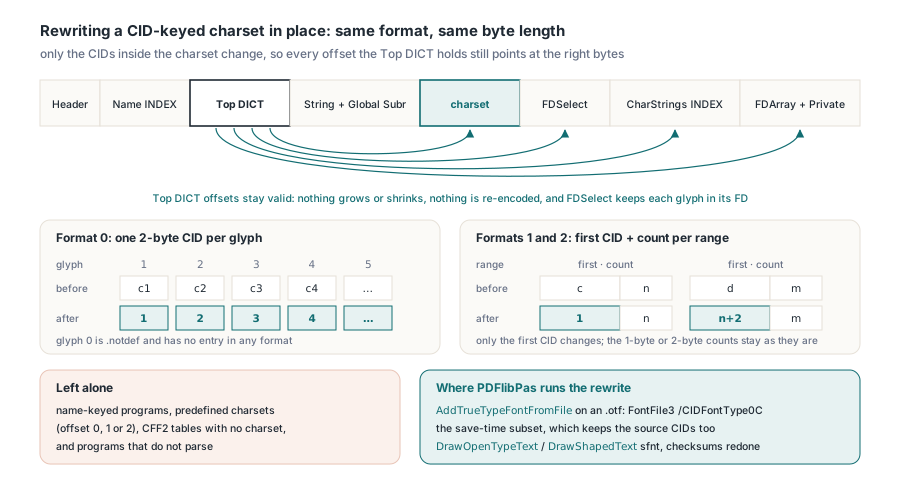
- Format 0 為每個字形存一個 2 位元組的 SID 或 CID,按字形順序排列
- Format 1 存範圍:一個起始 CID,後面接 1 位元組的數量,代表之後有多少字形延續連號的 CID
- Format 2 是同樣的範圍布局,但數量欄位為 2 位元組,適合連號很長的字型
- Glyph 0 是
.notdef,在任何格式裡都沒有條目;charset 偏移量為 0、1 或 2 時,指的是某個預先定義的 charset,而不是指向資料
所以第一步先弄清楚手上是哪一種字型。PDF 端的 Identity-H 只說明 2 位元組的碼等於 CID,這個 CID 怎麼對到字形,完全由字型程式內部決定。下面的函式會從 .otf 讀出 CFF 表,走訪 Top DICT 找 ROS,並檢查 charset 是否把每個字形都對應到同號的 CID。它只需要 RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // 檔案被截斷時丟出 ERangeError,而不是誤讀內容
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // 傳回 Pos 處 INDEX 的結尾,並框出其第一個物件
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // 偏移量從這裡起以 1 為基底
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // 實數
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // 保留位元組
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef 沒有條目
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
回報結果是 CIDKeyed = True 且 IdentityCharset = False 的,就是這篇文章談的那種字型:任何產生端若把字形索引塞進內容串流、卻沒有處理這個 charset,用它就會畫出錯的字形。name-keyed 的結果,或 charset 恰好已是 identity 的 CID-keyed 字型,在同一個產生端下都能正確顯示——這就是同一個產品裡某個 CJK 字型正常、下一個卻出錯的原因。迴圈只比較每個範圍的第一個 CID,這樣就夠了:一個範圍涵蓋的字形連號、CID 也連號,起點對上自己的字形索引之後,一路到結尾都會對上
字形索引貫穿整個字型字典
PDF 產生端手上通常沒有 CID。cmap 表與 shaping 引擎回傳的都是字形索引,所以順理成章的設計是把這些索引寫成 2 位元組的 Identity-H 碼,其他東西全都 keyed 在它們上:/W 寬度陣列、PDF/A 要求的 /CIDSet 點陣圖,以及讓文字擷取還原原文的 ToUnicode CMap。TrueType 有一條逃生口:Table 117 提供 CIDToGIDMap,但只適用於 Type 2 CIDFont;CFF 程式住在 CIDFontType0 字型裡,PDF 端無從把 CID 轉向。這也排除了某些產生端在 TrueType 上用的招數——給重複使用的字形一個超出字型結尾的第二 "alias" CID,讓 ToUnicode 能對每次使用掛上不同文字。在 CFF 字型裡,這種 alias 選不到任何字形,mutool 會回報無法顯示。U+4E00 與 U+2F00(KANGXI RADICAL ONE)共用同一個輪廓的字型是最常見的情況。如果文件需要這兩個碼擷取出來不一樣,就把該處包進帶 /ActualText(ISO 32000-1 §14.9.4)的 marked-content span,閱讀器會改用它而不採用字型的對應
就地改寫 charset
要讓字形索引碼與 CID-keyed 程式和平共處,有兩條路。一條是在寫出之前把每個字形索引換算成字型的 CID,這會牽動內容串流的碼、/W 的鍵、/CIDSet 的位元位置、ToUnicode 裡的來源碼,以及儲存時的每個子集。另一條是只改那個不對拍的結構——charset,讓字型像 name-keyed 程式一樣直接回應字形索引。第二條路安全得多:shaper、寬度表、子集產生器與 ToUnicode 建構器全都繼續在字形空間裡工作,唯一需要理解 CID 的,是一小段對字型內嵌副本跑一次的常式。PDFlibPas 走的就是這條路
改寫會保留 charset 的格式與位元組長度。Format 0 的每個條目直接覆寫成自己的字形索引;Format 1 與 2 只改每個範圍的第一個 CID,數量欄位原封不動。沒有任何東西變長或變短。指向 CharStrings 的 Top DICT 偏移量、Private DICT、FDArray 與 FDSelect 不必重編碼就照樣有效,而按字形索引分配 hinting 字典的 FDSelect,也讓每個字形留在原本的 FD。name-keyed 程式、預先定義的 charset、CFF2 表(它們沒有 charset)以及解析不了的程式一概不動。改寫有三條程式路徑:
- 對
.otf呼叫AddTrueTypeFontFromFile時,會把裸的CFF表以FontFile3、子類型CIDFontType0C內嵌,charset 已預先改寫 - 儲存時的子集保留原始字形索引,卻也留著來源 CID,所以它的 charset 會再改寫第二次
DrawOpenTypeText與DrawShapedText背後的 shaping 夥伴字型保留整個 sfnt;改寫之後CFF表的 checksum 會重算,head表的checkSumAdjustment則變成0xB1B0AFBA減去整個檔案的總和- 這個調整值只對單一字型有定義,所以從字型集合取出來的 face 只重算表 checksum
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // CFF 體質的 .otf 會以 FontFile3 /CIDFontType0C 內嵌;
    // CID-keyed 時內嵌副本會拿到 identity charset
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;驗收要靠顯示,擷取看不出問題。pdftotext 和所有擷取器讀的都是 ToUnicode,它以內容串流裡的碼為鍵,根本不知道字型為那個碼挑了哪個輪廓,所以頁面上漢字全錯,擷出來的字串照樣正確。mutool draw -r 150 -o page%d.png noto-sc.pdf 顯示頁面真正的樣子;走 DrawText 這條路時,poppler 的 pdffonts noto-sc.pdf 應該把字型列成 CID Type 0C。預期結果:兩行都以 Noto Sans SC 顯示來源文字指定的字形,Ghostscript 也輸出同樣結果
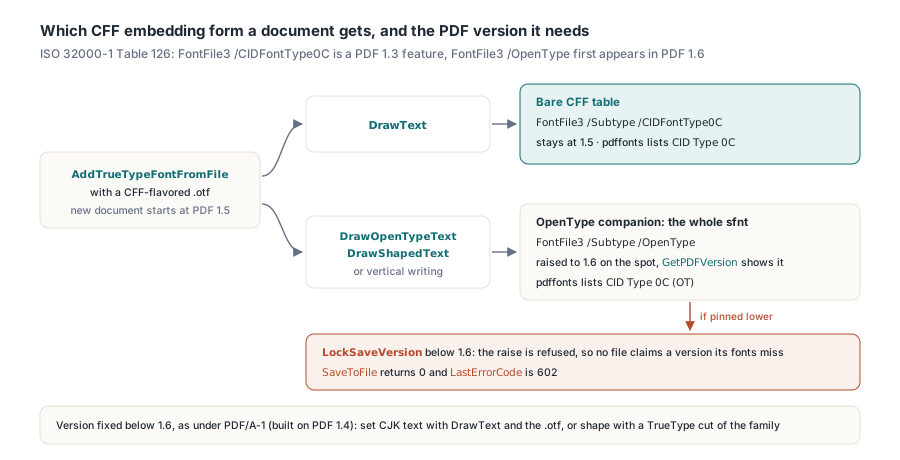
哪種內嵌形式需要 PDF 1.6?
OpenType 那種。ISO 32000-1 的 Table 126 把子類型 CIDFontType0C 的 FontFile3 串流列為 PDF 1.3 功能,而子類型 OpenType——連同 CFF 表在內的整個 sfnt——最早出現在 PDF 1.6。新的 PDFlibPas 文件從 1.5 起步,裸 CFF 的 DrawText 路徑正好落在這個版本內。第一次以 CFF face 呼叫 DrawOpenTypeText、DrawShapedText 或直排書寫時,會建立 OpenType 夥伴字型,並把文件當場升到 1.6,GetPDFVersion 立刻回報這個變化。有版本鎖就是另一回事:LockSaveVersion 若把文件釘在較低的版本,升級會被拒絕,SaveToFile 回傳 0 且 LastErrorCode 為 602,檔案不會宣稱自己的字型達不到的版本。當交付規範把版本釘在 1.6 以下——建構在 PDF 1.4 上的 PDF/A-1 是最常見的情況——CJK 文字就透過 DrawText 搭配 .otf 來排,需要 shaping 的場合則改用該字族的 TrueType 版本
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // 預期:1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // 預期:1.6
    Lib.SaveToFile('shaped.pdf');  // pdffonts 預期輸出:CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // 預期:602
  finally
    Lib.Free;
  end;
end;
寬度與 ToUnicode 都 keyed 在同一組編號上
charset 一旦是 identity,CID、字形索引與內容串流的碼就是同一個數字,寬度也跟著統一。ISO 32000-1 §9.7.4.3 直接以 CID 為 /W 建索引,分組方式是要嘛一個起始 CID 後接寬度陣列,要嘛首 CID、尾 CID 加一個共用寬度,沒有簡單字型那種 /FirstChar 偏移量。陣列沒列到的 CID 一律套用 /DW,而 Table 117 把 /DW 的預設值定為 1000。用 0 是錯的:未列出的 CID 退回 0 的閱讀器,會把一整行漢字疊在同一個位置上。對透過 AddTrueTypeFontFromFile 載入的 .otf,PDFlibPas 寫出的 /W 陣列從 CID 0 開始列出每個字形的 advance,旁邊再放明確的 /DW 1000。在閱讀端,擷出來變亂碼的 CJK 文字通常是在同一條管線的 codespace 那一半出錯,涵蓋寬度、CharSet 與 CIDSet 的 PDF/UA 字型稽核則把這些陣列拿來對照內嵌的字型程式
ToUnicode 有自己的一套編號規則。bfrange 條目只存第一個目的字串,§9.10.3 要求範圍長度不得把它的最後一個位元組推過 255,因為閱讀器產生後續目的碼時只遞增最後那個位元組。連號字形對到 U+4EFE、U+4EFF、U+4F00 與 U+4F01,看起來像一個範圍,其實不是:閱讀器會把第三個解成 U+4E00。PDFlibPas 的產生端只有在來源碼與目的碼都落在同一個 256 區塊內時,才把相鄰的字形對 Unicode 配對合併進同一個 bfrange,否則就把這段連號拆開。直排 CJK 走同樣的夥伴字型,所以日文與中文的直排文字不必額外呼叫,就繼承 identity charset 與這些 ToUnicode 範圍
凡是被 InspectOtfCharset 回報為 CID-keyed 且 charset 非 identity 的字型,都是字形索引碼與字型對不上的那種。透過PDFlibPas for Delphi 內嵌之後,輪廓、偏移量與 charset 長度都保持原樣,變的只有那一張表裡的 CID,保留整個 sfnt 時再加上 checksum