PDF Library for Delphi(PDFlibPas)透過 AddWebCaptureCommand 把 Web Capture 命令中繼資料寫入文件目錄,填入 ISO 32000-1 §14.10 定義的 /SpiderInfo 字典。每條命令記錄抓取過的 URL、抓取往下走了幾層,以及一組小旗標。它記錄的是意圖——不實際抓取任何東西
這個區別正是這個 API 容易被誤讀的全部原因。支援工程師把從某廠商線上文件組出來的 PDF 交到你手上,問你第 40 頁從哪來。如果產生端填了 /SpiderInfo,答案就躺在目錄裡:一個 URL、一個爬取深度,也許還有產生那一頁的 POST body。如果沒填,再怎麼讀內容串流也得不到答案。寫下這份來歷成本很低、結構上很囉嗦,而且幾乎總是被跳過
Catalog 的 /SpiderInfo 字典究竟記錄了什麼
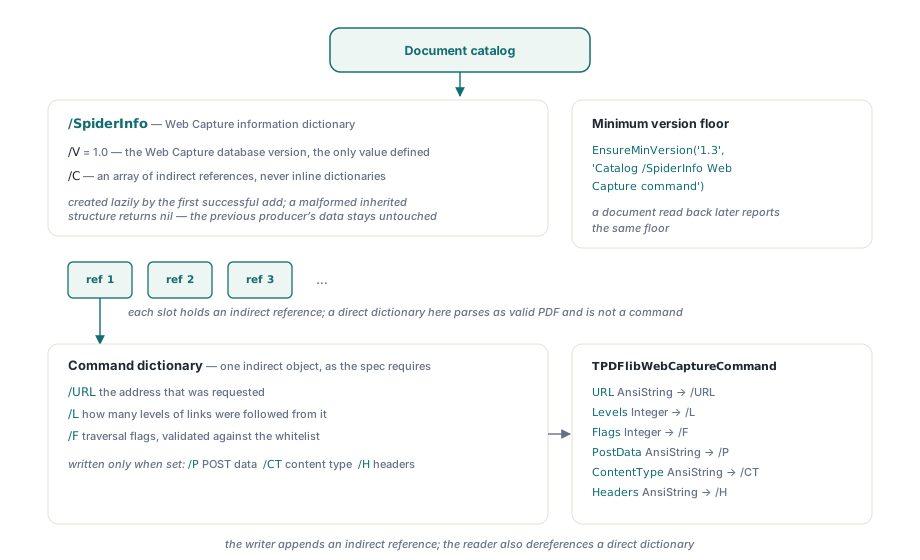
/SpiderInfo 是掛在文件目錄下的 Web Capture 資訊字典,裡面只放兩樣 PDF Library for Delphi 在乎的東西:/V 是 Web Capture 資料庫版本號,程式庫一律寫成 1.0;/C 是命令字典陣列。這個版本號不是 PDF 版本——它識別的是 Web Capture 資料模型本身,而 1.0 是 ISO 32000-1 §14.10 定義的唯一值。真正有趣的東西都在 /C 裡。每條命令字典帶 /URL(被請求的位址)、/L(從它往下追蹤的連結層數)和 /F(遍歷旗標)。三個選用鍵描述請求本身在不是普通 GET 時的情況:/P 放 POST 資料、/CT 放這份資料的內容型別、/H 放額外的請求標頭。PDF Library for Delphi 把六者全部對應到單一 record TPDFlibWebCaptureCommand,其欄位為 URL、Levels、Flags、PostData、ContentType 與 Headers,除了兩個 Integer 計數器外全是 AnsiString。/SpiderInfo 的存在還會墊高文件的最低版本:AddWebCaptureCommand 呼叫 EnsureMinVersion('1.3', 'Catalog /SpiderInfo Web Capture command'),而 PDF Library for Delphi 的版本偵測規則會註冊一組對應的 PDF 1.3 規則,讓之後回讀的文件回報同樣的版本下限
Web Capture 命令為什麼必須是間接物件
最容易絆倒人的結構規則是這一條:命令字典在放進 /C 之前必須註冊成間接物件,因為 ISO 32000-1 §14.10 把 /C 規定為指向命令字典的間接參照陣列,而不是字典陣列。把直接字典塞進這個陣列,會得到一份剖析起來是合法 PDF、作為 Web Capture 記錄卻毫無意義的東西——檢視器或歸檔工具沿著命令清單走,會在應該放參照的地方碰到內嵌物件,這個條目就根本不是一條命令。PDF Library for Delphi 在 AddWebCaptureCommand 內部處理這件事:它先建好字典,交給 OnNewIndObj 取得物件編號與世代編號,把這組編號包成間接參照,再追加進陣列。如果 OnNewIndObj 沒能產出正數物件編號,函式就回傳 0,陣列保持原樣。規格堅持間接化的理由是單一命令可以被共用——同一次抓取可以在 Web Capture 結構裡被多處參照——而 PDF 中共用的物件按定義就是間接物件
在 Delphi 裡新增 Web Capture 命令
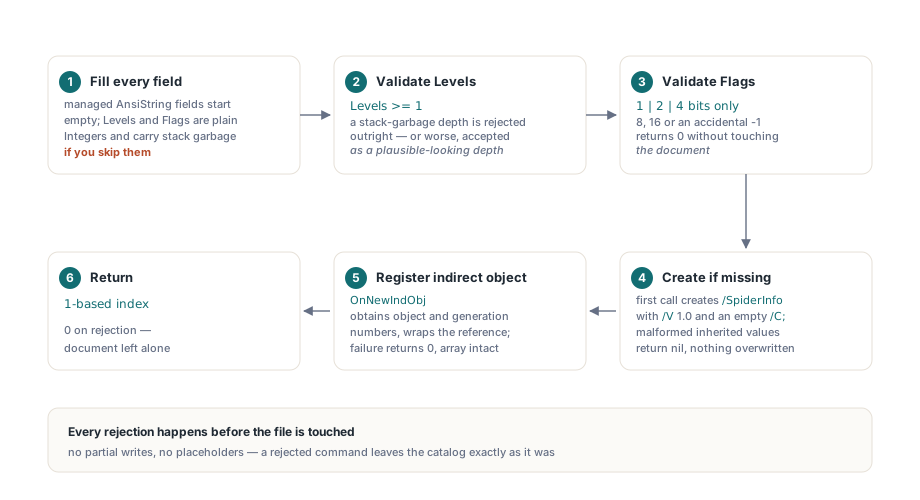
先把 record 填滿,再呼叫 AddWebCaptureCommand,它會回傳新命令的 1-based 索引,驗證被拒就回 0。完整性在這裡比平常更重要。Delphi 會把區域 record 的可管理 AnsiString 欄位初始化為空,但 Integer 欄位——Levels 與 Flags——不會受到這種待遇,所以忘了填的 record 會帶著堆疊上的殘留值上場。AddWebCaptureCommand 要求 Levels 至少為 1、Flags 不得為負,堆疊垃圾值要不是被直接拒絕,就是更糟地被當成看似合理的深度默默收下
var
  Lib: TPDFlib;
  Command: TPDFlibWebCaptureCommand;
  Index: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('captured-site.pdf', '') = 1 then
    begin
      // 每個欄位都要指派:Levels 與 Flags 是純 Integer,
      // 跳過它們就會帶著堆疊垃圾上場。
      Command.URL := 'https://example.com/docs/index.html';
      Command.Levels := 2;
      Command.Flags := PDF_WEB_CAPTURE_SAME_SITE or PDF_WEB_CAPTURE_SAME_PATH;
      Command.PostData := '';
      Command.ContentType := '';
      Command.Headers := '';

      // 回傳新的 1-based 命令索引,被拒絕時回傳 0。
      Index := Lib.AddWebCaptureCommand(Command);
      if Index = 0 then
        raise Exception.Create('Web Capture command rejected');

      Lib.SaveToFile('captured-site.pdf');
    end;
  finally
    Lib.Free;
  end;
end;第一次成功的呼叫也正是建立結構的時機。AddWebCaptureCommand 向內部的 WebCaptureCommands(True) helper 要命令陣列,而這個 helper 只在 /SpiderInfo 或其 /V 條目與空的 /C 陣列缺漏時才建立它們。它對找到的東西刻意保守:如果目錄已經有值不是字典的 /SpiderInfo 鍵,或值不是陣列的 /C 鍵,helper 回傳 nil 而不覆寫既有物件。繼承下來的結構畸形會讓新增失敗,不會讓 PDF Library for Delphi 毀掉先前產生端寫下的東西
旗標白名單:三個已定義位元,沒有其他
AddWebCaptureCommand 會拿白名單驗證 Flags,只要設了 PDF Library for Delphi 定義的三個常數以外的位元就拒絕:PDF_WEB_CAPTURE_SAME_SITE = 1(只追蹤留在同一個站台上的連結)、PDF_WEB_CAPTURE_SAME_PATH = 2(只追蹤同一路徑下的連結)、PDF_WEB_CAPTURE_SUBMIT = 4(這次請求是表單提交而不是普通抓取)。傳 8、傳 16,或不小心傳 -1,呼叫回傳 0,文件不會被碰
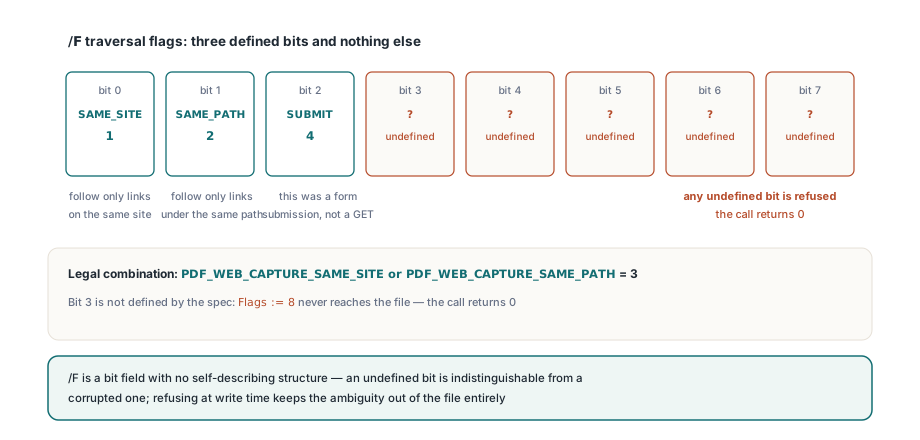
這比一般 PDF 剖析器嚴格,而且是故意的。/F 是沒有自描述結構的位元欄位,未定義位元與損壞位元無法區分,日後把值讀回去的消費端無法判斷那是未來擴充還是筆誤。在寫入時拒絕,就把模糊性徹底擋在檔案外。另外注意,/P、/CT 與 /H 只在對應 record 欄位非空時才寫,所以普通 GET 會產生三鍵命令字典——/URL、/L、/F——不會被空字串佔位符弄髒,這正是剖析這個檔案的讀取器對沒有 body 的請求所預期的樣子
// 表單提交:POST body 加上它的內容型別。
Command.URL := 'https://example.com/search';
Command.Levels := 1;
Command.Flags := PDF_WEB_CAPTURE_SUBMIT;          // 4
Command.PostData := 'q=iso32000&scope=all';
Command.ContentType := 'application/x-www-form-urlencoded';
Command.Headers := 'Accept-Language: en-US';
if Lib.AddWebCaptureCommand(Command) = 0 then
  raise Exception.Create('submission command rejected');

// 同站台加同路徑是合法組合:1 或 2 = 3。
Command.Flags := PDF_WEB_CAPTURE_SAME_SITE or PDF_WEB_CAPTURE_SAME_PATH;

// 規格沒有定義第 3 位元,所以這個值永遠進不了檔案。
Command.Flags := 8;
if Lib.AddWebCaptureCommand(Command) <> 0 then
  raise Exception.Create('undefined flag bit should have been refused');
把命令讀回來:一個鍵,兩種合法表示法
GetWebCaptureCommand 成功回 1,其餘回 0,而且它必須比寫入端寬容,因為它讀的是其他產生端寫的檔案。有兩處不對稱很要緊。第一,讀取端接受間接參照或直接字典形式的命令條目,需要時就解參照——PDF Library for Delphi 永遠寫規格要求的間接形式,但拒絕讀取鬆散檔案對誰都沒好處。第二,/P 允許是字串或串流,而這條推廣起來遠超出 Web Capture 的範圍。ISO 32000-1 一再允許單一鍵在值可能很大時同時容納字串或串流——這裡是 POST body,同樣的模式也出現在格式裡的中繼資料與內嵌承載。因此 GetWebCaptureCommand 內部的 ReadString helper 接受 AllowStream 旗標,只有 /P 的讀取傳 True:串流值會穿過它的濾鏡鏈解碼,以 PostData 欄位回傳,而 /URL、/CT、/H 保持純字串,因為規格沒給它們串流這個選項。如果你自己寫 PDF 讀取程式,這是最值得偷走的習慣——查規格看哪些鍵是雙型別,而不是預設它是字串
var
  Lib: TPDFlib;
  Command: TPDFlibWebCaptureCommand;
  I, Total, Removed: Integer;
begin
  Total := Lib.GetWebCaptureCommandCount;
  // 公開索引是 1-based,與 PDF Library for Delphi 其餘部分一致。
  for I := 1 to Total do
    if Lib.GetWebCaptureCommand(I, Command) = 1 then
      Writeln(Format('%s  levels=%d  flags=%d  post=%d bytes',
        [Command.URL, Command.Levels, Command.Flags, Length(Command.PostData)]));

  // 移除整個 /SpiderInfo 字典並回報丟掉幾條命令;
  // 沒有東西可清時回傳 0。
  Removed := Lib.ClearWebCaptureCommands;
  Writeln(Format('cleared %d command(s)', [Removed]));
end;
ClearWebCaptureCommands 先數命令,再把整個 /SpiderInfo 鍵從目錄清除,而不是只清空 /C。留著帶空命令陣列的 /SpiderInfo,等於宣稱這份文件有 Web Capture 來歷而且什麼都沒抓——這跟沒有記錄來歷是不同且虛假的宣稱。同樣的直覺也適用在目錄中繼資料的普遍情況:空的空殼字典是一句陳述,不是中立的殘留物。如果你要在重寫文件前先稽核它宣稱了什麼,把大綱與註解動作從既有 PDF 讀回來的內省模式,正好可以跟這裡的讀取後清除流程搭配
寫中繼資料不是實作 Web Capture
對範圍要對自己誠實:AddWebCaptureCommand 儲存的是預期或已完成抓取的紀錄,而且僅此而已。PDF Library for Delphi 不會執行 HTTP 請求、不會追蹤你的 Levels 值描述的連結、也不會理會 SAME_SITE 或 SAME_PATH 旗標——那些旗標是某個爬蟲行為的文件紀錄,不是程式庫會執行的指令。你自己的抓取程式,無論長什麼樣,完全是你自己的事
ISO 32000-1 §14.10 還有兩塊也不在這個 API 範圍內。Web Capture 定義內容集——把個別頁面片段繫回其來源素材的 /Contents 結構——以及把數位識別碼對應到這些內容集的名稱樹。PDF Library for Delphi 兩者都不維護。你拿到的是命令清單:對「這份文件從哪裡抓來、爬了多深」這種頂層問題的答案,而以來歷、稽核與歸檔導入的目的來說,這通常正是大家真正會問的部分。如果你需要的是讓讀者可以點擊 URL,而不是只為稽核者記錄,那是另一份工作——動作那一側見 建置 GoToR、GoToE 與 Launch 動作,開啟或關閉時的觸發行為見 文件與頁面生命週期動作觸發器。這裡描述的 Catalog /SpiderInfo 命令中繼資料,屬於 PDF Library for Delphi,這套給 Delphi 與 C++Builder 的原生 PDF 程式庫