一批扫描可以每页只有一张 JPEG、没有字体、没有注释、没有书签,照样可能过不了 PDF/raster。ISO 23504-1 对文件的要求不止纯光栅页面:它要用 trailer 区域的 %PDF-raster-1.0 注释标识自己,携带 XMP 元数据和 trailer /ID,并把 catalog 和 Info 字典限制在一份很短的许可清单内。因此检查一批采集件需要两种不同的读取:一种对着原始字节,一种对着每页实际画了什么
对同一份文件的两种读取
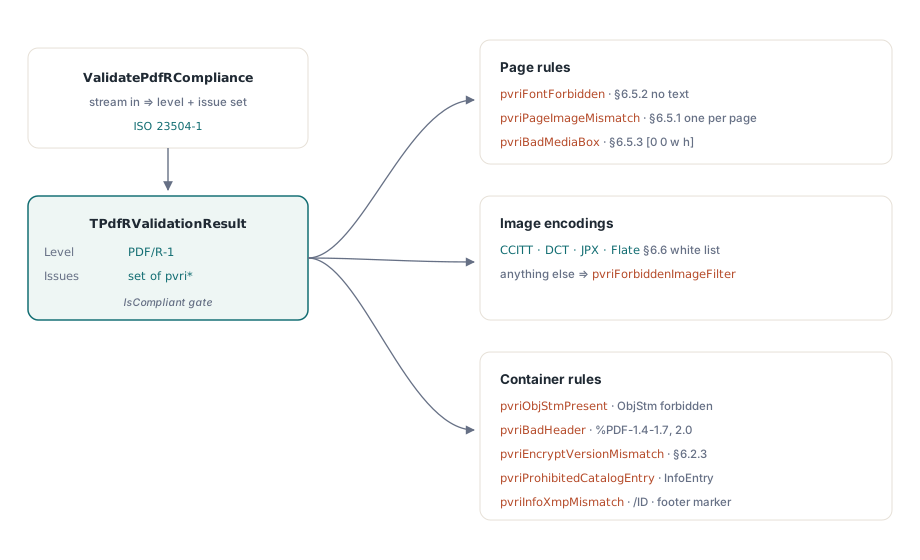
PDF/R 校验和 SaveAsPdfR 随 PDFium Component 的 Small Business 与 Enterprise 版交付,校验正是沿着这条线拆开的。FPdfPdfr 单元里的 ValidatePdfRCompliance 读一个流、检查字节级规则:头部版本、光栅标记、对象流、catalog 与 Info 条目、XMP、trailer /ID、MediaBox 原点、字体资源、被禁过滤器的名字,以及图像对象数是否与页数匹配。ValidatePdfRPageFacts 按 TPdfRPageFacts 记录一次检查一页:页面画了多少文本、路径、表单和着色对象,那张唯一的带状图像坐在哪里,它的像素尺寸、位深、色彩空间和过滤器链
两种读取经由同一个枚举 TPdfRValidationIssue 报告,组合入口把两者合并进一个 TPdfRValidationResult。它的 Conformance 字段只在找到光栅标记时才变成 prc1,IsCompliant 只在级别为 prc1 且问题集为空时返回 True。一份其他方面无可挑剔、唯独缺标记的文件会报告 prcNone——第一次拿一份干净的扫描跑出这个结果的人都会吃惊
问题是页面事实从哪来。TPdf.ValidatePdfR 从已加载文档收集它们,但它先把文档序列化到临时存储、再对重新保存的副本跑字节检查,所以标记和 catalog 的判定描述的是一次新鲜保存,可能与磁盘上的文件不同。FPdfBusinessWorkflows 里的 ValidatePdfRasterSource 对输入流取一次快照、两种读取都对着它跑。对一份即将进入归档的文件,该用的就是这个调用:判定指向的正是被归档的字节
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // 默认预算 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // 我们的采集契约
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues 装着字节级问题外加每一页的问题
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues 说出哪些页要重扫
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // 把机器可读的判定留在归档文件旁边
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
TPdfRasterSourceValidationOptions 里有两个默认值对扫描批次要紧。MaxInputBytes 是 64 MiB、MaxPages 是 1000;一批长的彩色扫描可能超出字节预算,检查随即以状态 prssBudgetExceeded 结束、Complete 为 False。MemoryLimitBytes 是 8 MiB,超过后快照溢写到 TemporaryDirectory,报告置 SnapshotSpilled。Report.IsCompliant 还要求 Complete,半路停下的检查永远不会被读成通过
为什么 OCR 文本层过不了 PDF/R?
因为一张光栅页面画的只有扫描图像,别无其他。不可见的 OCR 层在 PDF/A 工作流里是正常补充,但它往文件里放进了 PDF/R 排除的两样东西:一个字体资源——字节读取报告为 pvriFontForbidden;页面上的文本对象——页面读取报告为 pvriNonRasterPageContent。同一个页面问题对矢量路径、着色和表单 XObject 同样触发,所以盖印的页码或画的边框线和隐藏文本以同样的方式失败
页面与图像的关系同样严格。每页必须恰好携带一张带状图像;pvriPageImageMismatch 在没有图像的页面触发,也在扫描被写成两张并排图像的页面触发。字节一侧的计数覆盖每个 /Subtype 为 /Image 的对象,所以任何多余图像对象——比如挂在带状图上的软蒙版——都会把总数推过页数
几何有两次检查。pvriBadMediaBox 报告不从 [0 0 ...] 开始的 MediaBox;字节读取检查内联数值数组。页面读取随后把带状图的绘制边界与 MediaBox 比较,任一边偏差超过 GeometryTolerancePoints(默认 0.5 磅)就报告 pvriStripGeometryInvalid。把图像缩放到页面 98% 以留白边的扫描仪驱动在这里失败,哪怕页面在屏幕上看着没问题。内部文件可以接受白边时,把 RequireFullPageStrip 设为 False 即可关掉覆盖测试
哪些图像编码能过
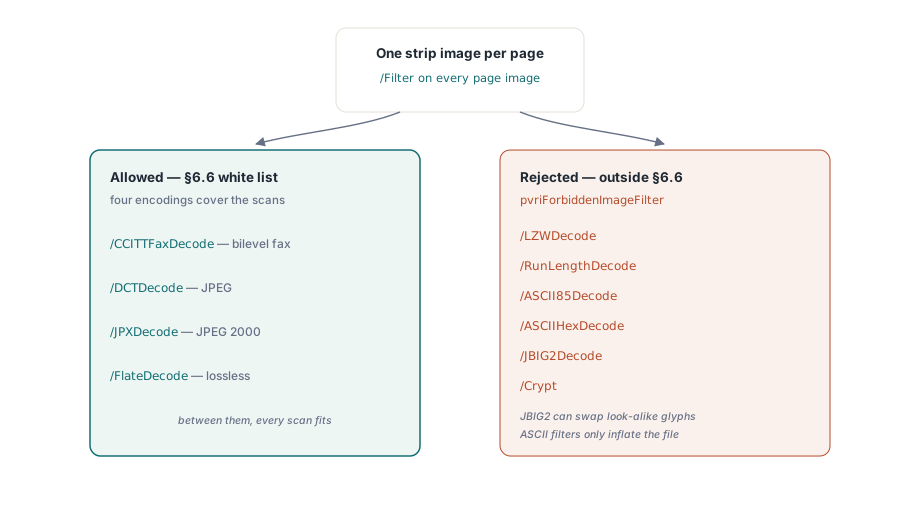
校验器接受四种带状图过滤器:/CCITTFaxDecode、/DCTDecode、/JPXDecode 和 /FlateDecode。字节读取按名字把其他标准过滤器标为 pvriForbiddenImageFilter:/LZWDecode、/RunLengthDecode、/ASCII85Decode、/ASCIIHexDecode、/JBIG2Decode 和 /Crypt
JBIG2 是采集团队最先撞上的拒绝项。它在 PDF/A 里合法,对双值页面压缩极好,所以为 PDF/A 搭的采集配置可能已经在产出它。它的有损模式匹配还会把扫描字形换成看着相似的另一个——扫描表单上数字被替换是有据可查的问题——而光栅归档存在的意义恰恰是纸上是什么、文件里就是什么。把这些页重编码成 CCITT Group 4,既保住双值又无损
页面读取更进一层,把过滤器链连同图像的位深和色彩空间一起看,错配报告为 pvriImageCompressionParametersInvalid:
- 多于一个过滤器的链被拒绝,所以 ASCII85 包着的 Flate 图像失败两次——一次在字节侧,一次在这里
/CCITTFaxDecode必须坐在 1 位 DeviceGray 带状图上/DCTDecode必须坐在 DeviceGray 或 DeviceRGB 的 8 位或 24 位带状图上/FlateDecode在 1 位带状图上被接受;24 位 Flate 页面过不了这一项/JPXDecode在每像素 1、8 或 24 位时被接受
与过滤器无关,色彩空间既非 DeviceGray 也非 DeviceRGB 的带状图拿到 pvriImageColorInvalid。所以基于 ICC 或 CMYK 的扫描必须在包装之前转换,而最便宜的转换位置是扫描仪配置文件——在任何 PDF 写出之前
带状图分辨率是怎么算出来的
图像自带分辨率时,页面读取就用它。没有时,有效分辨率从像素和页面尺寸推出来:像素宽乘 72 除以 MediaBox 的磅宽,高度同理。假设扫描仪把一条 2550 乘 3300 像素的带状图写到 612 乘 792 磅的 US Letter 页面上,两个方向正好都是 300 dpi。同一页若是 600 乘 776 像素,水平方向约 70.6 dpi,低于默认下限 72,页面拿到 pvriImageResolutionInvalid
TPdfRValidationOptions 的默认范围是 72 到 2400 dpi。这个边界只抓明显坏掉的页面。采集契约通常承诺一个具体下限,常常是 200 或 300 dpi,那个值应放进 MinimumResolutionDpi:150 dpi 的页面能过默认范围,而它正是契约想排除的那种页。任一边界设 0 即关闭该侧检查
ValidatePdfRPageFacts 是公开的,所以同一套规则可以在任何 PDF 存在之前就跑——直接用扫描仪对每张图像报告的数据:
uses
  FPdfPdfr;

// 从扫描仪输出构建页面事实;这个辅助函数是你的,不属于库
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // 带状图覆盖整页
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi 留 0:推导得出
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray,2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // Letter 上的 300 dpi 彩色 JPEG:空集
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // 同一页用 Flate 压 24 位:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Catalog、Info 字典与 XMP
除必需的 /Type 和 /Pages 外,ISO 23504-1 在 catalog 里只允许 Version、ViewerPreferences、PageLayout、PageMode、AcroForm 和 Metadata。校验器对照该集合之外的 21 个标准键检查 catalog,任何一个出现就抛 pvriProhibitedCatalogEntry,其中有 Outlines、Names、PageLabels、OpenAction、StructTreeRoot、MarkInfo、Lang、OCProperties 和 OutputIntents。最后这个在实践中要紧:PDF/A 文件总是带着输出意图,所以一份文件没法同时满足两个 profile
Info 字典可以放 Creator、Producer、CreationDate 和 ModDate;Title、Author、Subject、Keywords 和 Trapped 触发 pvriProhibitedInfoEntry。catalog 没有 /Metadata 流则得到 pvriMissingXmpMetadata。流在而 XMP 缺 xmp:CreateDate、xmp:ModifyDate、xmp:MetadataDate 之一时,结论改为 pvriMetadataInvalid。pvriInfoXmpMismatch 比较 Producer 与 pdf:Producer、Creator 与 xmp:CreatorTool。日期不参与比较,因为两种编码本来就合理地不同;存成十六进制字符串的 Info 值被跳过。典型触发是后来的工具改写了 Info 的 Producer 却没动 XMP
剩下的容器规则很短。头部必须是 %PDF-1.4 到 %PDF-1.7 或 %PDF-2.0(pvriBadHeader);任何 /Type /ObjStm 流触发 pvriObjStmPresent;加密文件必须用 %PDF-2.0 头部(pvriEncryptVersionMismatch)。RequireEncryptedPdf20Profile 保持开启时,加密字典还必须声明 /V 5 或 6、/R 5 或更高,否则文件拿到 pvriEncryptedPdf20ProfileInvalid
写出标记
TPdfRSaveOptions 携带 Creator、Producer、CreationDate、ModDate、DocumentId 和 InstanceId,没有 Title、Author、Subject 或 Keywords 的字段——profile 禁止它们。StripInfoOptionalEntries 和 StripCatalogOptionalEntries 默认都是 True,从源里移除被排除的条目;任何一个设为 False,条目就留下,代价是合规。TPdf.SaveAsPdfR 用已加载文档自己的元数据和文件标识填充空白选项字段,移除安全性,然后写出标记、裁剪过的字典、XMP 包和 trailer /ID
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer、日期和 ID 来自源文件
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // 检查写出去的字节,不是内存里的文档
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
包装只改元数据和标识。画着矢量文本、或没有带状图的源页面,从 SaveAsPdfR 出来时页面内容原样,页面检查照样本失败。页面内容被刻意不动:悄悄重渲染一份扫描,改变的恰恰是归档要保存的那些像素。对 OutFile 跑第一段代码里的 CheckDeliveredScan,拿到包含页面读取在内的完整判定
PDF/R 在采集流水线里的位置
PDF/R 适合扫描本身即记录、保真度即全部契约的交付物:取证影像、支票与汇款采集、来自大幅面扫描仪的图纸归档。文档一旦需要可搜索文本、标记、附件或书签,就该去 PDF/A——上面每一张排除清单都正好装着这些功能
很多团队两者都留。PDF/R 原件写一次永不改动,带 OCR 层的 PDF/A 衍生件负责检索。两个校验器相互独立,同一个批处理任务可以按每份文件声称的 profile 检查它。归档一侧见PDF/A 归档合规和PDF/A 预检校验,印刷输出见校验印刷就绪的 PDF/X 文档
这里展示的 PDF/R 检查是面向 Delphi、C++Builder 和 Lazarus 的 PDFium Component Small Business 与 Enterprise 版的一部分,旁边还有 PDF/A、PDF/X、PDF/E 和 PDF/UA 的校验器;版本与支持的 IDE 见 PDFium Component 产品页