把一个 FDF 导入表单,字段值回来时微妙地不对:项目符号变成匕首号,省略号变成 em dash。PDFium Component 把这一整族症状追到它的 PDFDocEncoding 表里的一行——ISO 32000-1 Annex D.2 的特殊字符块起点是 $80,不是 $7F
为什么 FDF 导入返回的是相邻字符?
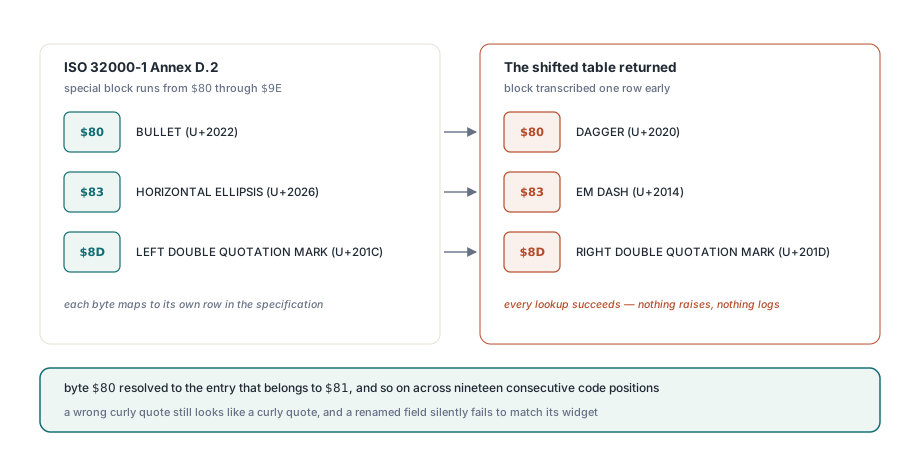
因为错位一格的编码表仍然是张看起来完全合法的表,里面每次查找都成功。Annex D.2 分配给 $80 到 $9E 的那个块被誊错了一行:字节 $80 解析到属于 $81 的条目,字节 $81 解析到 $82 的条目,一路错下去横跨十九个连续码位。什么都不抛、什么都不记日志,也没有任何字段被拒绝——TPdf.ImportFDF 报出的字段数和往常一模一样
破坏是整齐划一且无声的。带着 $80 的字节——Annex D.2 定义为 BULLET (U+2022)——回来变成了 DAGGER (U+2020)。字节 $83,HORIZONTAL ELLIPSIS (U+2026),回来变成 EM DASH (U+2014)。字节 $8D,LEFT DOUBLE QUOTATION MARK (U+201C),回来变成 RIGHT DOUBLE QUOTATION MARK (U+201D)——这个案例没人注意,因为错的弯引号在表单字段里看起来还是弯引号。字段名和字段值遭了同样的殃,而这更糟:一个和文档里 widget 对不上的名字,会无声地应用失败
PDF 文本字符串携带两种不同的编码
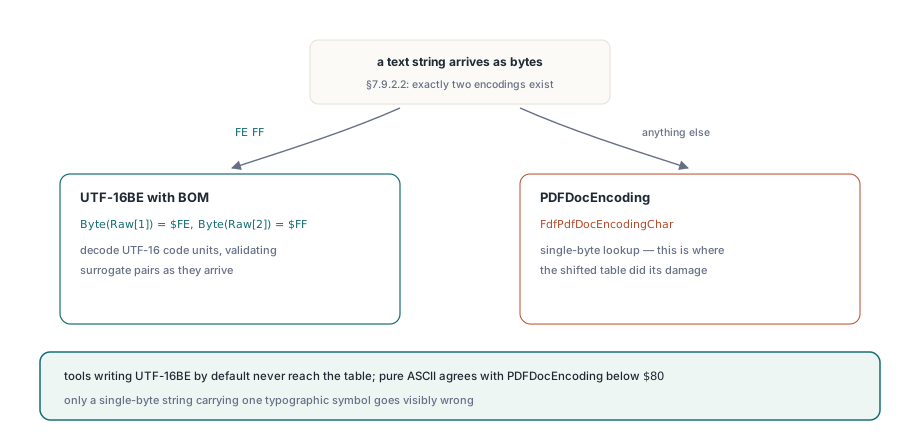
ISO 32000-1 §7.9.2.2 把文本字符串类型定义为恰好两种编码之一,靠检查头两个字节决定,而不是靠任何字典条目。以字节序标记 FE FF 开头的字符串是 UTF-16BE;其他一切都是 PDFDocEncoding。这一个分支决定两个完全不同的解码器里哪个运行,PDFium Component 在 FDF 解析器内部、还没碰任何字符之前就应用它
// FDF 文本字符串:有 BOM 就是 UTF-16,否则是 PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... 解码 UTF-16 code unit,校验 surrogate pair
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
这就是这个 bug 在普通测试里藏这么久的原因。默认写 UTF-16BE 的工具产出的任何 FDF,根本到不了 FdfPdfDocEncodingChar,所以错位的表一直休眠。只有单字节字符串——很多 FDF 生成器对纯拉丁字段名都这么发,因为更短——才会走进那张表起作用的那个分支。而纯 ASCII 字段名反正也能正确解码,因为 $80 以下 PDFDocEncoding 和 ASCII 一致。你非得有一个含排版符号的单字节字符串,才会出现可见的错误
修好的表,以及钉住它的两个锚点
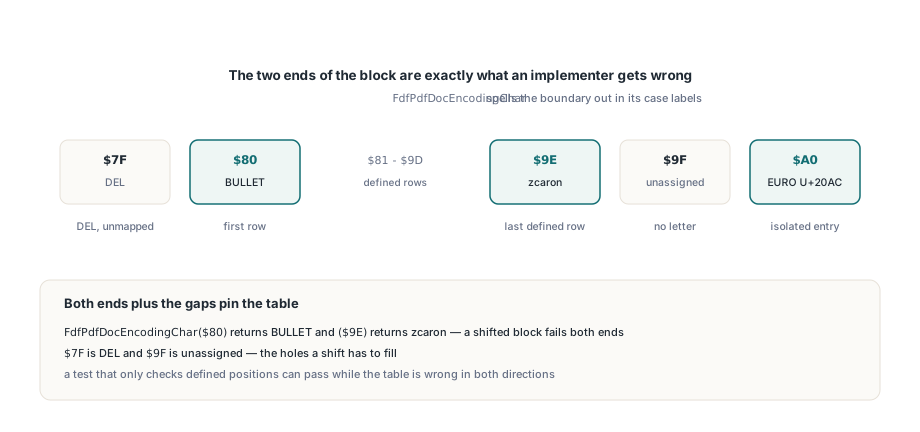
PDFium Component 现在把边界直接写死在 FdfPdfDocEncodingChar 里,因为块的两端正是实现者最容易搞错的地方。$7F 是 DEL,在 PDFDocEncoding 里没有任何含义;块从 $80 的 BULLET 开始,到 $9E 的 zcaron 结束;$9F 未分配;欧元符号孤零零坐在 $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2。块从 $80 开始,不是 $7F:$7F 是 DEL,
    // 在 PDFDocEncoding 里没有含义;欧元符号在 $A0,默认分支
    // 否则会把它当 no-break space 交回去
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET,块的第一行
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 到 $9D
    $9E: Result := WideChar($017E);   // zcaron,最后一个有定义的行
    $9F: Result := WideChar($FFFD);   // Annex D.2 中未分配
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
看看错位对这两端做了什么,因为差一错误在那里就不再是外观问题。zcaron 在规范里是 $9E,在错位的表里却待在 $9D,于是文档里一个 $9E 字节会越过任何人誊写的最后一行、直直掉进恒等回退,返回一个 C1 控制字符而不是字母。而 $A0 欧元符号,当初压根就没写进表里——恒等分支把它当 U+00A0 NO-BREAK SPACE 交回去:这个字符能熬过之后每一次校验、打印出来是空白、永远匹配不上你要找的字段名
怎么测试一张誊抄来的编码表?
测首行、末行和间隙——别从中间取样。这是修复里值得带到你从规范里抄出来的任何其他表上的部分,因为块中间的抽查正是整块错位能活过去的那个测试。验证 $8D 给出左双引号证明不了什么——$8C 也会给出某个貌似合理的东西;验证 $80 给出 BULLET、$9E 给出 zcaron 才能钉住两端,而错位的块不可能同时满足两者
procedure CheckPdfDocEncodingAnchors;
begin
  // Annex D.2 特殊块的两端:整块错位会破坏它们
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // 规范留空的码位不得解成字母
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // 块上方孤立的条目,很容易整个漏掉
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
未定义的码位值得有自己的断言,而不是当无趣内容跳过。差一错误总得把某个东西放到某个地方,而它放的地方几乎总是规范留空的那个码位——前面是 $7F,后面是 $9F。只检查有定义码位的测试,可以在表两个方向都错的情况下照样通过;钉住空洞的测试第一跑就能抓住错位
在往返表单工作流里这要付出什么代价
一个 FDF 导入,如果每遇到一个符号就悄悄改写一个字符,比直接失败更糟,因为失败在下游才浮出水面、而且看起来像别的问题。字段名是这里的刀刃。TPdf.ImportFDF 拿进来的名字和打开文档里的 widget 匹配,而一个解码错一个字符的名字就是匹配不上——字段保持为空,返回值仍然把这个字段算作已解析,从流水线出来的报告短了一个值,日志里没有任何东西解释为什么。任何在搭用 PDFium Component 导出和导入 XFDF 表单数据与注解那类导出-再导入循环的人,在信任这个循环之前,都应该往返一个带排版符号的字段名,而不是只跑纯 ASCII
关于这个修复的边界也值得诚实交代。表现在对全部 256 个字节值都与 Annex D.2 一致,单字节 FDF 字符串能正确解码,但 PDFDocEncoding 本身只覆盖拉丁字符集,仅此而已——范围之外的任何东西都必须以带 BOM 的 UTF-16BE 到达,这正是 §7.9.2.2 的本意。而 UTF-16 字符串在 Delphi 这边还有自己独立的风险,因为超过 U+FFFF 的码点需要一个 surrogate pair,而不是一个 WideChar——这个问题在为什么 emoji 和 CJK 字符会弄坏 Delphi 的 WideChar里讲过。更宽的观点可以推广到编码表之外:一个 PDF 解析器可能拒绝它本该接受的东西,这种你立刻就能发现;也可能接受下来、悄悄搞错,这种你在生产环境里才发现。安全解析 PDF 字典里描述的 name token 陷阱属于第二类,错位一行的表也是——代码路径成功、返回值看起来合理,只有写来对照规范而不是对照实现的测试才会说不是
TPdf 上的 ImportFDF、ExportFDF 和 ImportXFDF,连同它们背后的 FDF 和 XFDF 解析器,都是面向 Delphi 和 C++Builder 的标准 PDFium Component 的一部分