Info 字典里写着 /ModDate (D:20260827093659+08'00'),XMP 包里 xmp:ModifyDate 是 2026-08-27T01:36:59Z,两者说的是同一秒,PDF/A 校验器完全有理由接受这一对。可要是把文档的 Subject 字符串抄进 dc:subject,哪怕文本一字不差,这个包照样不过。ISO 19005-1 §6.7.3 要求的是等价的值,放在指定的 XMP 属性里,摆成指定的 RDF 形状
通常引出这个话题的缺陷报告看起来人畜无害。某个文档管理系统每次增量保存都往 Info 字典盖一个新的 /ModDate,XMP 包则碰都不碰。几个月后归档审计标出成千上万个文件。两个日期都在;只是从第一次编辑起就不再一致,而只检查属性存在与否的校验从来没看出来。走 Info 专用 API 改标题也是同样下场,像 Finance; Controlling 这种被某工具拆成两个 dc:creator 条目的 Author 字符串也一样
ISO 19005-1 对 Info 与 XMP 的要求
ISO 19005-1 表 1 把八个 Info 键与 XMP 属性一一配对,§6.7.3 说的是:Info 键一旦存在,映射的 XMP 属性就必须带上等价的值。键缺席则什么都不要求。PDF/A-2 和 PDF/A-3 对同样八个键保留同样的等价要求。PDF/A-4 反其道而行,直接限制 Info 字典本身:它只能与目录的 /PieceInfo 同现,且只许装 ModDate;TPdf.ValidatePdfA 用 pvaiPdfA4InfoWithoutPieceInfo 和 pvaiPdfA4InfoInvalid 报告这些情形
在 PDFium Component 里,这项比较是 FPdfPdfa.pas 中的 ComparePdfAInfoAndXmp。每个属性都按命名空间 URI 查找,所以把 http://purl.org/dc/elements/1.1/ 绑到生僻前缀上的包,读起来与用 dc 的毫无区别。映射的形状是:
- Title →
dc:title,Subject →dc:description:rdf:Alt语言备选,只与它的x-default项比较;语言标签不区分大小写,没有x-default的 Alt 算缺席 - Author →
dc:creator:rdf:Seq且恰好一个文本项装着完整的 Info 字符串,分号分隔的作者列表保持单一条目 - Keywords →
pdf:Keywords,Producer →pdf:Producer(命名空间http://ns.adobe.com/pdf/1.3/):简单文本属性 - Creator →
xmp:CreatorTool,CreationDate →xmp:CreateDate,ModDate →xmp:ModifyDate(命名空间http://ns.adobe.com/xap/1.0/):简单文本属性
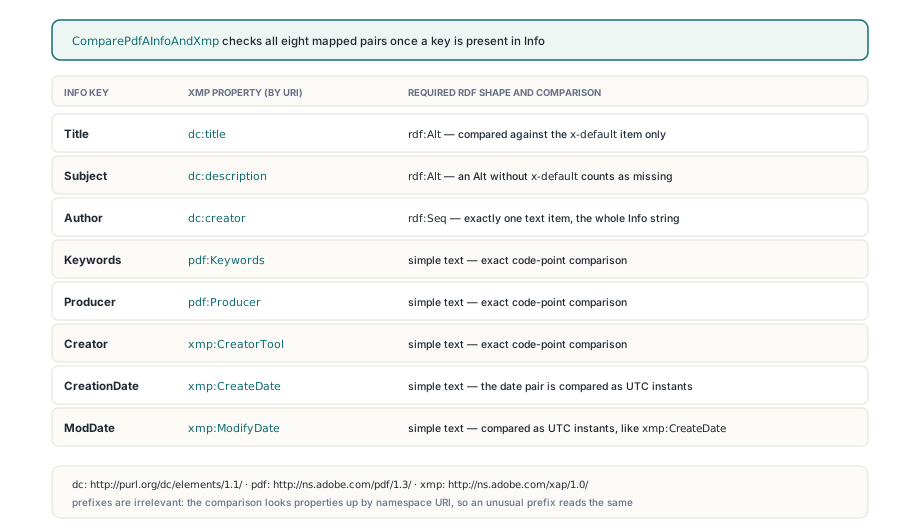
Subject 这一行是手工模板最容易翻车的地方。Dublin Core 的 dc:subject 是个无序的关键词袋子,名字又诱人把 Info 的 Subject 往里塞。比较找的是 dc:description,什么都没找到,把 Subject 报成 pamsXmpMissing,而「正确」的文本就停在隔壁属性上。形状正确的三行长这样:
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
为什么字符串明明正确还是过不了比较
字符串正确还是失败,可能只差一个码位,或者只是站错了容器。文本值按精确的 Unicode 码位序列比较,不去空白、不折大小写、不做规范化。尾部多一个空格就是不匹配。一边是预组合的 é、另一边是分解的 e 加组合锐音符,同样不匹配——尽管两者在屏幕上通常渲染得一模一样
形状错误有独立的状态。dc:title 写成纯文本、dc:creator 声明成 rdf:Bag、或者 dc:creator Seq 里有两个项,报的都是 pamsXmpTypeMismatch 而非 pamsValueMismatch,报告因此能分清「工具选错了 RDF 结构」和「工具写入了不同文本」。这两类问题在流水线里通常出自不同的环节,修错一个就是一下午
Info 一侧永远来自 PDFium 自己对 PDFDocEncoding 与 UTF-16BE 字符串的解码,走 FPDF_GetMetaText,与 TPdf.GetMetadata 同一条路,所以带字节顺序标记或八进制转义序列的字符串,读法与引擎一致。XMP 一侧的干净程度取决于产出它的字节。用错误代码页拼出来的包可以带着谁都不会原谅的乱码,这正是Free Pascal 下损坏 XMP 元数据的代码页陷阱要列进同一张检查清单的原因
PDF 日期与 XMP 日期何时相等
PDF 日期与 XMP 日期相等,指的是精确到同一秒、且双方携带同样的时区信息。两个解析器都接受合法的降精度写法,D:2026 和 2026 都表示 2026 年 1 月 1 日子夜。两侧都带时区时,各自先换算成 UTC:D:20260827093659+08'00' 等于 2026-08-27T01:36:59Z。两侧都没有时区时,本地分量按原样比较
只有一侧带时区时,结果是 pamsValueMismatch。给没有时区的值编一个偏移是猜测,而恰好撞上服务器时区的猜测会在这台机器通过、在那台机器失败。XMP 里 .250 这类非零小数秒同样强制不匹配,因为 PDF 日期表达不了它;.000 则接受。完全解析不了的值报成 pamsInvalidInfoDate 或 pamsInvalidXmpDate
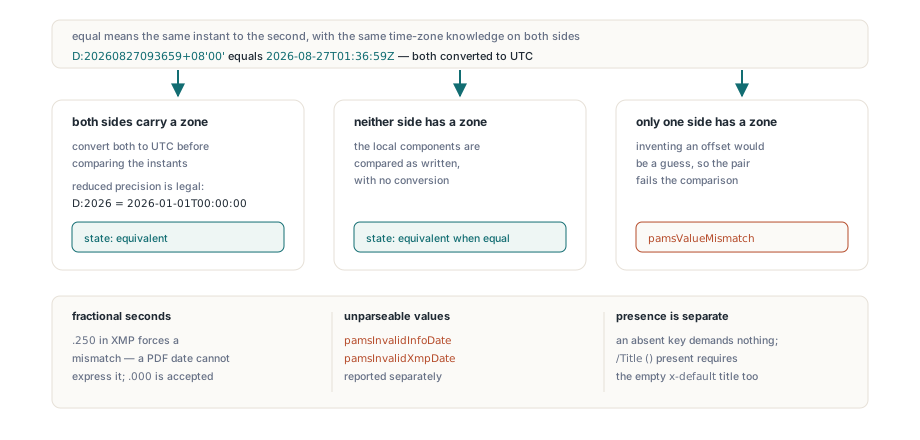
两种日期文法不可互换,解析器对两侧各按各的规矩来。PDF 一侧,偏移分钟两侧的撇号可省,Z 也接受。XMP 一侧的偏移必须带冒号:2026-08-27T09:36:59+08:00 能解析,+0800 则是 pamsInvalidXmpDate。XMP 时间一旦出现 T 就至少要有小时和分钟,超过 14 小时的偏移两侧都拒收。日期解析前会修剪首尾空白——文本字段可没这份优待
存在性另有规矩。TPdfAMetadataValues.Present 是一个集合,靠遍历活动 trailer 的 /Info 字典填成,它把「键缺席」与「键存在但为空字符串」分开。缺席的键给出 pamsNotRequired。/Title () 算存在,所以包里也必须带一个空的 x-default 标题
动文件之前先读逐字段报告
TPdf.InspectPdfAMetadata 返回一个 TPdfAMetadataReport,每个字段一条 TPdfAMetadataComparison。每条都带着 Info 值、XMP 值和一个 TPdfAMetadataState,失败可以逐字段解释。MismatchFields 收集不合格字段的集合,HasXmpPacket 说明是否找到了包,包在但读不出来时 XmpParseError 带着解析器的消息。最后这种情形下,每个存在字段都报 pamsXmpMissing,因为从包里什么都没读到
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
TPdf.ValidatePdfA 把同一套比较并进自己的问题集。字节级扫描(用 PDFium Component 做 PDF/A 预检验证一文有述)在包里两个日期属性都缺时报 pvaiMissingXmpDates,在 Info 带 CreationDate 或 ModDate 而包里没有对应日期属性时报 pvaiInfoXmpDateMismatch。在此之上,ValidatePdfA 还会跑完整的值比较,只要包存在但与 Info 不一致——读不出来的包也算——就追加 pvaiInfoXmpValueMismatch。完全没有包的文档只报 pvaiMissingXmpMetadata,一个缺陷绝不报两遍。流级的 ValidatePdfACompliance 函数只做字节级扫描
function MetadataGateOk(Pdf: TPdf): Boolean;
var
  Res: TPdfAValidationResult;
begin
  Res := Pdf.ValidatePdfA;
  if pvaiMissingXmpMetadata in Res.Issues then
    Writeln('No usable XMP packet: rebuild the file with SaveAsPdfA');
  if pvaiInfoXmpDateMismatch in Res.Issues then
    Writeln('Info has a date property the XMP packet lacks entirely');
  if pvaiInfoXmpValueMismatch in Res.Issues then
    Writeln('Mapped values disagree: run InspectPdfAMetadata for details');
  Result := Res.IsCompliant;
end;
NormalizePdfAMetadata 重写什么,止步于哪里
TPdf.NormalizePdfAMetadata 把 Info 字典当唯一事实来源,只重写落入 MismatchFields 的那些 XMP 属性。Title 和 Subject 写进 x-default 项,其他语言备选原样保留。Author 变成单项 rdf:Seq。带时区的 Info 日期写成带 Z 后缀的规范 UTC XMP 日期,无时区的保留本地分量。未知命名空间、无关属性以及缺席 Info 键对应的 XMP 属性都不碰,写回属性时复用已有的前缀绑定
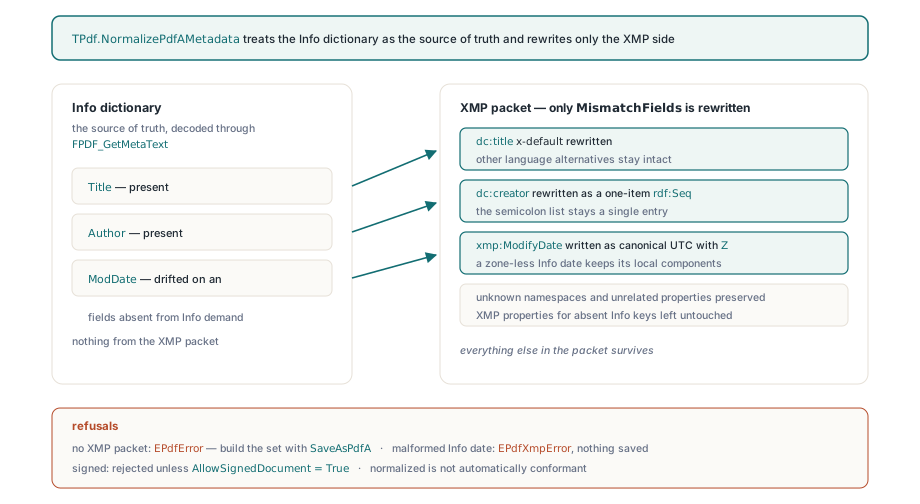
让 Info 说了算是有代价的,真实文件上就会显形。把「Finance」和「Controlling」当两个人列的 dc:creator Seq,会被替换成读作 Finance; Controlling 的单一条目;放错容器的 dc:title 会重建成只装 x-default 的全新 Alt,旧容器里装过什么就此消失。这个损失在此可以接受:表 1 只允许一个 creator 条目,Info 字符串本来就把完整名单囫囵装着,谁真需要更丰富的列表,原始包还在源文件里
拒绝是刻意的。没有 XMP 包时方法抛 EPdfError:搭一套完整的 PDF/A 标识与元数据是 SaveAsPdfA 的职责,见用 PDFium Component 创建 PDF/A 归档文件。读不出的包或畸形的 Info 日期在任何写入发生前抛 EPdfXmpError,因为 XMP 里一个看似合理的错日期比没有输出更糟。已签名的文档抛 EPdfError,除非调用方传 AllowSignedDocument = True;输出是完整保存,新元数据以增量更新追加,所以签名字节不会原样保留
这条保存路径还有一个副作用。哪怕每个字段都已一致,NormalizePdfAMetadata 也会写出新文件——同步了个寂寞照样以保存收场。先调 InspectPdfAMetadata,等价的文件直接跳过;夜间任务把几千个没变化的归档重写一遍,换来的只是新的文件时间戳。文件重载经临时文件写入、原子替换目标。文档加载期间源文件一直开着,输出请换个路径
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // 已经一致,别动这个文件
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // Info 日期畸形或包读不出来
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
      on E: EPdfError do         // 未传 AllowSignedDocument 的签名输入
        raise Exception.CreateFmt('Skipped %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
等价性只是 ISO 19005-1 的一个条款。规范化后的文件还要过字体、色彩、透明度和其余所有 PDF/A 检查,文档走进长期存储之前,ValidatePdfA 依然是那道闸门
不开文档比较包
ComparePdfAInfoAndXmp 和 SynchronizePdfAInfoToXmp 是 FPdfPdfa 里的普通函数,作用在 TPdfXmpPacket 上、无须打开 PDF,适合单元测试,也适合文档还不存在、先从模板填 XMP 的流水线。SynchronizePdfAInfoToXmp 返回它重写的字段集合,递进来的包是 nil 时抛 EPdfXmpError
唯一的坑是 Present。用 Default(TPdfAMetadataValues) 初始化的记录集合为空,每个字段都报 pamsNotRequired,随便填什么值比较都会通过。记录的字符串字段装着值;哪个值是标准真正要求的,只有 Present 说了算
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present 决定哪些字段是必填的;光有值会被无视
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // 不一致的 xmp:ModifyDate 变成 2026-08-27T01:36:59Z,
    // 不一致的 dc:creator 变成单项 rdf:Seq
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
之后把同一份模板跑一遍 ComparePdfAInfoAndXmp,应当得到空的 MismatchFields——对重新生成模板的构建步骤来说,这是一句便宜的断言
被其他系统不断编辑的归档,一次漂移一个字段,逐字段报告会指出动的是哪个。InspectPdfAMetadata、NormalizePdfAMetadata 以及其余 PDF/A 验证与转换工具,都在 PDFium Component for Delphi and C++Builder 里