一份发票档案可以渲染干净、打印正常、嵌好所有字体、带上有效的输出意图,PDF/A 校验器照样拒绝它——因为某个资源字典有 4,096 个条目。上限是 4,095。PDF/A 从 PDF Reference 继承了一张小小的实现限制表,任何一项超出一个单位,文件就不合格,哪怕没有任何查看器抱怨
另一类失败落在同一个“看起来明明没问题”桶里:符号型 TrueType 字体带了 /Encoding 条目。复选框、条形码、装饰符号在屏幕上全都正确,校验器依然标记字体字典。这两个问题都住在对象图里,而不是人能在页面上看见的任何东西里,所以值得在文件进档案之前机械地查一遍
PDF/A 继承的数字,以及边界在哪里
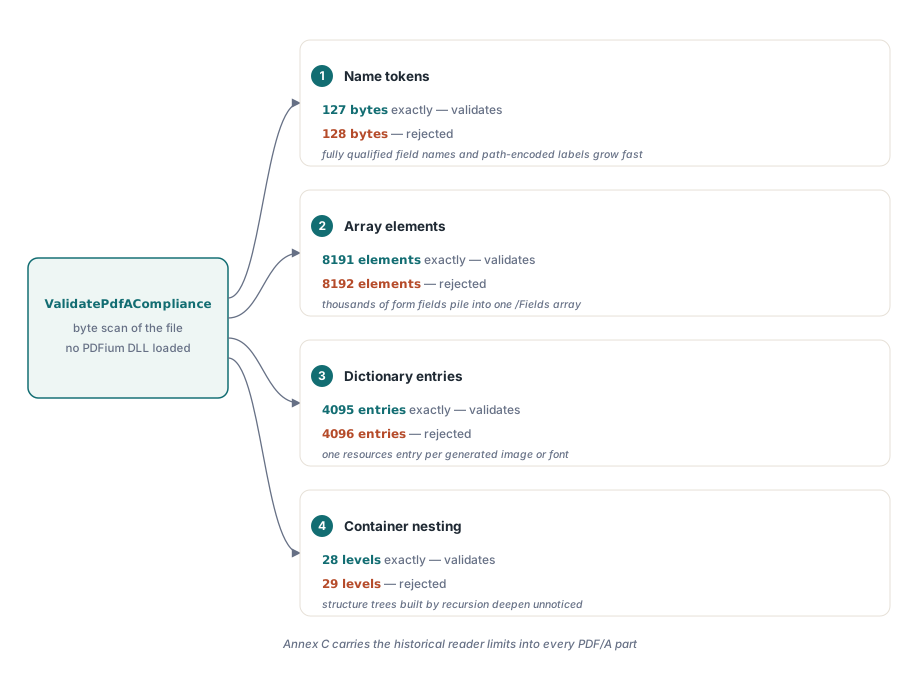
PDFium Component 在每次 PDF/A 校验时检查四个容器限制:名称记号最长 127 字节,数组最多 8,191 个元素,字典最多 4,095 个条目,数组与字典最多嵌套 28 层。四个边界全部含端点。127 字节的名称通过,128 字节的失败;恰好 8,191 个元素的数组通过,再多一个就失败
名称、数组和字典限制来自那样的年代:合规阅读器只被要求处理到这些尺寸。现在的桌面查看器也许能毫无怨言地打开大得多的数组,但档案文件的使命是在还没人测试过的阅读器里打开——包括记录系统可能仍在运行的老版本。这就是 PDF/A 保留历史上限而不放宽的原因
含端点还是不含端点正是手写检查最容易出错的地方。把测试写成 Count >= 8191 而不是 Count > 8191,会拒绝本来合规的文件;而一个拒绝合规文件的校验器往往反而被人信以为真,于是生成器为一个从未存在的问题被“修”了一遍。FPdfPdfA 单元的 ValidatePdfACompliance 严格按超限计数,并且直接读文件字节,所以检查不用加载 PDFium DLL 就能跑
uses
  System.Classes, FPdfPdfa;

procedure CheckContainerLimits(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Res: TPdfAValidationResult;
begin
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfACompliance(Src);   // 字节扫描,不需要 PDFium DLL
    if pvaiNameOverLimit in Res.Issues then
      Log.Add('A name token is longer than 127 bytes');
    if pvaiArrayOverLimit in Res.Issues then
      Log.Add('An array holds more than 8191 elements');
    if pvaiDictOverLimit in Res.Issues then
      Log.Add('A dictionary holds more than 4095 entries');
    if pvaiNestingOverLimit in Res.Issues then
      Log.Add('Arrays and dictionaries nest deeper than 28 levels');
    if Res.IsCompliant then
      Log.Add('No PDF/A findings');
  finally
    Src.Free;
  end;
end;
这四个标志是 TPdfAValidationResult 上 Issues 集合的成员,与其他所有 PDF/A 发现并列;只有找到了 PDF/A 标识且集合为空时,IsCompliant 才返回 True。完全不带 PDF/A 标识的文件按严格的 PDF/A-1 规则集检查,所以容器限制对它同样适用
哪些生成器会撞上这些限制?
几乎总是那些在循环里构建结构的。一个几千字段的表单会产出越过 8,191 条目的 AcroForm /Fields 数组,或页面 /Annots 数组。一个为每个生成对象注册一款字体或图像资源、从不复用既有条目的报表引擎,会把 /Resources 子字典养到 4,095 个键以上。靠递归嵌套数据模型产出结构树的标记文档,没人看着也能越过 28 层
超长名称另有来历:数据被打包进名称记号。以客户参考号命名的专色色料,以文件路径命名的可选内容组,由六层层级拼装的字段标签。名称生成起来零成本,而一旦涉及带变音符的 UTF-8 标签,127 字节很快就用完——那些字符每个要占两三个字节。127 字节从 / 引导符之后数起,到下一个定界符或空白为止
补救每次都是结构性的:拆数组、拆字典、压平递归、缩短名称。往文件里注入 PDF/A 标记对其中任何一条都无济于事,因为问题出在对象图的形状上,XMP 元数据对此一字不提
扫描如何计数元素与条目
想在十六进制编辑器里复现一条发现时,计数规则就重要了。嵌套的数组或字典作为其父容器的一个元素计数——限制就是这么陈述的:一个由 1000 元素数组组成的 10 元素数组没问题,因为没有任何单个数组超过 8,191。字典里只数键,恰好是名称的值不会虚增条目总数。<FEFF0041> 这类十六进制字符串作为单个记号跳过,所以它们的花括号永远不会被误当成字典嵌套
扫描覆盖整个文件的对象结构,包括存放在压缩对象流里的对象——计数前先展开。流主体本身,比如页面内容和图像数据,先被抹掉,所以一段碰巧含 / 或 [ 的二进制字节不会触发虚假的名称或数组发现
同一校验还在自己的标志下报告一个相邻的数值限制。文件声明 PDF/A-2 或更后部分时,任何落在 32 位有符号范围之外——即 −2,147,483,648 到 2,147,483,647 之外——的整数记号都会触发 pvaiIntegerImplementationLimit。把字节偏移或大计数器写成普通整数的生成器是常见来源
为什么符号型 TrueType 字体必须去掉 /Encoding?
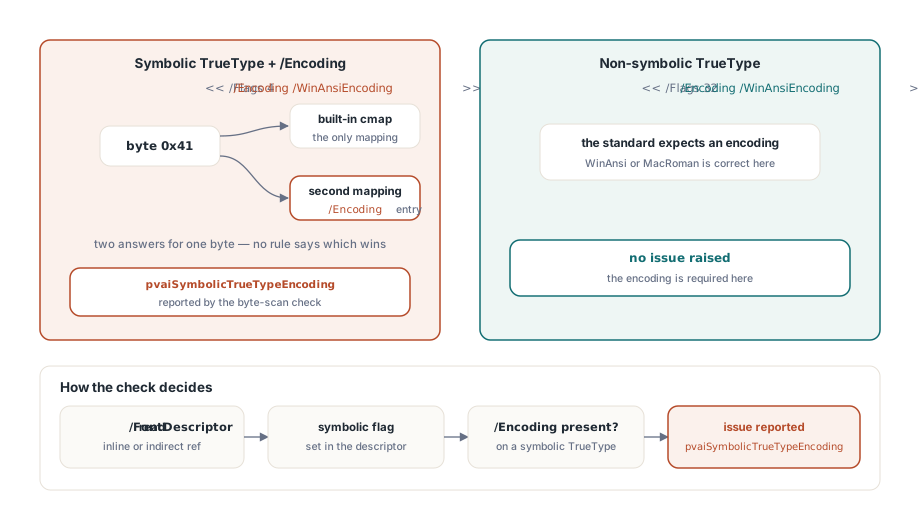
ISO 19005-1 §6.3.7 只承认字体程序内置的 cmap 作为符号型 TrueType 字体的字符映射。符号型字体按自己的规矩把编码映射到字形——Symbolic 标志声明的正是这件事。加上一个 /Encoding 条目,文件对“字节 0x41 选哪个字形”就有了两个答案,而文件里没有任何东西说明哪个作数。阅读器各按各的方式解决冲突,同一个复选框在一个查看器里是勾、在另一个里是字母 A
ValidatePdfACompliance 找出每一条 /Subtype /TrueType 的字体字典,检查有没有 /Encoding 键,然后读字体描述符里 /Flags 条目的第 3 位(值 4)。描述符内联写或以间接对象引用都照样跟随。保留 /WinAnsiEncoding 或 /MacRomanEncoding 的非符号型 TrueType 字体不会被这条检查标记,因为对非符号字体,PDF/A 期待的就是这种编码
// Res 来自 ValidatePdfACompliance,同第一个示例
if pvaiSymbolicTrueTypeEncoding in Res.Issues then
  Log.Add('A symbolic TrueType font carries /Encoding; PDF/A admits only ' +
    'the font''s built-in cmap (ISO 19005-1 6.3.7)');

// 一条相邻的字体规则,触发条件不同:非符号型
// TrueType 字体的 Encoding 字典携带 /Differences
if pvaiTrueTypeDifferencesForbidden in Res.Issues then
  Log.Add('A non-symbolic TrueType Encoding dictionary carries /Differences');
踩中这条规则的字体可以预言:Symbol、Wingdings、条形码字体、图标字体。它们以复选框、评分星星和条形码的形态出现在业务文档里,而一视同仁处理所有 TrueType 字体的子集化步骤也会替它们写出编码。校验器说“字体问题”时没人会看它们——因为正文字体总是先被检查
反过来的错误也在野外出现:生产方给一款其实是 WinAnsi 编码的普通文本字体设了 Symbolic 标志。PDF/A 检查按条款原文报告那款字体,而这里的修复该落在描述符上:改描述符里的标志,而不是删编码。从被贴错标签的文本字体上删掉 /Encoding,会让文本依赖子集碰巧带着的那张 cmap——文件反而比你入手时更糟。先看看字体的字形集,再决定拆掉矛盾的哪一半
在预检报告里读这些发现
预检报告单元随 Enterprise 版提供,而 ValidatePdfACompliance 每个版本都有。FPdfPreflightReport 单元里的报告把四个容器限制归进 Structure 类,把符号型 TrueType 编码问题归进 Content 类。这个分法是刻意的:结构发现通常回到维护生成器的人那里,内容发现通常去找供字体和模板的人,混在一起的报告会让两个人都去追不属于各自的问题
每条 issue 的 Code 是它的枚举名,推荐语把补救讲得具体,例如“拆分字典,让任何一个都不超过 4095 个条目”。注意 Structure 类里还有另外两条发现——Level A 声明缺失标记结构,以及 PDF/A-1 文件里的 PDF 1.5 交叉引用流或对象流——所以只要四个限制时请按代码过滤
uses
  System.SysUtils, System.Classes, PDFium, FPdfPreflightReport;

procedure ReportStructureFindings(const FileName: string; Log: TStrings);
var
  Pdf: TPdf;
  Report: TPdfPreflightReport;
  Issues: TPdfPreflightIssues;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;          // 这条路径加载 PDFium DLL
    if not Pdf.Active then
      Exit;
    Report := BuildPdfPreflightReport(Pdf, [ppsPdfA]);
    Issues := Report.FilterByCategory('Structure').FlattenIssues;
    for I := 0 to High(Issues) do
      Log.Add(Issues[I].Code + ': ' + Issues[I].Recommendation);
    Report.SaveJsonToFile(ChangeFileExt(FileName, '.preflight.json'));
  finally
    Pdf.Free;
  end;
end;两条路径回答的问题略有不同。BuildPdfPreflightReport 走 TPdf.ValidatePdfA:把打开的文档存成临时副本,对副本跑同一套字节扫描,再追加需要 PDFium 引擎的检查——比如页面上用了却没嵌入的字体。ValidatePdfACompliance 判定的是磁盘上的确切字节。对实现限制,信原始文件的字节路径:它报告的是你正要归档的那份文件,而且能跑在无法部署原生 DLL 的构建步骤或锁定服务里。同时还想要引擎级检查和 JSON、SARIF 或 JUnit 输出给流水线用时,用报告路径
接下来去哪里
跨文件夹跑这些检查、判定哪些发现拦截发布、把结果变成人们愿意读的报告,这些在Delphi 中的 PDF/A 预检校验演练和批量预检报告 CLI里有覆盖。一开始该瞄准哪个 PDF/A 部分与合规级别,是PDF/A 归档合规笔记的主题;这个选择也决定整数限制是否适用
本文展示的校验器随 PDFium Component 提供,支持 Delphi、C++Builder 和 Lazarus,与 PDFium 引擎之上的渲染、表单填写和编辑并列。PDFium Component 产品页列出支持的合规标准、版本与编译器版本