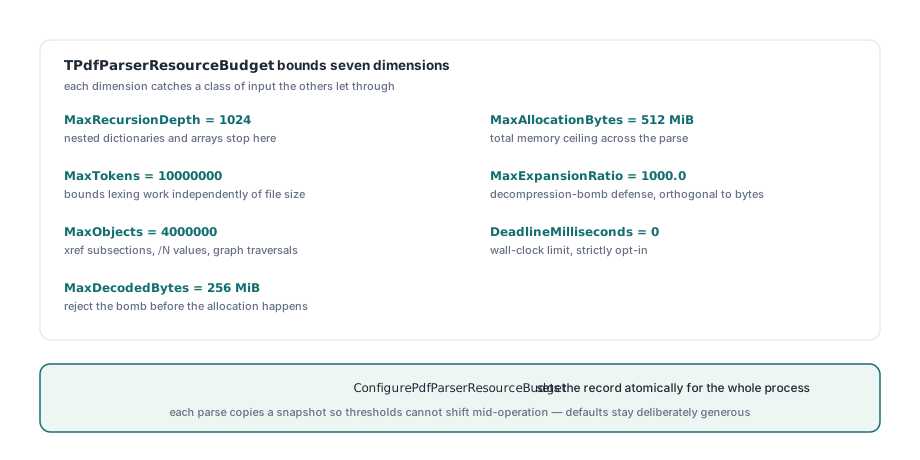
PDFium Component 暴露了 TPdfParserResourceBudget——一个单条记录,为库里每个 PDF 解析器约束递归深度、token 数、对象数、解码字节、膨胀比、分配量,以及一个墙钟截止时间。ConfigurePdfParserResourceBudget 以原子方式为进程设置它,而每次解析都复制一份快照,让阈值在操作中途无法漂移
六个解析器,六套私有的上限
逼出这个功能的处境很平常,八成你也熟。稀疏 xref 遍历有自己的对象上限。流检查器有自己的解码字节上限。XMP 有一套,XFDF 和 FDF 另有一套,内容规范化还有第三套,preflight 默认值是第四套。这些数字单独看每个都说得过去,但外部一个都够不着——于是想表达「这个摄入路径处理匿名上传,这里任何东西都不许分配超过 64 MiB、或者跑超过四秒」的调用方,找不到地方说这句话。第二个问题更糟,因为它是无声的:凡是限制真的住在一个可变全局里,一次在一套策略下开始的解析,完全可能在另一套策略下结束。一个线程调 setter 时,另一个线程正在对象流中途,于是那趟遍历的前半段受旧上限约束,后半段受新上限约束。什么都不崩、什么都不记日志,事后你甚至说不清这次操作到底在什么限制下跑的——而这恰恰是你需要限制的那个性质
TPdfParserResourceBudget 到底约束什么?
七个维度,选它们是因为每一个都能拦下其他维度放过去的一类输入。MaxRecursionDepth 默认 1024,防止嵌套字典和数组把 ISO 32000-1 §7.3 的对象语法变成栈溢出。MaxTokens 默认 10,000,000,与文件大小无关地约束词法分析的工作量。MaxObjects 默认 4,000,000,覆盖交叉引用子节计数、对象流 /N 值和图遍历。MaxDecodedBytes 默认 256 MiB,MaxAllocationBytes 默认 512 MiB,所以文件能在分配之前被拒绝,而不是分配之后。MaxExpansionRatio 默认 1000.0,是那个最容易被低估的:ISO 32000-1 §7.4 的流过滤器是通用压缩,几 KB 的 Flate 数据合法地膨胀成几百 MB 完全可能,膨胀比上限就是对抗解压炸弹的标准防御。它和绝对字节上限正交,因为一份想从 200 KiB 变成 200 MiB 的流,在 256 MiB 上限之下却照样荒谬。DeadlineMilliseconds 默认 0,也就是没有截止时间,这个维度严格选择加入。整套默认值是有意放宽的,尺寸按「别让普通业务文档碰到任何限制」来定,不是加固配置;如果你的输入来自公开上传表单,你想要的应该更接近下面这些数字,同时配合加固 Delphi PDF 预览窗格里描述的规则
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // 保留默认值:MaxRecursionDepth 1024、MaxTokens 10000000、
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // 默认 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // 默认 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // 默认 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // 默认 0 = 关闭
  ConfigurePdfParserResourceBudget(Budget);
end;
为什么拿快照而不是读全局?
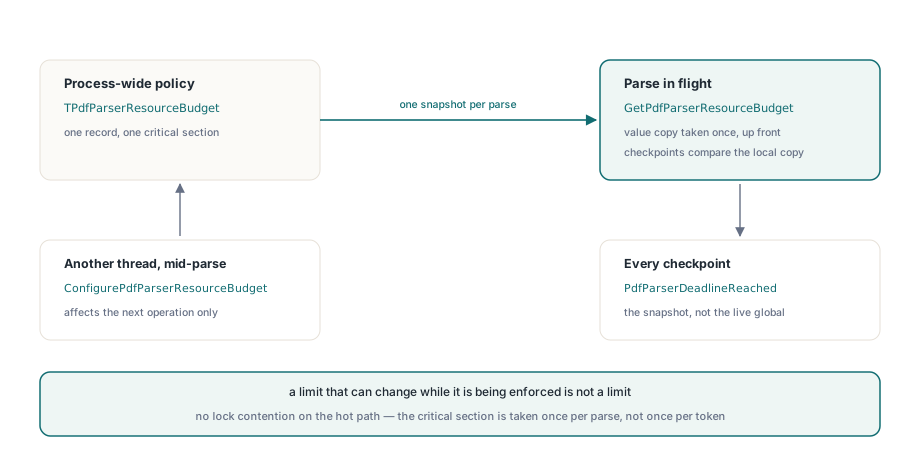
因为一个在执行过程中还能变的限制,就不是限制。这是整个功能的核心设计点,在每个入口处就是一行纪律:操作开始时把策略读一次到本地 TPdfParserResourceBudget,之后每个检查点都拿那份本地副本比较。GetPdfParserResourceBudget 进入临界区,交回记录的按值副本,此后解析再也不会碰可变全局状态。结果是:另一个线程调 ConfigurePdfParserResourceBudget 只影响下一次操作,绝不影响在飞的那一次。并发的解析在不同策略下互不干扰地跑,因资源限制失败的操作是败在单一套一致的阈值上,热路径上也没有锁竞争,因为锁每趟解析只取一次,而不是每个 token 取一次
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // 开头就取一次快照
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
如果你在库之上写自己的解析器,照抄这个形状,别在 token 循环里调 GetPdfParserResourceBudget。每个 token 调一次在正确性上没问题,但没有意义:你每一轮迭代都在付临界区开销,还把快照本来要防止的操作中途漂移重新请了回来
为什么字节上限挡不住病态文件?
因为在 PDF 里,大小和开销只是松散相关。一份 400 KiB 的文件,带着 ISO 32000-1 §7.5.8 交叉引用流、/Index 和 /W 数组描述一个看似合理实则敌意的条目数,或者一条反复回访同一偏移量的对象流链,或者一串每个操作符都比表面看着贵的 content stream,就能舒舒服服待在你设的每个字节和对象上限之下,还占着工作线程好几分钟。字节数约束内存,约束不了时间。这就是 PdfParserStartTick 和 PdfParserDeadlineReached 的用途。PdfParserStartTick 在操作开始时抓一个 tick 值,PdfParserDeadlineReached 拿已用时间和 DeadlineMilliseconds 比较,截止时间为 0 时一律返回 False。减法走无符号算术,所以 tick 计数器回绕不会产生假超时。交叉引用解析、对象流解码、内容 token 规范化和 FDF、XFDF 读取器都在循环头检查它,于是超预算的解析在检查点停下来,而不是从外面被杀掉
两条诚实的告诫。它是墙钟时间,不是 CPU 时间,所以一台在换页的机器、或者负载下的构建服务器,可能触发一台安静的机器不会触发的截止时间——这支持把值设在观察到的坏情况之上很远,而不是贴近中位数。而且它默认关闭,因为在月末批处理时,截止时间在合法的大文档上触发,比它防止的那个失败更糟。按摄入路径选择加入,而不是全局开,再配合验证交叉引用流里的结构性检查一起用
预算是个上限,不是格式限制的替代品
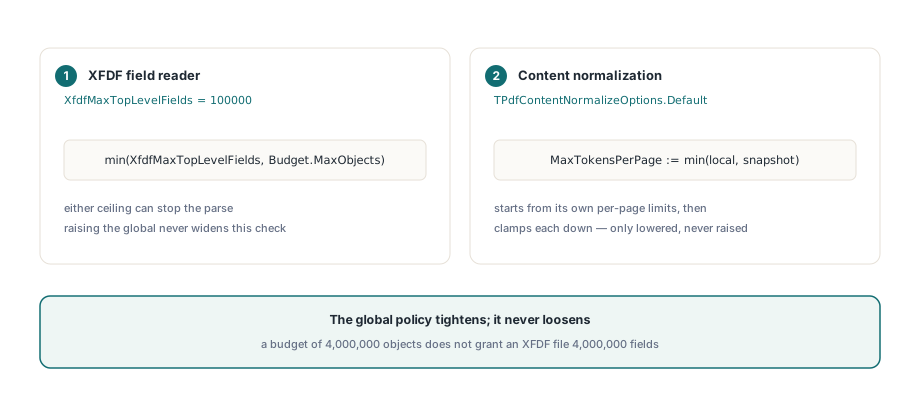
每个解析器保留自己的格式专属常量,并且两者都应用。XFDF 是最清楚的例子:字段读取器在快照值之外,还强制 XfdfMaxTopLevelFields 和一个 100000 的 MaxFieldNodes 常量,两者任一个都能叫停解析
const
  XfdfMaxTopLevelFields = 100000;   // 格式专属,始终生效
...
  // 两个上限都活着;谁低谁赢
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
这是有意的,值得在你去找那个不存在的旋钮之前先消化掉。4,000,000 个对象的全局预算,并不等于给 XFDF 文件 4,000,000 个字段——100000 个字段已经远超真实注解导出会产生的数量——提高全局上限也不该悄悄放宽某个格式专属的 sanity 检查。内容规范化从另一个方向做同样的事:TPdfContentNormalizeOptions.Default 从自己的每页限制出发,再把每个都向下钳制到快照值,所以 MaxTokensPerPage 只能被预算调低,永远不会被调高。全局策略只会收紧,从不放松
坏的配置在配置时就失败
ConfigurePdfParserResourceBudget 在赋值之前先校验。六个数字维度里任何一个非正,立即抛错;MaxDecodedBytes 超过 High(Integer) 也按超出平台限制被拒绝,而不是在某个解码器深处被悄悄截断。这事比听上去重要:从配置文件里构建预算时,缺一个键就会给你一堆零;启动时接受一个零对象上限,三个小时后第一份文档上就变成一次莫名其妙的解析失败,而那时没人会怀疑配置。同样的谨慎适用于任何临时收紧预算的代码,包括测试。策略是进程级的,所以 fixture 跑完后还留着一个 4 秒截止时间,会毒害后面每一个用例;改动周围要保存并恢复
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
ResetPdfParserResourceBudget 是更粗的那版,直接恢复 TPdfParserResourceBudget.Default。在想要已知状态的测试清理里用它;生产代码里用保存-恢复,因为宿主应用启动时配置了什么,就是你必须回到的状态
预算在哪里不再帮忙
它是单一的进程级策略,这是它主要的局限。你不能给一个工作线程严格配置、给另一个宽松配置,因为一道临界区后面只有一条记录;如果你真的需要按租户限额,行得通的形状是把每种策略类别各自序列化到自己的进程里,或者用保存-恢复把工作括起来、同时接受这个括号只在没有其他东西并发解析时才安全。它约束的也只是解析,不是渲染:光栅化内存、字体缓存增长和图片解码都不在这七个维度之内,需要各自的控制。而且预算只能告诉你一次操作太贵,永远不告诉你为什么。被触发的上限是症状,它背后的畸形 /Index 数组或失控的过滤器链还是得手工诊断——这正是对象流与 predictor 解码里描述的解码路径值得在动手调数字之前先搞懂的原因。把预算当成「别让坏文档把进程一起拖下水」的东西,同时把日志写到足够好,好能查清文档当时在干什么
完整的解析器 API 面、预算记录,以及 Delphi、C++Builder 和 Lazarus 的源码构建,都在产品页上:PDFium Component