往叶子数组里补一个名字,条目照样可能被读成不存在。PDFium Component 用 TPdfTreeEditor 回应这件事——一个针对 ISO 32000 名称树和编号树的通用编辑器:严格校验地载入树、在内存里改条目、重建出 /Limits 正确的平衡节点集,再写出一份经过校验的增量修订
催生这个单元的那个故障,属于只能靠读字节来诊断的那种。某个工具往叶子 /Names 数组里追加了一个键值对、写了一份新修订,每个 hex dump 都确认键就在文件里。Acrobat 仍然说附件不存在。按朴素意义看,什么都没损坏。只是这棵树不再是一棵查找算法能下潜的树了
为什么补过的叶子数组会弄坏查找?
因为查找是沿着 /Limits 做二分下潜,不是扫叶子。ISO 32000-1 §7.9.6 把名称树定义为:一个根,/Kids 一路下到持有 /Names 的叶子——/Names 是键和值交替的数组,键按字节比较在全树范围内有序——每个非根节点都把 /Limits 声明为自身的最小和最大键。合规的 reader 把要找的键和每个 kid 的范围比一遍,只打开一个子节点。往叶子里追加键却不动旧的 /Limits,下潜就会径直越过真正持有它的那个节点
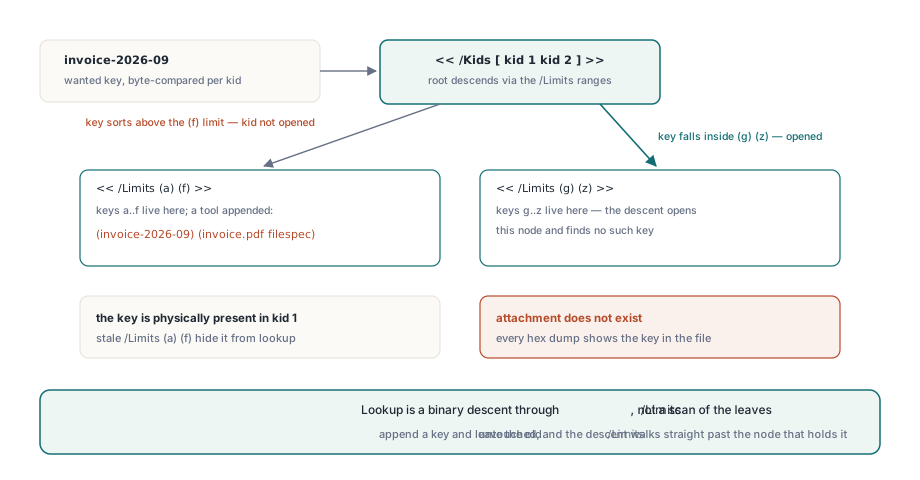
编号树(§7.9.7)形状相同,用 /Nums 和整数键,而且真的在跑业务:§12.4.2 的 /PageLabels 就是编号树,§7.7.4 的 catalog /Names 分类给了你 /Dests、/EmbeddedFiles 和 /JavaScript 三棵名称树。所以四条不变量必须同时成立,而不是一条一条来:键按树序严格递增、每一层发布的 limits 必须和实际键范围一致、兄弟范围不得重叠、根的 object number 和 generation 必须待在原地不动——因为 catalog 和任何其他引用方都是通过间接引用指着那个根。我们在 Delphi 里用 PDFium Component 处理 PDF 附件的笔记,展示了同一结构的消费端
TPdfTreeEditor 拒绝载入什么?
比你想的多,而且是有意为之。TPdfTreeEditor.TryLoad 通过 TPdfSparseDictionaryReader 走节点图,用 ReadDictionary 解析每个子节点时,按引用点名的那个精确 generation 取,而不是接受当前碰巧生效的修订。无法被证明良构的树,在允许任何一次编辑之前就被拒绝,这样坏的输入不会变成看起来像模像样的坏输出
- 环和重复引用,两者都报为
ptviCycle,所以指向链路上游的/Kids条目会终止而不是无限递归 - 节点形状混杂:同时携带
/Kids与/Names或/Nums的字典报ptviInvalidNodeShape,空的非根叶子同样 - 未排序或重复的键,报
ptviUnsortedKey和ptviDuplicateKey,检查范围是整趟遍历而不是单张叶子内部 - 和实际存在的键对不上的 Limits,报
ptviInvalidLimits - 不是恰好一个完整 PDF 对象的原始值,报
ptviInvalidValue - 预算超限:
ptviDepthLimit、ptviNodeLimit、ptviEntryLimit和ptviDeadlineExceeded,同时受TPdfTreeEditOptions和中央解析器预算约束
TPdfTreeEditOptions.Default 把这些树级边界设为:1,000,000 个条目、100,000 个节点、深度 64、每张叶子 64 个条目、每个节点 32 个 kid。叶子和 kid 这两个数字不只是护栏,它们还是之后重建树时用的扇出,这就是为什么记录会校验两者至少为 2
uses
  FPdfCompress;

var
  Options: TPdfTreeEditOptions;
  RootRef: TPdfTreeObjectReference;
  Editor: TPdfTreeEditor;
  Report: TPdfTreeValidationReport;
begin
  Options := TPdfTreeEditOptions.Default;
  RootRef.ObjectNumber := EmbeddedFilesRootObject;   { catalog 的 /Names /EmbeddedFiles }
  RootRef.Generation := EmbeddedFilesRootGeneration;
  if not TPdfTreeEditor.TryLoad(Source, ptkName, RootRef, Options,
    Editor, Report) then
  begin
    Writeln('tree rejected: ', Report.ErrorMessage);
    Exit;
  end;
  try
    { 值是恰好一个完整 PDF 对象的原始字节 }
    Editor.UpsertName('invoice-2026-09',
      '<< /Type /Filespec /F (invoice.pdf) /EF << /F 42 0 R >> >>');
    Editor.RemoveName('draft-2025-11');
  finally
    { 下面保存之后再做 Editor.Free }
  end;
end;
条目值保持为原始 PDF 对象字节
条目值原样存储,这是让编辑器可以安全指向你没产出的文件的唯一设计决策。TPdfTreeEntry 持有 NameKey、NumberKey 和 RawValue,而 RawValue 是一个完整 PDF 对象的原始字节串:字典、数组、字符串、流引用或裸间接引用都行。什么都不解码成 Delphi variant、TStrings 或类型化记录。回报是:这个单元完全不了解的值也能无损往返。带厂商扩展的 /Filespec、fit 类型不寻常的目标数组、带私有键的 /JavaScript action 字典,全都逐字节熬过重建,因为编辑器从来不需要对它们的内容发表意见。它还把修改 API 缩到可证明的规模:UpsertName 和 UpsertNumber 只需验证提供的值解析出来恰好是一个完整对象,RemoveName、RemoveNumber 和 Clear 只碰条目列表
如何在不给根重新编号的前提下重建平衡树?
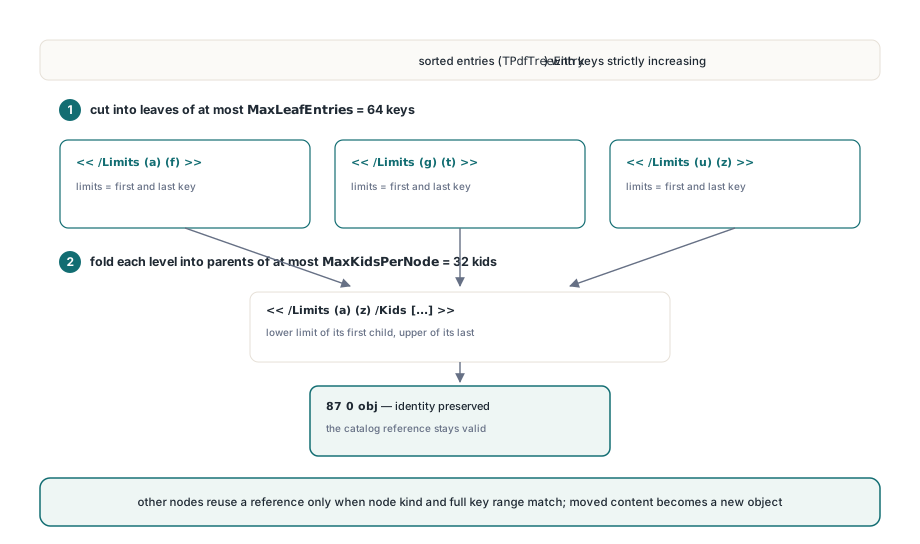
两趟扫描加一个固定点。BuildBalancedObjects 先把排好序的条目列表切成最多 MaxLeafEntries 个键的叶子,再把每一层折成最多 MaxKidsPerNode 个 kid 的父节点,重复到只剩一个节点为止。Limits 自底向上计算:叶子取自己的首键和末键,内部节点取第一个孩子的下限和最后一个孩子的上限,所以兄弟范围重叠在构造上就不可能发生
固定点就是身份。最终的根永远拿到树被载入时的那组 object number 和 generation,所以 catalog 引用保持有效,文档里其他什么都不用重写。其他每个节点只有在节点类型匹配、且完整键范围匹配时,才复用之前载入节点的引用;否则从活动最大 object number 加一分配一个新号。这个组合让未变化的子树继续指向它们现有的对象,同时保证任何内容有变动的节点都写成新对象,而不是被悄悄重新解释。同一套引用复用纪律也驱动着兄弟单元里的大纲编辑器及其页面重映射
var
  Serialized: TPdfTreeSerializedObjects;
  I: Integer;
begin
  { FirstNewObjectNumber 来自源修订 }
  if Editor.BuildBalancedObjects(MaximumObjectNumber + 1,
    Serialized, Report) then
  begin
    Writeln('nodes ', Report.NodeCount, ' depth ', Report.MaximumDepth);
    for I := 0 to High(Serialized) do
      Writeln(Serialized[I].Reference.ObjectNumber, ' ',
        Serialized[I].Reference.Generation, ' obj');
  end
  else
    for I := 0 to High(Report.Issues) do
      Writeln('issue ', Ord(Report.Issues[I].Kind), ' at obj ',
        Report.Issues[I].ObjectNumber, ': ', Report.Issues[I].Message);
end;
写出修订,再把结果读回来
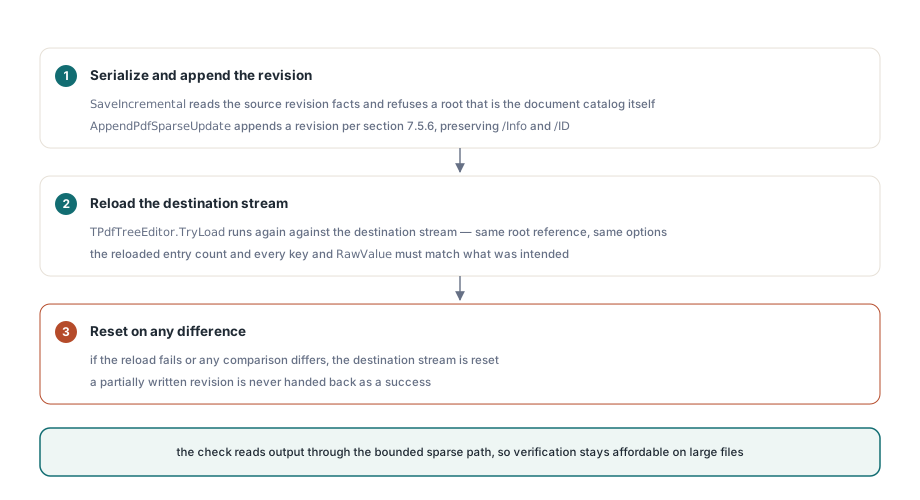
一份保存只有在输出被重新打开并比对之后才算完成。SaveIncremental 读取源修订的事实、拒绝把文档 catalog 本身当根、序列化平衡节点集外加 catalog 对象,然后把一切交给 AppendPdfSparseUpdate——它按 §7.5.6 追加一份新修订,同时保留既有的 /Info 引用和文档 /ID 数组
接下来是值得抄进你自己 writer 的部分。编辑器再次调用 TPdfTreeEditor.TryLoad,这次对着目标流,用相同的根引用和相同的选项,把重新载入的条目数、每个键和每个 RawValue 和它打算写的内容比对。只要重载失败或任何一处比对不同,目标流就被重置而不是返回,所以半截写坏的修订永远不会被当作成功交出去。验证通过我们稀疏惰性 PDF 对象索引那篇里描述的同一套有界稀疏路径读输出,这正是大文件上这项检查还付得起的原因
var
  Dest: TFileStream;
begin
  Dest := TFileStream.Create(OutputName, fmCreate);
  try
    if Editor.SaveIncremental(Source, Dest, Report) then
      Writeln('wrote ', Report.NodeCount, ' nodes, ',
        Report.EntryCount, ' entries')
    else
      { 目标流已重置,没有保留任何半截写入 }
      Writeln('save refused: ', Report.ErrorMessage);
  finally
    Dest.Free;
    Editor.Free;
  end;
end;
加密源被拒绝,这很诚实
当前实现直接拒绝加密源。理由具体,不是防御性措辞:重建树会引入新的字符串对象、也可能引入新的流引用,而 §7.6 要求这些对象用文档密钥加上所属对象的 object number 和 generation 逐个加密。把 /Encrypt trailer 原样带过去、同时追加明文字符串,产出的文件能打开、却恰好在你新键的位置读出一堆垃圾——这比干脆拒绝更糟。还有两条边界值得直说。编辑器工作在源流的快照上,所以编辑器存活期间源不能被修改;它也拒绝把文档 catalog 当树根,因为 catalog 是个碰巧装着树的字典,不是树节点本身。如果你在维护写 /EmbeddedFiles、/Dests、/JavaScript 或 /PageLabels 的 Delphi、C++Builder 或 Lazarus 代码,而且一直在手工补叶子数组,这个树编辑器和它的经校验增量保存随 PDFiumPas Delphi PDFium component 一起交付