溢出检查关闭时,两个 Delphi Integer 操作数相加,2000000000 + 2000000000 的结果是 -294,967,296。当容器解析器从记录头里读出一个偏移和一个长度、把它们相加以判断嵌入 PDF 是否装得进缓冲区时,这条冷知识就不再是冷知识。和回绕成负数,与 Length(Data) 的比较通过,下一行取到的地址在数组末尾之外约两个吉字节处。从更大缓冲区的中间加载 PDF,需要一个永不相加的范围检查,以及一个清楚的答案:文档打开之后字节归谁
本文讲的是已经在内存里、位于某物内部已知偏移处的文档。大到装不进内存的文档是另一个问题,按需从磁盘拉取数据块解决,见 用 PDFium VCL 按需流式加载大型 PDF。最后一节会划清界线
已知偏移处的嵌入 PDF
邮件存储把正文和附件放在同一条记录里;归档容器把清单、几张图和一份 PDF 拼在一起;自定义线路协议在带长度前缀的头部后面帧出一份文档。假设记录 40 MB,PDF 从第 1,182,336 字节开始、长 312 KB。习惯写法调用 Copy(Data, Index, Count) 切出一片,再把这片交给一个又会把它复制进自己缓冲区的加载器。算上容器,同样的 312 KB 存在三份,邮箱扫描对每封邮件都来一遍
PDFium Component 直接寻址这个窗口。TPdf 声明了 LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True),Index 是从零开始的字节位置,Count 是字节长度。方法校验两个数,算出一个指针,转发给指针重载 LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean),后者经 FPDF_LoadMemDocument64 打开文档。整个数组的形态 LoadDocument(const Data: TBytes; Buffered: Boolean) 是对字节范围形态传 0 和 Length(Data) 的一行调用,所以每个 TBytes 加载都走同一套校验
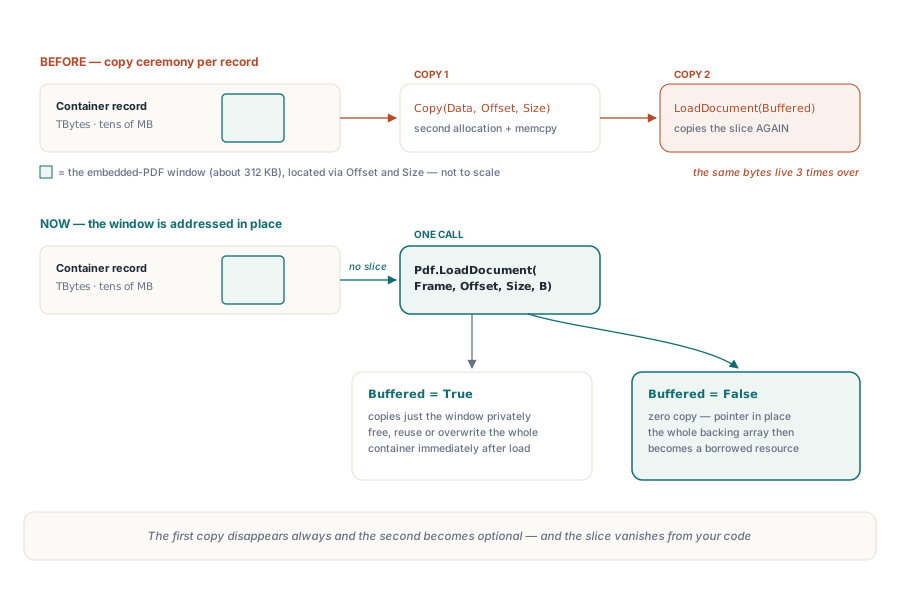
写进代码里,切片就消失了。LocateEmbeddedPdf 代表你自己的容器解析器
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // 整个容器记录,几十兆字节
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // 你的解析器,不属于组件

  Pdf := TPdf.Create(nil);
  try
    // 不做 Copy(Frame, Offset, Size):窗口就地寻址
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered 默认为 True
    Frame := nil;  // 这里没问题:只有 PDF 窗口被复制过
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // 关闭文档
  end;
end;
全局 EnableV8Engine 还是 False 且 PDFium 库尚未加载时,内存加载器会扫描传入字节里的 XFA 标记,找到就打开 EnableV8Engine,让带 V8 的 DLL 得以加载。字节范围调用下,这次扫描只看见窗口。同一记录里别处的清单或第二份文档触发不了它
为什么 Index 加 Count 会让边界检查溢出
因为 Index 和 Count 都是 32 位有符号 Integer,两个较大的正数相加并不保证得到较大的正数。偏移和长度出自文件头时,攻击者或损坏的记录同时控制两者。同一个陷阱也埋在你自己的容器解析器里——那两个数是它先算出来的
// 给你自己的容器解析器的辅助函数(建议用法,不属于组件)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // 错误:Index + Count 按 Integer 求值,可能回绕成负数
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // 正确:拒绝负号,单独约束 Index,然后拿 Count
  // 与余量比较;唯一的算术是一次不会回绕的减法
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;把失败的情形推演一遍。Index = 2000000000、Count = 2000000000 时,真实的和是四十亿,但 32 位有符号算术把它存成 -294,967,296。这个值远低于任何 Length(Data),所以错误的检查通过,@Data[Index] 指向数组之外很远处,还拖着两个吉字节的长度。崩溃是好的结局。坏的是 PDFium 开始解析碰巧驻留在那里的进程内存
正确的顺序永不相加。负值在做任何索引之前先被拒绝。然后 Index 单独对照 Length(Data) 约束,这保证 Length(Data) - Index 是非负 Integer,到这一步才拿 Count 与余量比较。Delphi 默认按短路逻辑求值 and({$B-}),所以后面的每一项只有在前面的都成立时才执行。不要指望 {$Q+} 当安全网:发布构建通常关着溢出检查,开着也只是把一个内存安全漏洞换成一个从校验例程中间逃逸的 EIntOverflow
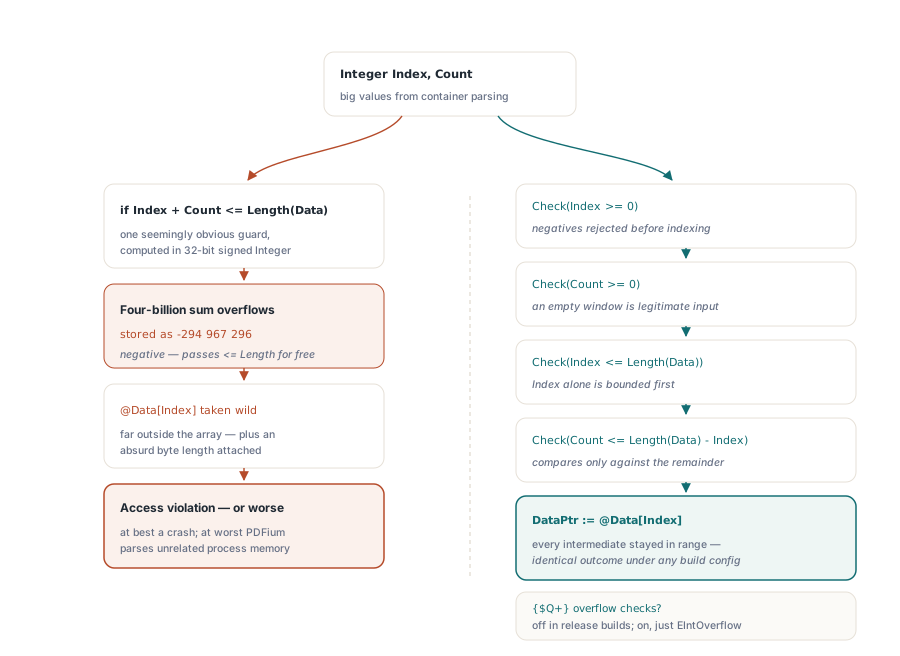
字节范围的 LoadDocument 按同一顺序跑同样四项测试,并抛出点名失败规则的 EPdfError:"PDF byte range index cannot be negative"、"PDF byte range count cannot be negative"、"PDF byte range index exceeds data length" 和 "PDF byte range exceeds data length"。用一个四字节数组就能逐条复现。Index = 5, Count = 0 触发第三条消息,Index = 2, Count = 3 触发第四条,每次拒绝之后 Pdf.Active 仍是 False。跨原生边界对待不可信长度的同一套处理,在 加固 PDFium VCL ABI 与 Delphi 内存安全 中有更全面的覆盖
零长度窗口仍是合法调用
空窗口传 nil 指针,因为对校验能接受的每一个 Index 来说,@Data[Index] 并不都是合法表达式。Index = Length(Data) 配 Count = 0 是缓冲区尾部一个完全良形的空窗口,而空的 TBytes 在 Index = 0 时,数组根本没有第零个元素。两种情况下取地址都会越过末尾读取或解引用 nil 动态数组,而且范围检查开着时,Delphi 会在加载器运行之前就抛出 ERangeError
所以字节范围重载分支处理:Count = 0 产出 nil,其他任何计数产出 @Data[Index]。指针重载只在大小为零时接受 nil,PDFium 随即拒绝打开空缓冲区,调用以携带 PDFium 最后错误文本的普通 EPdfError 结束,PDFium 没报错时是 "Cannot load PDF document"。声称零字节附件的头部得到与任何其他坏输入相同的可捕获异常。不过在你的解析器里拒绝它、把记录号写进消息,在支持日志里仍然更好读
Buffered 决定字节归谁
Buffered 是这里唯一一个后果延续到调用之外的参数。Buffered = True 时,组件在加载前把选中的窗口——而且只有这个窗口——复制进自己的缓冲区。40 MB 的例子里被复制的是 312 KB,容器安然无恙。LoadDocument 一返回,你就可以立即释放、复用或覆写容器
Buffered = False 时,@Data[Index] 直接进 FPDF_LoadMemDocument64,文档开着多久,PDFium 就经这个指针读多久。整个底层 TBytes 变成被借用的。它必须保持存活且不被修改,直到你设 Active := False 或释放 TPdf。要紧的是整个数组而不只是窗口:Delphi 动态数组作为一个整体引用计数,你代码里任何地方丢掉最后一个引用,都会释放 PDFium 还在读的内存。SetLength 同样致命——重新分配可能搬走那块内存
两个 Delphi 细节让它比看上去更容易出错。动态数组没有写时复制,不像字符串,所以 Other := FFrame; Other[0] := 0; 写的正是 PDFium 正在解析的字节。而网络代码为下一帧复用的接收缓冲区,会在文档开着时被覆写。把函数结果直接传进去,比如 Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False),数组只由一个随调用例程消亡的隐藏临时量持有,文档却活着
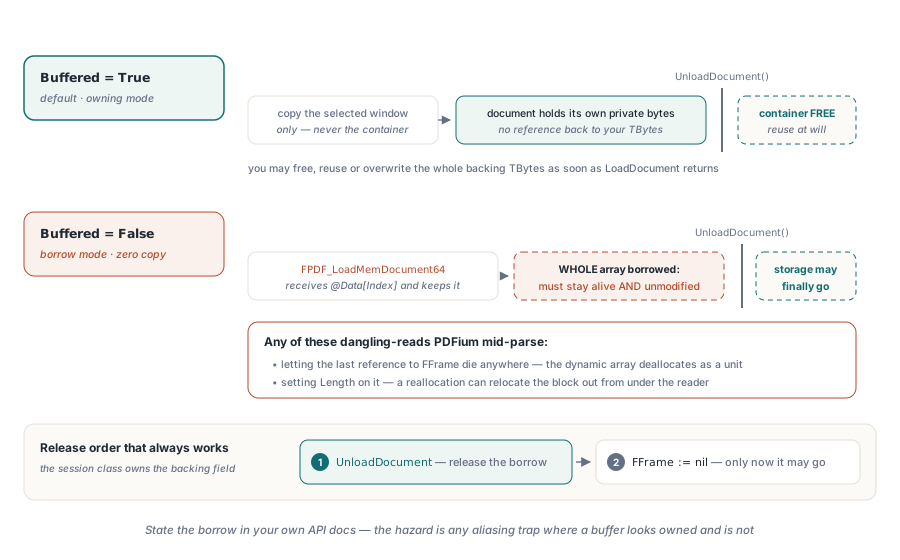
凡是跨线程、躲在可复用缓冲区后面、或活得比加载它的例程久的场景,都用 Buffered = True。额外代价是一次 PDF 自身大小的复制,换来的是调用一返回就能丢掉 40 MB 记录的自由。借用只在一种情况下值得:容器本来就是你要整个会话持有的长命字段,比如查看器在用户翻阅附件时一直开着归档记录。这种情况下,把所有权在一个类里写明白
type
  TFrameSession = class
  private
    FFrame: TBytes;   // FPdf 开着文档期间拥有后备存储
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // 共享数组;从现在起别人不得写入
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // 先关掉上一个窗口
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame 必须活得比文档久
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. 释放借用
  FPdf.Free;
  FFrame := nil;         // 2. 到这才能释放存储
  inherited;
end;
构造函数共享调用方的数组而不是复制它,所以调用方必须停止写入。承诺不了就给构造函数传 Copy(AFrame),回到一次复制——每个会话一次,而不是每次加载一次
检查窗口是否从 %PDF- 开始
偏了几字节的窗口才是隐蔽的失败,因为文档可能照样打开。ISO 32000-1 §7.5.4 把每个交叉引用条目定义为相对文件起点的字节偏移,§7.5.2 把 %PDF- 头放在开头。解析器数错一个前缀、窗口早了八字节,那些偏移就全偏八字节。PDFium 在前 1024 字节里找头并补偿前导垃圾;起晚了或结束早了的窗口可能逼它从找到的对象标记重建交叉引用表。无论哪种,页数看着都对。解析器里的偏移仍然是错的,而这份记录的下一个读取者未必这么好说话
重载 LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) 把这些变得可见。Report.HeaderOffset 是 %PDF- 在窗口前 1024 字节内被找到的位置,没找到是 -1。Report.UsedRecovery 为 True 表示 PDFium 没有接受交叉引用表为有效。报告里的所有偏移都从窗口第一个字节计,不从容器计。Count 太短会切掉结尾的 %%EOF,而 TPdfLoadOptions.Default(plmStrict) 打开 RequireFinalEndOfFileMarker,严格模式直接拒绝那种窗口
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning 是你自己的日志例程
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
这些字段背后的审计有一项对借用加载要紧的代价。窗口装得进 Options.AuditByteLimit(默认 256 MB)时,审计读取窗口的一份临时副本,所以 Buffered = False 配报告在加载期间就不再零复制。把 AuditByteLimit 设为 0 跳过审计和复制,HeaderOffset 留在 -1。开发容器解析器期间、以及对着新的记录来源时跑带审计的形态;偏移可信之后换回普通重载。报告的其余部分在 用 PDFium 加载报告捕获 PDF 加载失败 中覆盖
字节范围什么时候是错误的工具
字节范围重载假定整个容器已在内存里,而 Count 是 Integer,一个窗口超不过 MaxInt 字节。磁盘上的 6 GB 归档、或一条无法回退的套接字,都不符合这个形态,而为了在里面寻址一个窗口就把所有东西读进 TBytes,违背了这个重载的本意。这些场景用 LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) 让 PDFium 按需从可定位流拉块。你自己写一个小的 TStream 后代,在每个 Seek 上加上 PDF 的起始偏移,嵌入文档就像从位置零开始一样呈现,按需流式加载一文 展示了做法
另一种不匹配是内容还不是普通 PDF。嵌入字节被压缩、被容器加密、或包着别的编码时,转换后的副本不可避免,把新数组用默认的 Buffered = True 加载就是直截了当的答案。字节范围只在一种形态下有回报:连续、未经修改的 PDF 字节,已经驻留内存,偏移经你的解析器不加法验证过
字节范围调用与文件、流、裸指针和按需加载并列在同一个 TPdf 组件里。PDFium Component 产品页 列出支持的 Delphi 与 C++Builder 版本、授权选项和其余加载 API