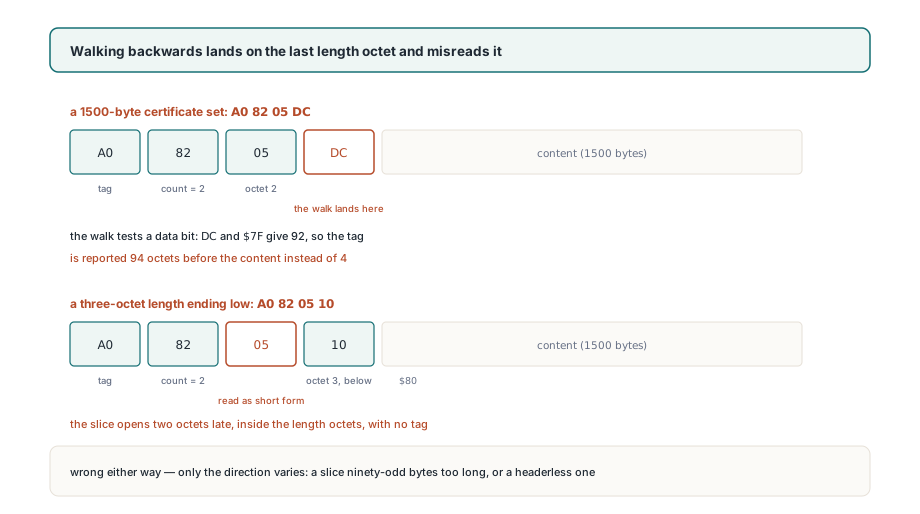
四个字节 A0 82 05 DC 打开一个携带 1500 字节内容的上下文相关 [0] 元素。从左往右读毫无歧义:标签 A0,首长度字节 82 宣告后面还有两个,然后 05 DC。从右往左读、从第一个内容字节起步,碰到的第一个字节是 DC。它最高位置 1、低 7 位说是 92,于是信任它的辅助函数会报告标签在内容之前 94 字节处。真实距离是 4
没有人故意倒着走。它是这么发生的:多数 DER 阅读器交回每个元素的内容偏移和长度——往下钻正需要这个——而原样拷贝一个兄弟元素要的是它标签的偏移。从内容偏移往回减看着是两行代码的事,只要每个长度都装得进单个字节就一直正确。真实证书集的长度从来装不进一个
签名时间戳对已签名 CMS 做了什么
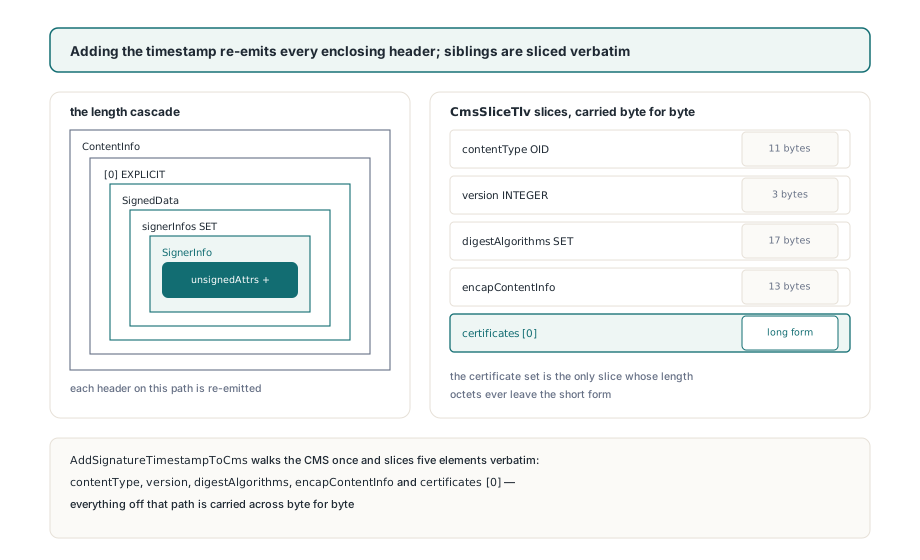
加 PAdES B-T 时间戳,CMS 的每层外覆头部都得重编码,而五个兄弟元素必须逐字节原样带过来。ETSI EN 319 122-1 第 5.3 条在 OID 1.2.840.113549.1.9.16.2.14 下定义的 signature-time-stamp 属性,住在 RFC 5652 第 5.3 条 SignerInfo 的 unsignedAttrs 里,其中的 RFC 3161 令牌是对签名值算的。所以令牌从 TSA 到手时,CMS 已经构建完、也签完了。多出来的一个属性撑长 SignerInfo,进而撑长 signerInfos SET,然后 SignedData、[0] EXPLICIT 包装,最后是外层 ContentInfo
在 PDFium Component 里,这条序列是 FPdfCms.pas 和 FPdfTsa.pas 里的三个导出调用。TPadesSignOptions.Level 为 plB_T 或更高且设了 TsaUrl 时,SignPadesBytes 替你跑完;要求 B-T 等级却给了空 TsaUrl 时,它抛 EPadesCrypto,而不是退而写一个普通 B-B 签名。自己用 BuildSignedData 构建 CMS 的话,链条长这样
// CmsDer 装 BuildSignedData 返回的 ContentInfo。
// Options.Level >= plB_T 时 SignPadesBytes 执行同样三步
var
  SigValue: TBytes;
  Ts: TPadesTimestamp;
begin
  if not ExtractSignatureValue(CmsDer, SigValue) then
    raise Exception.Create('CMS carries no signature value');
  // TSA 的 messageImprint 对签名值字节计算
  Ts:= RequestTimestamp(TsaUrl, SigValue, Nonce);
  // 重编码 SignerInfo 到 ContentInfo,兄弟元素原样拷贝
  AddSignatureTimestampToCms(CmsDer, Ts.TokenDer);
end;
AddSignatureTimestampToCms 原样带过五个元素:contentType OID、SignedData 版本 INTEGER、digestAlgorithms SET、encapContentInfo SEQUENCE,以及(存在时)certificates [0] 集。在 BuildSignedData 以 SHA-256 产出的 CMS 里,其中四个很小:OID 11 字节、版本 3 字节、摘要算法集 17 字节、分离式 encapContentInfo 13 字节。证书集装着签名者证书加上你传入的每张链证书。真实的 X.509 证书有几百字节。这是唯一一段长度字节必然用长形式的切片
为什么 DER 长度字节不能倒着走?
长度字节的个数存在第一个长度字节里,倒着走先遇到最后一个。X.690 第 8.1.3.4 条定义短形式:一个字节,第 8 位清零,第 7 到 1 位装 0 到 127 的长度。第 8.1.3.5 条定义长形式:首字节第 8 位置 1,第 7 到 1 位数出后续有几个字节、以无符号大端整数装长度。没有任何东西标记某个字节是“后续”字节。它的第 8 位和其他 7 位一样是数值位。所以检测 Buf[ContentOffs- 1] 最高位的辅助函数,是在检测数据、然后把数据当计数读
// 只拿到内容偏移时的诱人写法。别把它发上线
function NaiveHeaderStart(const Buf: TBytes; ContentOffs: Integer): Integer;
var
  P, LenByte: Integer;
begin
  P:= ContentOffs- 1;            // 落在最后一个长度字节上
  if P< 0 then
    Exit(ContentOffs);
  LenByte:= Buf[P];
  if (LenByte and $80)= 0 then   // 只对第一个字节有意义
    Result:= P- 1
  else
    Result:= P- (LenByte and $7F)- 1;
end;

// A0 82 05 DC(1500 字节):Buf[ContentOffs- 1]= $DC,$DC and $7F= 92
//   Result= ContentOffs- 94,而标签在 ContentOffs- 4
// A0 82 05 10(1296 字节):$10 第 8 位为 0,被当短形式读
//   Result= ContentOffs- 2,指向长度字节里的 05
两个失败方向都会在寻常尺寸上出现。1500 字节的证书集头部以 DC 结尾,辅助函数把切片起点提前了 90 字节。1296 字节的集以 10 结尾,辅助函数把它当成短形式长度,切片晚两个字节才开始、压根没有标签。某条链落进哪一种,只取决于总长度的低字节
提前的情况还可能冲出缓冲区头部。按 BuildSignedData 的排布方式、每层外覆长度占两个字节时,证书集的内容从 60 字节处开始:ContentInfo 头 4 字节、OID 11 字节、[0] 和 SignedData 头各 4 字节,然后小兄弟 3、17、13 字节,再加证书集头 4 字节。60 减 94,辅助函数返回 -34。它唯一的守卫设在 ContentOffs- 1 上,负值直接进了拷贝
X.690 第 10.1 条钉死了什么
DER 把长度编码变成关于长度的纯函数。X.690 第 10.1 条把 DER 限定为定长形式、并要求最少字节数,砍掉了 BER 允许的两处自由:不定长形式,以及用前导零字节填充的长形式长度。在这条规则下,低于 128 的内容长度必然恰好一个长度字节。其他任何长度用一个首字节,外加与数值有效字节数恰好相等的后续字节。128 得 81 80;256 时头部长成 82 01 00,65536 需要 83 01 00 00。手里已有内容长度的代码,不读缓冲区一个字节就能算出头部尺寸
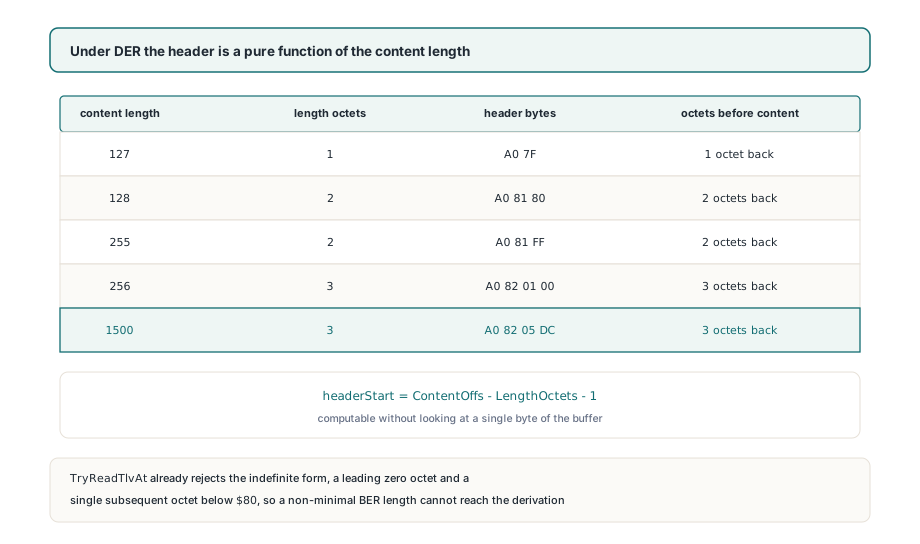
推导再好,也得输入真是 DER 才成立。TDerReader.TryReadTlvAt 在任何切片发生之前强制这一点。它拒绝 $80 的首长度字节(不定长形式)、首个后续字节为零的长形式长度、低于 $80 本该用短形式的单个后续字节,以及超过四个的后续字节。ReadTlv 建在 TryReadTlvAt 之上,所以 AddSignatureTimestampToCms 走到的每个元素都已过检。BER 式填充长度永远到不了算术那一步
AddSignatureTimestampToCms 内部,每个兄弟元素的标签偏移就是这样从内容偏移和内容长度推导的。推导出的起点落到缓冲区开头之前——意味着这些偏移根本不配套——过程就抛出消息为 CMS: TLV header precedes the buffer start 的异常,一个 CMS 都不产。仍能解析的畸形重建,比偏移失去一致那一刻的异常难查得多
推导还带一个假设:标识符只占一个字节。X.690 允许标签号 31 及以上用多字节标识符,TryReadTlvAt 也解析它们。CMS SignedData 从不用多字节标识符——它的标签是通用类 SEQUENCE、SET、INTEGER、OID,加上上下文相关的 [0] 和 [1]——所以时间戳重建碰到的每个元素都满足这个假设
在自己的 DER 代码里拷贝兄弟元素
直接对 TDerReader 写代码的话,推导可以整个跳过。PeekTlv 和 ReadNextTlv 填一个 TDerTlv 记录,其 Offset 已指向标签、HeaderLength 是实测的标签加长度字节尺寸,EncodedBytes 返回从 Offset 到 NextOffset 的元素。这条路还能应付多字节标识符——多少长度算术都救不回的那种。ReadTlv 的四出参形式往下钻方便。但它只报内容侧,所以要内容用它,要整个元素用记录形式
// SignedData 的每个子元素都是完整 TLV:标签、长度字节、内容。
// TDerTlv.Offset 指向标签,不涉及任何头部算术
function SignedDataChildren(const CmsDer: TBytes): TDerByteArrays;
var
  Root, Ci, Explicit0, Sd: TDerReader;
  Tlv: TDerTlv;
begin
  Result:= nil;
  Root.Initialize(CmsDer);
  if not Root.ReadNextTlv(Tlv) or not Root.EnterConstructed(Tlv, Ci) then
    raise Exception.Create('ContentInfo SEQUENCE expected');
  if not Ci.SkipTlv then                            // contentType OID
    raise Exception.Create('contentType OID expected');
  if not Ci.ReadNextTlv(Tlv) or not Ci.EnterConstructed(Tlv, Explicit0) then
    raise Exception.Create('[0] EXPLICIT content expected');
  if not Explicit0.ReadNextTlv(Tlv) or not Explicit0.EnterConstructed(Tlv, Sd) then
    raise Exception.Create('SignedData SEQUENCE expected');
  while not Sd.AtEnd do
  begin
    if not Sd.ReadNextTlv(Tlv) then
      raise Exception.Create('SignedData child malformed');
    SetLength(Result, Length(Result)+ 1);
    Result[High(Result)]:= Sd.EncodedBytes(Tlv);   // 例如 A0 82 05 DC……
  end;
end;
别的 API 只给你内容偏移和长度时,正向推导很短。下一节连着边界检查一起展示的 DerHeaderStart 是你自己的代码;它复刻第 10.1 条的规则,对不可能配套的偏移返回 -1,调用方因此拿到一个可以拒绝的值,而不是一个看着挺像样的起始字节
为什么短测试证书把错误藏起来?
小占位证书让证书集留在短形式里,倒着走恰恰在这种情形下正确。32 字节的集编码为 A0 20,64 字节的为 A0 40。从内容往回走落在那唯一一个长度字节上,它最高位是 0——因为它是第一个也是唯一一个。答案对,理由错。用这么小的证书搭的时间戳测试,可以重新解析结果、找到属性、报出 B-T,却从头到尾没让一个真实尺寸的证书集过过这条切片
任何依赖长度如何编码的代码路径,都需要跨过编码边界的测试输入。对 DER 来说就是 128 字节及以上的内容——逼出长形式——和 256 字节及以上的内容——逼出第二个后续字节。下面的检查在两个边界上、以及开头那个 1500 字节的案例上,把 DerHeaderStart 与阅读器解析时实测的头部对照。signedAttrs 里未排序的 SET OF能溜过同源往返,也是同一个结构性原因:测试只喂错误代码和正确代码恰好给出一致结果的输入
// 给只报内容偏移和长度的 API 用的你自己的辅助函数。
// 假设标识符占一个字节,CMS SignedData 里每个标签都成立
function DerHeaderStart(ContentOffs, ContentLen: Integer): Integer;
var
  LengthOctets, Remaining: Integer;
begin
  LengthOctets:= 1;                  // 短形式,X.690 8.1.3.4
  if ContentLen>= 128 then
  begin
    Remaining:= ContentLen;          // 长形式,X.690 8.1.3.5
    while Remaining> 0 do
    begin
      Inc(LengthOctets);             // 每个有效字节一个
      Remaining:= Remaining shr 8;
    end;
  end;
  Result:= ContentOffs- LengthOctets- 1;
  if Result< 0 then
    Result:= -1;                     // 偏移不配套:让调用方去抛
end;

// 边界检查,写成你自己的测试代码:推导出的标签偏移
// 必须等于 TDerReader 解析头部时实测的偏移
procedure CheckHeaderDerivation;
const
  Lens: array[0..6] of Integer= (127, 128, 255, 256, 1500, 65535, 65536);
var
  W: TDerWriter;
  R: TDerReader;
  Tlv: TDerTlv;
  Content: TBytes;
  I: Integer;
begin
  W:= TDerWriter.Create;
  try
    for I:= Low(Lens) to High(Lens) do
    begin
      SetLength(Content, Lens[I]);
      R.Initialize(W.Wrap($A0, Content));   // A0 7F / A0 81 80 / A0 82 05 DC……
      W.Clear;
      if not R.PeekTlv(Tlv) then
        raise Exception.CreateFmt('unreadable TLV for %d bytes', [Lens[I]]);
      if DerHeaderStart(Tlv.ContentOffset, Tlv.ContentLength)<> Tlv.Offset then
        raise Exception.CreateFmt('header start wrong for %d bytes', [Lens[I]]);
    end;
  finally
    W.Free;
  end;
end;
同一条边界经导出函数也能端到端够到。给 BuildSignedData 递一组链证书,让合并尺寸把证书集分别压到 128 和 256 字节的上下两侧,对每个结果跑 AddSignatureTimestampToCms,再用 SignedDataChildren 走一遍输出,把证书集元素与加时间戳之前 CMS 里的那个逐字节比对
AddSignatureTimestampToCms 接受什么
AddSignatureTimestampToCms 是为 BuildSignedData 产出的 CMS 写的:一个 SignerInfo、可选的 certificates [0] 集、没有 crls [1]、也还没有 unsignedAttrs。喂它一个装着多个 SignerInfo 的 signerInfos SET,它会抛异常,而不是留下第一个签名者、扔掉其余。带 crls [1] 集的 CMS 停在 CMS: signerInfos SET expected 异常上,因为证书之后的元素不是这条走查要找的 SET。两种拒绝都发生在任何东西写回 CmsDer 之前
新的 unsignedAttrs 恰好装一个属性,所以 X.690 第 11.6 条的 SET OF 排序规则不用排序即满足。SignerInfo 的签名部分——从版本到签名 OCTET STRING——整块拷贝,意味着重算 signedAttrs 摘要的验证器在令牌加入前后看到相同字节。验证器仍然拒收文档时,原因通常在别处,这份 PAdES 拒收原因清单有覆盖。令牌随时间带来的好处、以及 B-LT 和 B-LTA 如何在它之上构建,见RFC 3161 时间戳与 DSS 走查
FPdfAsn1.pas 里的 DER 读写器、FPdfCms.pas 里的 CMS 构建器和时间戳步骤,都是随 PDFium Component for Delphi 交付的 Pascal 源码。重建的 SignedData 在验证器里解析失败时,你可以单步走进切出每个元素的那段代码,对着它引用的 X.690 条款核对