同一份 Object Pascal 源码在 Delphi 和 FPC/Lazarus 下会有四种不同的表现,它们反复咬伤 PDFium Component 的代码:FPC 可能在一次 in 成员测试读完函数结果记录的临时变量之前就把它释放掉,dcc32 出厂时关着范围检查、于是越界的数组下标会悄无声息地读到垃圾,只有 Delphi 13 允许把一个匿名的 array of Byte 不加转型地赋给 TBytes,而 Delphi 的 AnsiString 拼接会通过一次隐藏的代码页往返毁掉 $80 及以上的字节。每一条都能造出一套在一个编译器上全绿、在另一个上全红的测试,或者更糟——悄悄地错着
如果你是第一次搭建双编译器项目,Lazarus 与 FPC 查看器实战讲的是顺利路径:包、搜索路径,以及把一个渲染窗口摆到屏幕上。本文恰恰相反,它不是教程。它是我们在顺利路径已经跑通之后撞上的那份清单——那时 CI 在 FPC 下是绿的,在 Delphi 下也是绿的,然后一处在这边通过的改动在那边炸了。下面每一个陷阱都来自 PDFiumPas 测试套件或其演示中的真实故障,提交级别的取证被浓缩成一个最小复现、根因,以及我们最终统一采用的修法
为什么一个集合在 FPC 下读回来是空的,Delphi 下却不是?
一句话版本:FPC 可能在一个读取函数结果记录字段的表达式还没读完之前,就终结那个持有结果的临时变量,所以 X in Func().Issues 有可能在一个已被释放的集合上做成员测试,而等价的 Delphi 表达式却是好的。我们的 PDF/E 合规测试在第一版里就撞上了这个。校验器返回一条记录,它的 Issues 字段是一个违规标志的集合,而断言把调用内联了进去
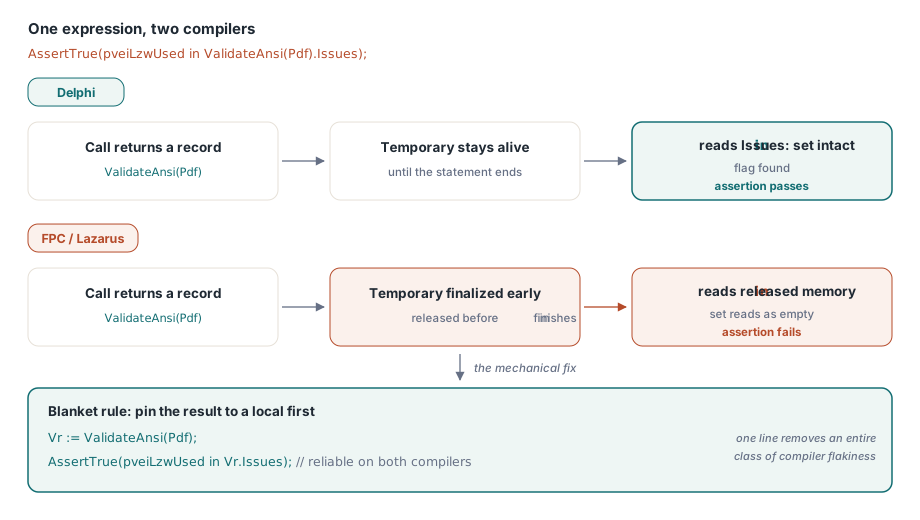
// 在 FPC 下不可靠:函数结果记录的临时变量
// 可能在 'in' 测试读取 Issues 之前就被释放
AssertTrue(pveiLzwUsed in ValidateAnsi(Pdf).Issues);

// 两个编译器上都可靠:先把结果钉到一个局部变量上
var
  Vr: TPdfEValidationResult;
begin
  Vr := ValidateAnsi(Pdf);
  AssertTrue(pveiLzwUsed in Vr.Issues);
end;
内联的那种写法在 FPC 下把集合读成了空的,于是每一条期待某个标志的断言都失败了,而完全相同的 Delphi 构建却通过。根因在于两个编译器对更大表达式内部函数结果临时变量的生命周期管理方式不同:Delphi 让临时变量活到语句结束,而 FPC 对记录临时变量的释放可能和仍在读取它的集合成员运算符抢跑。我们其实早就把同样的行为记录过一次,写在 PDF/A 测试单元里 FlagPresent 辅助函数的注释上,然后在从头写新测试时又把这个缺陷重新引了回来——这足以说明那种坏写法看起来有多自然。修法是机械的,值得当作一条通行规则采纳:绝不要把字段访问或集合测试直接链在一个返回记录的函数调用上;先把结果赋给一个局部变量,再读字段。它只花一行,却消掉了一整类依赖编译器的不稳定
为什么 Delphi 接受一个 FPC 拒绝编译的数组下标?
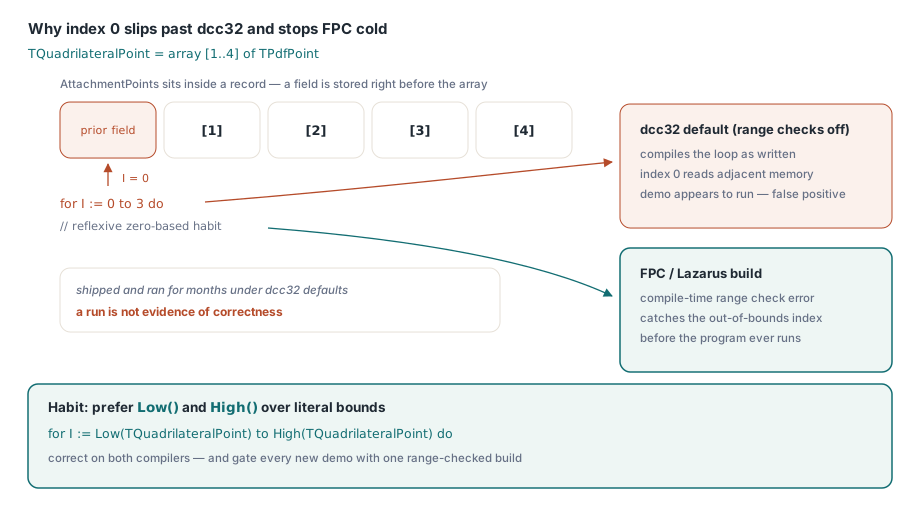
一句话版本:dcc32 会把一个越界下标编译进定长数组,并在默认关闭范围检查的情况下于运行期读写相邻内存而不报任何错,而 FPC 在编译期就拒绝同一个下标。PDFium Component 把四边形点声明为一个 1 起始的数组,TQuadrilateralPoint = array [1..4] of TPdfPoint,与 PDF 的 QuadPoints 条目通常的编号方式一致。一个用条件反射式 0 起始循环去填它的演示,在 Delphi 下好好地跑了好几个月
var
  I: Integer;
begin
  for I := 0 to 3 do                       // 错:这个数组是 [1..4]
    Data.AttachmentPoints[I] := Corner[I]; // dcc32 默认:能编译,下标 0
                                           // 悄悄碰到相邻内存
                                           // FPC:编译期范围检查错误
  for I := Low(TQuadrilateralPoint) to High(TQuadrilateralPoint) do
    Data.AttachmentPoints[I] := Corner[I - 1];  // 两个编译器上都正确
end;
那次 Delphi 构建是一个假阳性:范围检查关着——这正是 dcc32 的默认值——下标 0 落到了记录里数组前面的那个字段上,于是演示看起来跑得好好的。把同一个演示移植到 Lazarus,FPC 立刻给出一个编译期范围检查错误,而修好下标之后又暴露出库的注解路径里第二个更深的缺陷——那些垃圾读一直掩盖着它,也就是四边形点注解一文里剖析的那个。那次事故给出两条教训。第一,只要数组类型不是天生 0 起始的,就优先用 Low() 和 High() 而不是字面边界。第二,把一次 FPC 编译,或者至少一次开着 {$R+} 的 Delphi 构建,当作任何新演示或新测试首次运行的强制关卡:dcc32 的默认设置不会告诉你这类缺陷,而一个能跑起来的程序并不能证明它是对的
只有 Delphi 13 才接受的那个 TBytes 赋值
一句话版本:把一个声明为匿名 array of Byte 的字段赋给一个 TBytes 变量,在 Delphi 13(编译器版本 37.0)上能编译,但在 Delphi 12 Athens 及更早的每一个版本上都会失败并报 E2010 Incompatible types: 'TArray<Byte>' and 'Dynamic array'。这一条与其说是 Delphi 对 FPC 的分歧,不如说是 Delphi 与它自己过去的分歧,但它咬同一份多编译器代码库的方式是一样的:最新的编译器悄悄接受了一个别的所有编译器都拒绝的写法
type
  TValidator = class
  private
    FBuffer: array of Byte;   // 匿名动态数组类型
  end;

var
  OrigBytes: TBytes;
begin
  OrigBytes := FBuffer;          // 仅 Delphi 13;在 Delphi 12 Athens
                                 // 及更早版本上报 E2010
  OrigBytes := TBytes(FBuffer);  // 到处都能编译;字节布局相同,
                                 // 是安全的强制转型
end;
我们就是这样把它发出去的,写在一个校验例程里,在本地的 Delphi 13 上开发和测试,那里隐式转换被默默接受了。全源码安装包服务着大量使用 Delphi 12 及更早版本的用户,对他们来说这个单元根本编译不过去。结构性的修法要么是上面展示的强制转型——它是安全的,因为匿名的 array of Byte 与 TBytes 共享完全相同的动态数组布局;要么更好,一开始就把字段声明成 TBytes 这样的具名类型,让转换根本不会出现。流程上的修法更要紧:一个能在你最新工具链上编译的写法,对你用户实际使用的那些老编译器什么也证明不了,而这一类回归在你对每个受支持版本都构建一遍之前是不可见的。我们的发布脚本现在会把库在整个编译器矩阵上都编译一遍,正是因为一次本地的 37.0 构建抓不住一处只有 13 才有的宽容
在中文 Windows 机器上消失的那个 AnsiString 字节
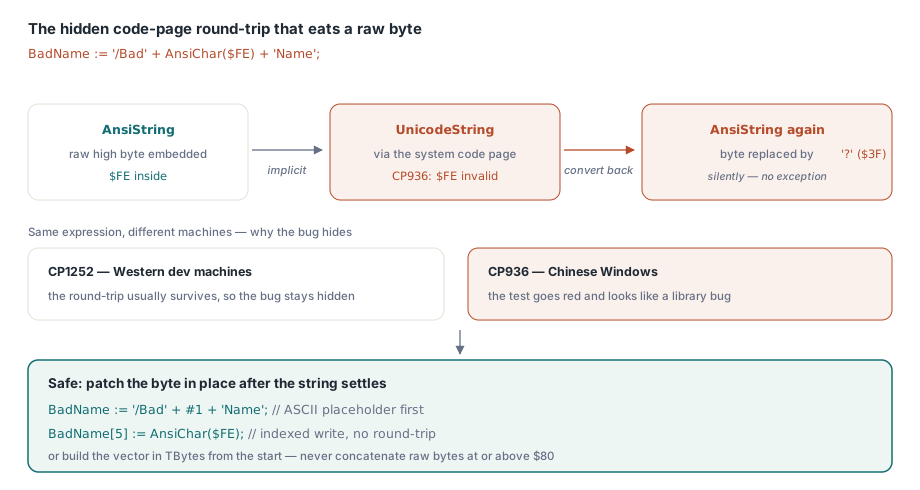
一句话版本:用 + 把一个 $80 及以上的原始字节拼进 AnsiString,在 Delphi 下可能悄悄把那个字节换成 ?($3F),因为这个表达式会经系统代码页做一次隐式的 AnsiString 到 UnicodeString 再回到 AnsiString 的往返。我们是通过一个 PDF/A 测试发现它的,那个测试构造了一个包含孤立 $FE 字节的名字——它绝不可能是合法的 UTF-8 前导字节——用来验证校验器会按 ISO 19005-2 第 6.1.8 条标出不是有效 UTF-8 的名字
var
  BadName: AnsiString;
begin
  // 在系统代码页为多字节的 Delphi 上(我们在 CP936 上观察到),
  // 这次拼接会经 UnicodeString 往返,而 $FE 不是合法的 CP936
  // 序列,于是回来的是 '?'($3F)
  BadName := '/Bad' + AnsiChar($FE) + 'Name';

  // 安全做法:先用一个 ASCII 占位符构建,再就地修补该字节;
  // 对已经定型的 AnsiString 做下标赋值不会触发往返
  BadName := '/Bad' + #1 + 'Name';
  BadName[5] := AnsiChar($FE);
end;
在一台跑着代码页 936 的中文 Windows 系统上,拼出来的字符串里根本就没有 $FE,所以库正确地什么也没报,而测试变红了,看起来却像是库的缺陷。库从来没错:一个喂进真正含有 $FE 字节的 PDF 的 FPC 测试载体,拿到的正是预期的标志。损坏发生在 Delphi 测试可执行文件内部、字符串表达式求值的过程中,因为 Delphi 以 Unicode 为先的字符串模型会把混合的 AnsiString 表达式经 UnicodeString 转换一遍,而 $FE 在 CP936 中不是合法的前导字节,于是这次往返把它替换掉了。这里要对边界诚实:在 CP1252 这类单字节西文代码页上,同一个表达式通常安然无恙,这恰恰是为什么这个缺陷会藏在大多数开发机器上,只在东亚系统或本地化的 CI 执行机上现身。我们采纳的规则是:绝不用 AnsiString 拼接来构造含有 $80 及以上字节的二进制测试向量;要么像上面那样在字符串定型之后就地修补字节,要么一开始就用 TBytes 构造这个向量
一套双编译器工作流默认该检查什么
四个陷阱,一个规律:每个编译器告诉你的是你缺陷中不同的那一部分。FPC 的编译期范围分析抓住了一个 dcc32 悄悄跑了好几个月的越界下标,而 dcc32 的 Unicode 字符串模型暴露出一处代码页依赖,那是纯面向字节的 FPC 构建永远触发不了的。实际后果是:任何一条绿色流水线单独看都不够。交叉编译不只是一个可移植性的勾选框,它是把第二个静态分析器和第二套运行期模型施加到同一份源码上,与 ABI 与内存安全加固一文里那些防御性边界检查是同一种精神
这些事故沉淀下来的常备规则短到可以背下来。读字段之前先把函数结果记录钉到一个局部变量上。用 Low() 和 High() 遍历定长数组,并且在信任任何新演示之前至少跑一次开了范围检查的构建或一次 FPC 构建。对匿名动态数组字段显式转型,或者干脆用具名类型声明它们,并在发布前把整个编译器矩阵都构建一遍。彻底别把原始高位字节放进 AnsiString 拼接。这些一旦成了习惯,代价都小到量不出来,而每一条都堵上了一种单编译器工作流在结构上就看不见的失败形态
这四个问题都是在维护 PDFium Component 的过程中发现并修掉的,它为 Delphi、C++Builder 和 FPC/Lazarus 提供同一份 Object Pascal 源码,并在这些工具链的每一个上跑合规与回归套件,所以本文里的陷阱是由测试守着的,而不是靠记性