同一份发票 PDF 在 Windows 和手机上打开,换行、字体和徽标都落在相同的位置。PDF 文件就是一组带编号的对象,外加一张字节偏移索引,而阅读器——比如 PDFium Component 内部的 PDFium 引擎——从文件末尾打开它:startxref、xref 表、catalog、页面树、内容流,然后是像素
那么 PDF 文件到底是什么,为什么它在任何地方看起来都一样?Word 和 RTF 文档存放文本和样式,把排版留给打开它的那台机器,于是缺一个字体或换一个打印机驱动就会重排页面。PDF 存的是成品。每个字形和线条在以磅计的坐标空间里都有绝对位置,字体程序随文件一起走,图像自带颜色数据和压缩滤镜。查看时没有任何排版运算,这就是任何操作系统上的合规渲染器都能画出同一页的原因。该格式 1993 年随 Acrobat 以 PDF 1.0 面世,建立在 PostScript 成像模型之上,此后每个修订版都补上了下文所述机制的一部分:
- PDF 1.1 到 1.4 带来了加密、交互式表单、带逻辑结构的数字签名和透明度
- PDF 1.5 加入对象流和交叉引用流;PDF 1.6 加入 AES 加密
- PDF 1.7 成为 ISO 32000-1:2008,PDF 2.0 成为 ISO 32000-2:2017,2020 年修订
- PDF/A(ISO 19005)、PDF/X(ISO 15930)和 PDF/UA(ISO 14289)分别为归档、印刷生产和无障碍对这一基础作出限制
阅读器打开 PDF 文件时会发生什么?
打开 PDF 是一串查找,从文件最后几个字节开始,到一张位图结束。这条链上几乎每一环都是一个字典——ISO 32000-1 §7.3 基本对象类型之一——字典之间用 7 0 R(对象 7、生成 0)这样的间接引用相互指向。文件因此表现得像一张对象图,而不是一串页面。头部、主体、交叉引用表和尾部的布局见 PDF 文件结构总览,逐行注释的最小 PDF 则展示了 obj、endobj 和 stream 在文本编辑器里的样子。每个阅读器都按下面的顺序走
- 定位到文件末尾,读
startxref关键字之后写的字节偏移 - 加载该偏移处的交叉引用数据,它把每个对象编号映射到文件中的位置
- 读 trailer,沿
/Root走到文档 catalog - 沿 catalog 的
/Pages条目下行页面树,抵达请求的页面对象 - 解码页面的内容流,按顺序解释其中的操作符
- 经由
/Resources解析这些操作符点名的字体、图像和 form XObject - 按设备分辨率把路径、字形轮廓和图像栅格化成像素
第一步:startxref 与交叉引用表
阅读器从不从顶部扫描 PDF。格式良好的文件以关键字 startxref、一个形如 48211 的十进制数和 %%EOF 收尾,那个数就是交叉引用数据的字节偏移。朴素的向后搜索找 xref 会停在 startxref 内部,所以要搜完整关键字。经典表的条目定宽(§7.5.4),阅读器因此能直接跳到任何对象编号的条目而不必解析其他条目;每个条目的字节布局见 结构总览。表后的 trailer 列出 /Size、/Root,以及可选的 /Encrypt、/ID 和 /Prev
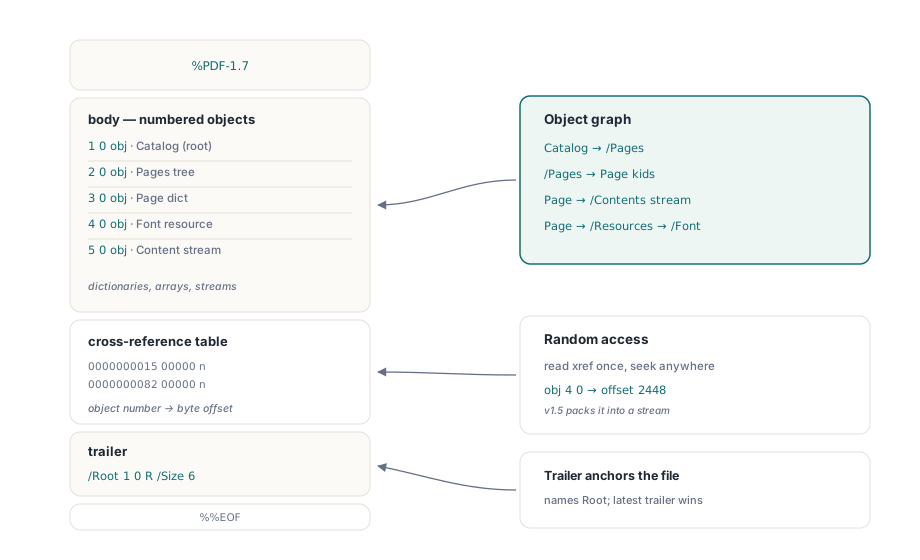
每个条目都是绝对字节位置,所以任何移动字节的操作——比如编辑器改写行尾——都会让索引指错地方。带修复通道的阅读器扫描 obj 关键字重建索引;没有修复通道的直接拒收文件,这就是同一份损坏的 PDF 在一个查看器里能开、在另一个里打不开的原因。startxref 偏移处是什么,就能判断你遇到的是哪种情况:xref 关键字是经典表,N 0 obj 头部是 PDF 1.5 交叉引用流,其他任何东西都是过期偏移。下面的辅助函数是你自己的代码,只依赖朴素的 RTL 流
uses
  System.SysUtils, System.Classes;

// 你自己的辅助例程:Offset 是 startxref 关键字之后写的数字
// 判定阅读器在该位置会找到什么
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
交叉引用流(§7.5.8)是一个压缩对象,带 /Type /XRef、给出每列字节宽度的 /W 数组,以及二进制行——每行要么指向字节偏移,要么指向对象流(§7.5.7)内部。trailer 的键搬进它的字典,文件里根本没有 trailer 关键字。在 THotPDF 上设置了 UseXRefStream 时,HotPDF 写出这种形式。对脱离你掌控的文件——比如邮件附件或送印刷厂的成品——经典表仍是更稳妥的选择,因为 PDF 1.5 之前的阅读器只会解析它。归档场景 PDF/A-1 一锤定音:ISO 19005-1 建立在 PDF 1.4 之上,其 §6.1.4 规定不得使用交叉引用流,所以只要激活 PDF/A-1 档型,HotPDF 就写经典表
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
从 /Root 到正确的页面:catalog 与页面树
trailer 的 /Root 指向文档 catalog,catalog 的 /Pages 指向页面树的根。每个中间 /Pages 节点都带着其下叶子页数的 /Count,找第 5,000 页的阅读器边下行边扣减计数,整棵子树未经打开就跳过。ISO 32000-1 §7.7.3 并不要求平衡树;一个带 10,000 条目的 /Kids 数组是合法的,只是搜起来慢。只读叶子的代码会踩进一个陷阱。/Resources、/MediaBox、/CropBox 和 /Rotate 是可继承的(§7.7.3.4),没有自带 /MediaBox 的页面依然有效,因为值住在某个祖先上
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
Media box 为页面上绘制的一切划定坐标空间:原点在左下,Y 向上,一个单位等于 1/72 英寸,除非 PDF 1.6 的 /UserUnit 把它缩放。按编号请求页面时,PDFium Component 替你走完整个下行。TPdf.PageMetrics 返回以磅计的页面尺寸,继承的框已经解析完毕,还带上页面旋转,所以下面的清单对叶子页面不带框的文件也能报出正确尺寸
uses
  System.SysUtils, PDFium;

// 打印页数和每一页以磅计的尺寸
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // 解析 xref 数据、trailer 和 catalog
    if not Pdf.Active then        // 加载失败时 Active 保持 False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // 从 1 起数;经页面树加载页面
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
PDF 如何在屏幕上画出一页?
页面的可见内容是一段小程序:一条或多条内容流里的后缀操作符,在阅读器跑完 /Filter 点名的解码器(最常见是 /FlateDecode)之后按顺序解释。BT 开启文本对象,Tf 选中字体资源和字号,Td 移动文本位置,Tj 画出字符串,ET 关闭对象。路径用 m、l、c 和 re 构建,再用 f 填充或用 S 描边。图形状态(§8.4)保存这些操作符隐式读取的东西,比如变换矩阵、颜色和裁剪路径。q 压入一份拷贝,Q 弹出它,所以这对操作符内部设置的变换不会泄漏到后面的内容里
q
1 0 0 1 72 700 cm     % 把原点移到 (72, 700)
BT
  /F1 12 Tf           % 字体资源 F1,12 磅
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % 描边颜色,作用域由 q/Q 圈定
0 -6 m 140 -6 l S
Q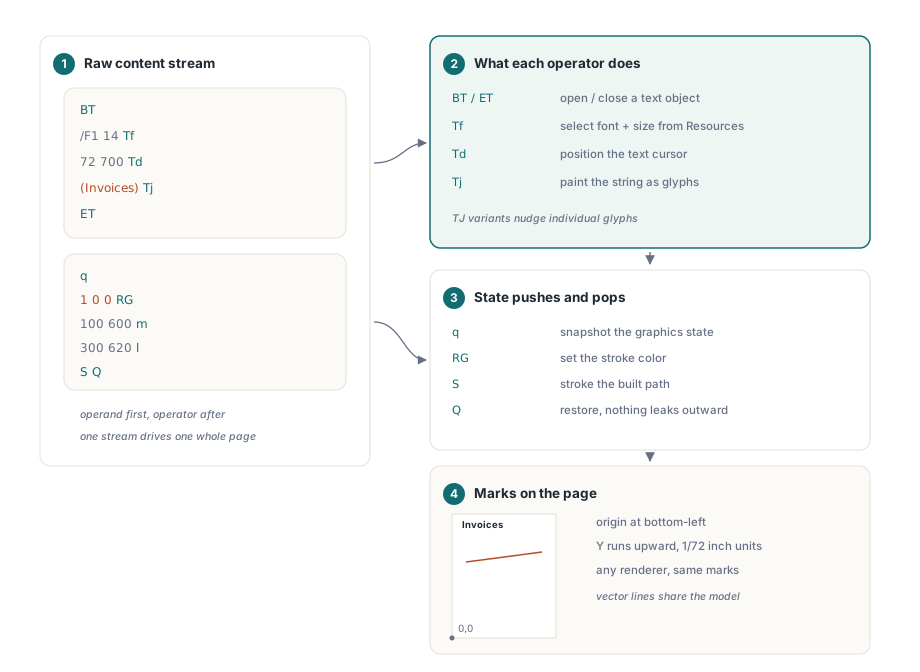
/F1 这类名称是页面 /Resources 里的键。字体字典经字体描述符(§9.8)通向内嵌的字体程序,图像在其 JPEG 或 Flate 数据解码后用一次 Do 画出。栅格化是最后一步。渲染器把变换矩阵应用到每条路径和字形轮廓,把磅换算成设备像素,再带抗锯齿填充结果。此刻页面仍是矢量数据,所以放大到 400% 是以更大比例重跑内容流,而不是拉伸位图。目标分辨率由调用方选择:屏幕用每英寸 96 或 150 像素,印刷用 300 或更高。在 PDFium Component 里,这一步是 TPdf.RenderPage,它接受以像素计的输出尺寸
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// 以 Dpi 像素/英寸渲染 FileName 的第 1 页并保存为 BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // 从 1 起数
    // PageWidth 和 PageHeight 以磅(1/72 英寸)计
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // 函数形式返回一个新位图
    end;
  finally
    Pdf.Free;
  end;
end;
页面看着好好的,为什么复制粘贴出来是乱码?
当文件只记录画哪个字形、却不记录它代表哪个字符时,复制粘贴就会失败。渲染只需要内嵌字体程序里的字形;提取需要 Unicode,它来自标准编码或字体字典上的 /ToUnicode CMap(§9.10.3)。带 /Encoding /Identity-H 的复合字体把原始字形 ID 写进内容流,没有 ToUnicode 映射时,这些 ID 与任何字符都没有确定的关系。屏幕上完美无缺,剪贴板里却堆满符号。子集字体让这更容易发生:它们只保留文档用到的字形,凭 /BaseFont /AAAAAA+ArialMT 这类名称里的六字母前缀就能一眼认出(§9.6.4)。PDF 字体处理指南深入讲过 CJK 字体与提取失败的问题
增量更新与签名字节范围
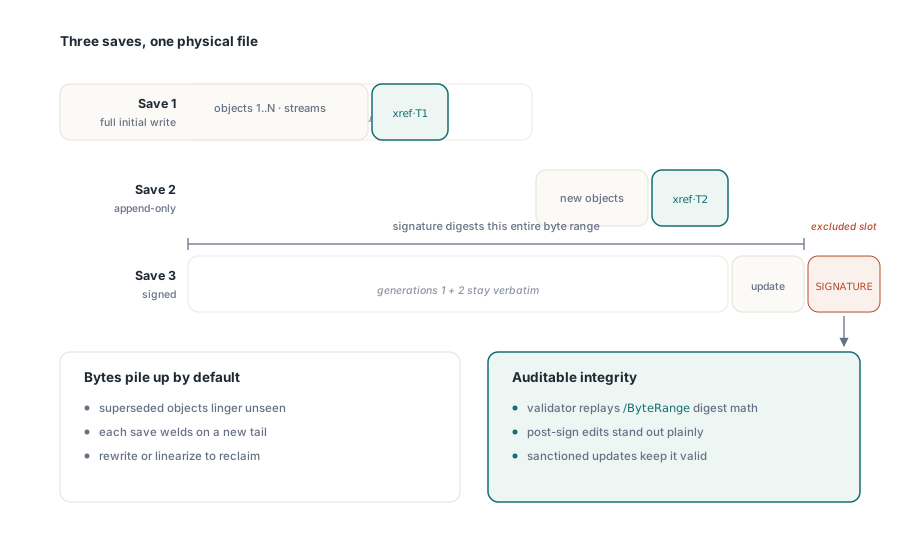
签名依赖 PDF 只追加的编辑方式:增量更新(§7.5.6)在最后一个 %%EOF 之后添加对象和新的交叉引用节,结构总览解释了 /Prev 链,以及被删内容为何仍活在更早的修订里。签名字典的 /ByteRange 写作 [0 a b c],对除保存 CMS 签名的 /Contents 十六进制串之外的一切做哈希,所以被签名的修订止于字节 b + c,验证器把文件在那里截断即可重建它。更晚的修订落在那一点之后;而完整重写、线性化或优化处理会移动签名者哈希过的字节,让所有既有签名一次性全部失效
当 Delphi 或 Lazarus 应用需要这整条管线——从解析交叉引用数据、走页面树,到渲染和文本提取——PDFium Component for Delphi and Lazarus 把它包进上面清单所用的 TPdf 文档组件,外加用于屏幕显示的 TPdfView 查看器控件