从一个 40 页的 PDF 里复制 3 页要花两分钟,这不是性能调优问题,而是用错 API 路径的信号。第一次在基于 HotPDF Delphi Component 的页面复制代码上看到这个耗时时,我的直觉是先查文档结构、再查代码。事实证明这个顺序反了
真正慢的是什么
出问题的 PDF 是一份 40 页的参考文档,页面树不平凡:多个中间 /Pages 节点,而不是单个扁平数组。出问题的代码调用 LoadFromFile,然后用 BeginDoc 建一个新文档,循环选定的页码,每轮迭代再从磁盘重新加载源文档去取一页。这是完整解析成本乘以你想要的页数。一份 12 MB 的文件为了一次三页提取打了六次磁盘,因为没人看过这份文件是否需要在迭代之间保持打开
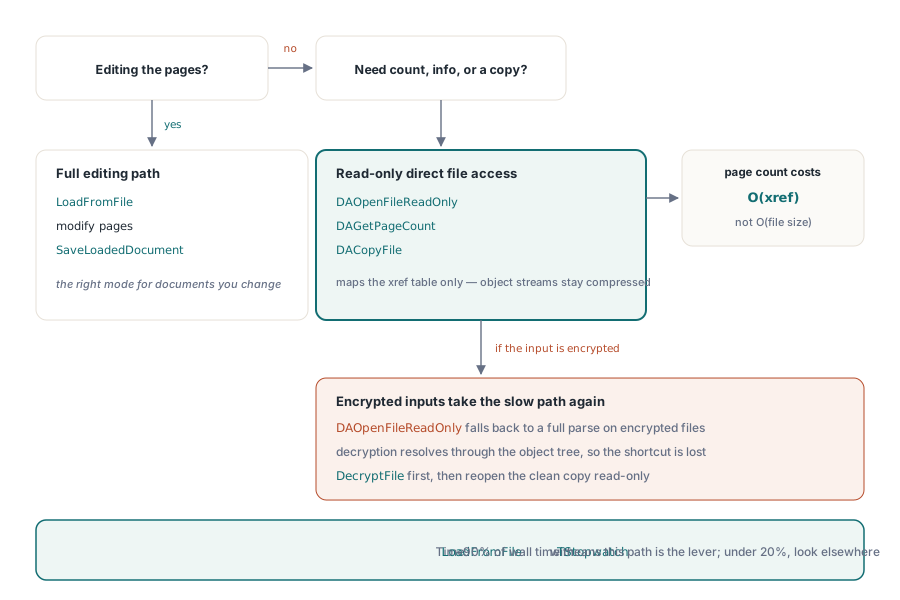
第二个推手在代码里看不见:HotPDF 的 LoadFromFile 会构建编辑 API 所依赖的内存对象模型。对一份即将修改的文档,这是正确行为;但如果你只想要页数加一个页面子集,它做的功就超了。要对结构做只读访问,DAOpenFileReadOnly 避免反序列化完整对象树,这在带大量图像资源的压缩文件上很要紧
两件事归结为同一句话:拿为某个工作设计的 API 去干了另一个工作
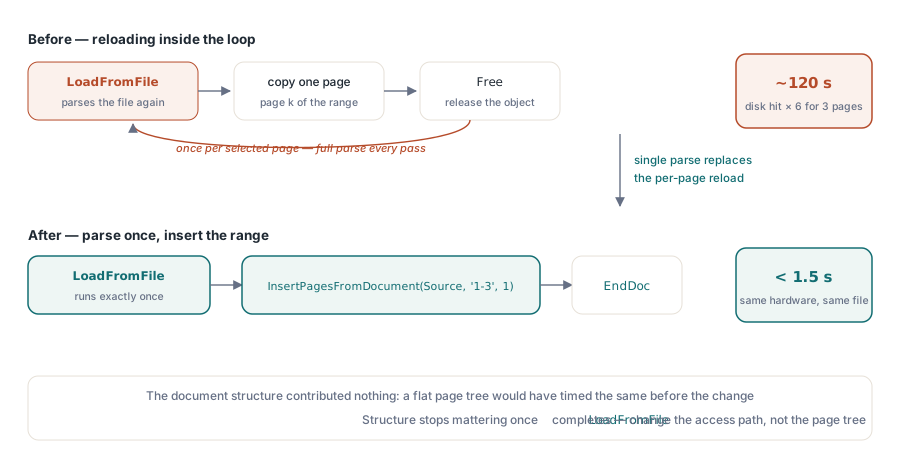
用 ExtractPagesToFile 做页面提取
把一段页面范围从已加载的 HotPDF 文档复制进一个新文件的正确路径是 ExtractPagesToFile,在源上 LoadFromFile 之后调用。源只加载一次,这次调用会构建目标文档、把选中的页面拷进去并写盘——全程用的是内存里已有的那份副本:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // 只加载源一次:完整解析只发生在这里
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // 把请求的范围('1-3'、'1,5,7-9')直接写进一个新文件
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
PageRange 参数接受与命令行示例相同的格式:逗号分隔的页码或范围列表,比如 '1-3' 或 '1,5,7-9'。页面从 1 起数。ExtractPagesToFile 会把每个选中页面连同它引用的内容流和资源一起复制,所以从 40 页文档提取 3 页时,工作集依然很小
在之前跑两分钟的同一份 12 MB 文件上计时:这个模式大约 1.3 秒。其中大部分时间花在那一次 LoadFromFile 上。对象表第一次解析完之后,文档结构就无关紧要了
当 LoadFromFile 开销过大时:直接文件 API
如果你只需要数页数、看文档信息,或者不碰内容地复制一个文件,直接文件 API 完全避开完整解析。DAOpenFileReadOnly 映射交叉引用表而不解压对象流,所以数页数的开销是 O(交叉引用表大小) 而不是 O(文件大小):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile 是逐字节保留的复制,不重新序列化
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;有个注意事项:DAOpenFileReadOnly 接受密码参数,但遇到加密输入会回退到完整解析,因为解密需要对象树来解析加密字典。源文件是加密的,就先用 DecryptFile 解出一份未加密副本,再用直接文件 API 打开它。文件级 DecryptFile 函数对标准加密走直接的 AES-256 重写路径,大文件上比 LoadFromFile 接 SaveLoadedDocument 更快,因为它不构建完整的内存对象模型
大批量处理期间的内存
在循环里处理几十个文件的批处理作业有一种看着正确却持续攒内存的模式:循环内创建 THotPDF、调用 LoadFromFile、干活、调用 Free。结构上没问题。问题出在内层工作分配了临时对象、捕获了异常、却让这些临时对象在错误路径上活着。Delphi 的内存管理器不做整理,一批跑下来错误路径上的一百个泄露就能把内存推高到拖慢其余一切分配的程度
解法并不稀奇。每个 THotPDF 和每个参与 PDF 工作的中间 TStream 或 TBitmap,都该放进一个 try/finally 块,Free 是最后一句。局部指针在 try 之前先置 nil,初始化半途失败时 finally 分支才能安全地用 if Assigned(x) then x.Free。这是标准的 Delphi 所有权纪律,对这一类问题,它就是全部答案
批处理环境里还要知道一件事:AddImage 会把每张图注册进正在构建的文档,EndDoc 完成那个文件时 HotPDF 会释放这些注册。注册表跟着 BeginDoc/EndDoc 周期走,不跟 LoadFromFile,所以批处理的干净模式是一份文档一个 THotPDF 实例:创建、干活、保存、释放
动手改任何东西之前先测量
在使用这些模式之前,先测量。System.Diagnostics 里的 Delphi TStopwatch 包装了 QueryPerformanceCounter,精度足以给文件 I/O 做挂钟分析。单独包住 LoadFromFile,看它占多久。占到总时间 90%,修法就是直接文件 API,或者减少解析同一份文件的次数;低于 20%,瓶颈在别处,你追错了东西
引出这篇文章的那次两分钟提取,最终查明完全是重复加载模式。文档结构没帮任何倒忙;扁平页面树也会一样跑。换成一次 LoadFromFile 接一次 ExtractPagesToFile,其他什么都不动,同一台硬件上降到约 1.3 秒
这里展示的页面操作 API 是面向 Delphi 和 C++Builder 的 HotPDF Delphi Component 的一部分