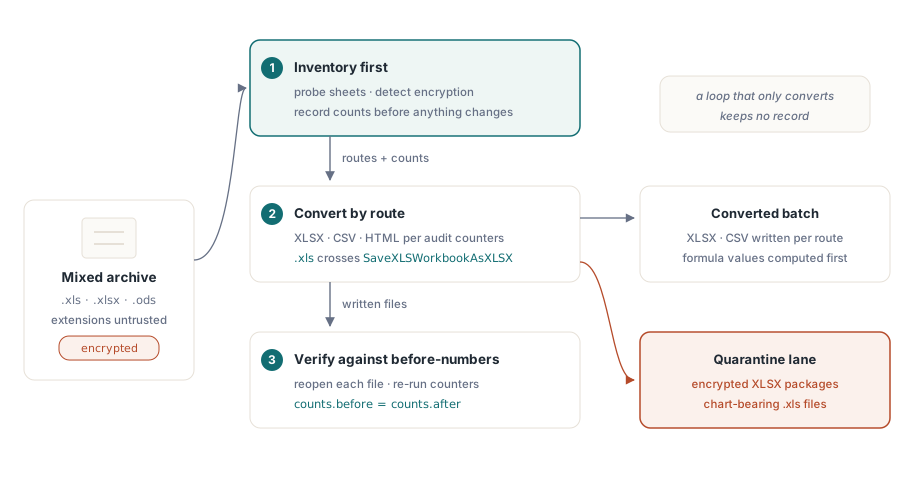
批量电子表格归一化任务其实是披着同一件外衣的三个问题。你面对的是格式混杂的存档:BIFF 时代的 .xls、现代的 .xlsx、某次 LibreOffice 试验留下的零星 .ods,还有几个谁也打不开的文件,因为密码随某位离职员工一起消失了。目标是把一切都转换为 XLSX 和 CSV。大多数人写出的版本是一个循环,打开每个文件再用新扩展名保存,这套流程一直运转良好,直到有人问起哪些文件丢失了图表、丢掉了宏,或者干脆从未打开过。这个循环答不上来,因为单纯的转换不留任何记录。工作台则不同:它先清点、再转换、最后校验,而且三个阶段必须彼此共享信息,整套流程才靠得住
在 Delphi 或 C++Builder 中搭建这样一个工作台,意味着把 HotXLS 的四项能力串联起来,而且这些能力都不需要流水线中任何一处的 Excel 安装。这里有两套原生引擎:一套用于 .xls 的 BIFF8 门面,以及一套用于 .xlsx 和 .ods 的 OOXML 门面。还有不解析整个文件就能读取元数据的低成本探测调用。有逐工作表的审计计数器,告诉你工作簿里到底装了什么。以及一张为每条路径都附有文档化保真度说明的转换矩阵。真正的工作在于搞清每一项能力的锋利边缘在哪里,因为它们无一例外都有,而这些边缘恰恰就是把一次干净的通宵批处理变成周一早晨事故的东西
加载前先探测:工作表名与加密检测
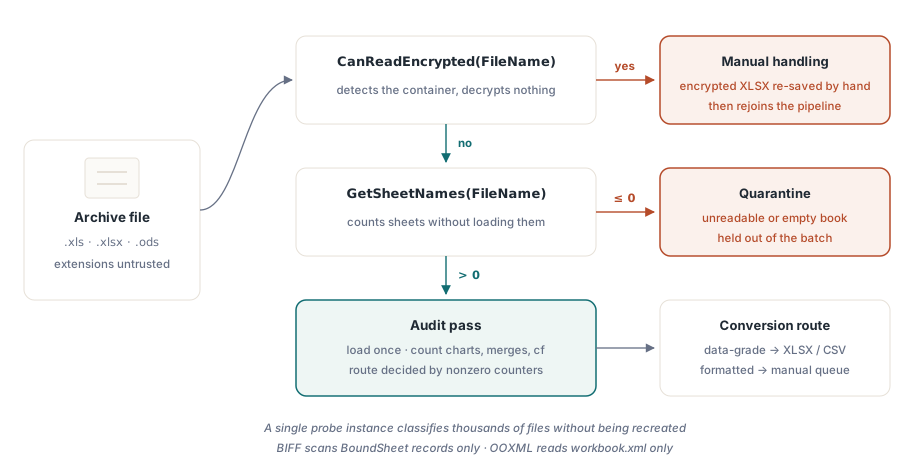
打开一个 200 MB 的工作簿却发现它是加密的,这会在每个文件上浪费数分钟,乘以一个庞大的存档就是浪费数天。两套门面都暴露了 GetSheetNames,它读取工作表元数据而不填充工作簿。BIFF 实现只扫描流开头的 BoundSheet 记录;OOXML 实现只读取 zip 内部的 workbook.xml。与之配套的 CanReadEncrypted 在不尝试解密的情况下检测出加密容器:
var
  Probe: TXLSXWorkbook;
  Names: TStringList;
begin
  Names := TStringList.Create;
  Probe := TXLSXWorkbook.Create;
  try
    if Probe.CanReadEncrypted(FileName) then
    begin
      Writeln(FileName + ': encrypted container - route to manual handling');
      Exit;
    end;
    if Probe.GetSheetNames(FileName, Names) <= 0 then
      Writeln(FileName + ': unreadable - quarantine')
    else
      Writeln(Format('%s: %d sheet(s), first "%s"',
        [FileName, Names.Count, Names[0]]));
  finally
    Probe.Free;
    Names.Free;
  end;
end;两个运营细节让这个循环成本很低。GetSheetNames 不会重置或填充工作簿实例,因此单个探测对象可以对数千个文件进行分类而无需重建。而 XLS 门面版的同名调用也能识别 .xlsx 包,当文件扩展名不可信时——在如此陈旧的存档中扩展名几乎总是不可信——它就成了一个便捷的统一探测入口。加载前的分诊值得单独成文;轻量级检查的具体机制见我们关于工作表列举与轻量级工作簿检查的文章
统计工作簿真正包含的内容
文件通过分诊后,审计这一遍就决定了它的转换路径。XLSX 门面为每一个会影响保真度判断的功能族暴露了计数器:合并单元格、图表、图片、条件格式、数据验证、表格、超链接和批注,外加宏、保护和源格式等工作簿级标志。一个文件的转换路径几乎完全取决于这些计数器中哪些返回了非零值
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  I: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.Open(FileName) <> 1 then Exit;
    for I := 0 to Book.Sheets.Count - 1 do
    begin
      Sheet := Book.Sheets[I];
      Writeln(Format('%s: cells=%d merges=%d charts=%d cf=%d dv=%d protected=%s',
        [Sheet.Name, Sheet.Cells.Count, Sheet.MergedCells.Count,
         Sheet.Charts.Count, Sheet.ConditionalFormats.Count,
         Sheet.DataValidations.Count, BoolToStr(Sheet.IsProtected, True)]));
    end;
    if Book.HasVbaProject then
      Writeln('  contains VBA project - macro policy applies');
    if Book.ExternalLinks.Count > 0 then
      Writeln(Format('  %d external link(s)', [Book.ExternalLinks.Count]));
  finally
    Book.Free;
  end;
end;
读取 Cells.Count 时要记住一个注意事项。单元格存储是稀疏的,所以这个数字统计的是已实例化的单元格,而不是已用区域的矩形面积。一个在 A1 有一个值、在 ZZ9999 有另一个值的工作表只会报告两个单元格,而不是它们之间上百万个。BIFF 侧等效的扫描使用 UsedRange 边界配合 ForEachCell,而且它带有那个几乎第一次都会绊倒所有人的 off-by-one:UsedRange.FirstRow 及其同类是 0 基的,而 Cells.Item[Row, Col] 是 1 基的。忘记给每个边界加一的遍历会审计错误的矩形,而且从不吭声
两个杠杆能降低对大型遗留文件进行仅审计一遍的成本。在打开 .xls 之前把 _DisableGraphics 设为 true 会完全跳过 OfficeArt 绘图层解析,这在充满图形的工作簿上节省可观时间。但这严格来说是一项只读优化:从这样打开的实例保存会丢掉它从未解析的绘图,因此这个标志只属于永远不会把文件写回的路径。当审计需要的是逐单元格内容而非计数时,ForEachCell 回调直接遍历已填充的单元格,避开了索引式单元格属性在每次读取时都要付出的逐次访问 Variant 开销,这种开销在数百万个单元格上累积得很快
尽早归一化不一致的返回码
HotXLS 的 I/O 调用通过整型结果而非异常来报告错误,而且这些约定在整个 API 中并不统一。大多数打开和保存调用成功返回 1,失败返回 -1。GetSheetNames 返回工作表计数,或返回 -1 并清空列表。XLSX 的 SaveAsHTML 再次打破模式,成功返回 0,工作表索引越界返回 -1。一个到处测试 = 1 的工作台会悄悄把那些以其他方式表示成功的调用分错类,而一个测试 <> -1 的工作台会吞掉那些以不同代码失败的调用
能经受住整个 API 考验的规则比看起来更窄:对返回计数的调用把 <= 0 当作失败,对每个你实际使用的保存例程查证它文档化的成功值,并把两者都收拢到一个小的结果检查函数背后,这样约定就只存在于唯一一处。批处理流水线的失败更多是源自未检查返回码的缓慢堆积,而非某种奇异的解析器缺陷,而把这一点搞错的代价要在四万个文件之后才显现,那时没人还记得哪些转换真正成功了
转换矩阵与每条路径的数据丢失点
两套门面在它们之间划分了转换工作。TXLSXWorkbook 打开 XLSX、ODS 和 CSV,保存 XLSX、ODS、CSV、HTML、RTF 以及 AES 加密的 XLSX。TXLSWorkbook 打开并保存 BIFF,还导出 HTML、RTF 和 CSV。有价值的是每条路径都附有文档化的保真度说明,而不是一句关于正确性的含糊承诺,所以你可以提前决定哪些路径对哪些文件是安全的
CSV 导出写入带 BOM 的 UTF-8、CRLF 行尾以及 RFC 4180 引号规则。它不做的是求值公式:一个持有 =SUM(...) 的单元格导出为字面的公式文本,因此一整页公式会变成一整页字符串,除非你先把值算出来。HTML 导出产出单个表格,用 colspan 和 rowspan 代替合并单元格,基础样式以内联方式写入。RTF 导出有一个更尖锐的限制:它无法让合并单元格跨列延伸,因此合并的续接单元格输出为空。ODS 导入按库自己的文档说明是有意保持轻量的。标量值和缓存的公式结果能带过来;样式、活跃的 ODF 公式表达式和绘图则不能。一旦存档中包含受 OASIS ODF 1.3 约束的真正 OpenDocument 文件,这一点就至关重要——任何接近视觉上保真的转换所需的能力都超出了这条导入路径的设计承载,而审计这一遍正是在批处理悄悄把它们压平之前告诉你这些文件存在
SaveXLSWorkbookAsXLSX 是数据桥,不是版面桥
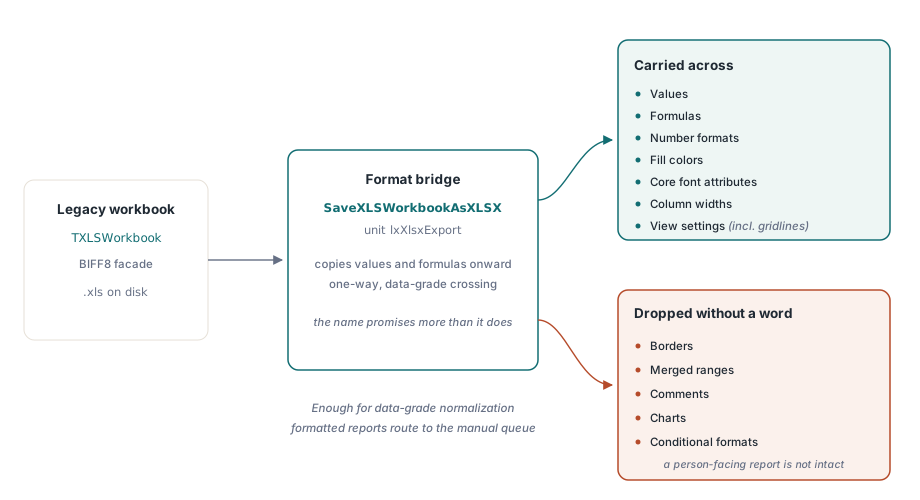
BIFF 门面无法直接写入 OOXML,所以从 .xls 到 .xlsx 的跨越要经过 lxXlsxExport 单元中的 SaveXLSWorkbookAsXLSX 函数。这座桥的保真度值得直说,因为它的名字暗示的能力超过它实际所做的。它复制值、公式、数字格式、填充颜色、核心字体属性、列宽以及诸如网格线之类的视图设置。它不复制边框、合并区域、批注、图表或条件格式。对于数据级的归一化——下游系统会解析结果,而没人去看格式——这刚好够用,任何人需要的东西都不会丢失。对于一份旨在让人阅读的格式化董事会报告,这不够,而这恰恰是审计计数器派上用场的地方:审计标记为带有图表和条件格式的文件应该被引导到手动队列,而不是经过一座会二话不说把两者都丢掉的桥
var
  Legacy: IXLSWorkbook;        // 接口引用:不要 Free
  Modern: TXLSXWorkbook;
begin
  if SameText(ExtractFileExt(FileName), '.xls') then
  begin
    Legacy := TXLSWorkbook.Create;
    if Legacy.Open(FileName) <= 0 then Exit;
    if SaveXLSWorkbookAsXLSX(Legacy,
         ChangeFileExt(FileName, '.xlsx')) <= 0 then
      Writeln('bridge failed: ' + FileName);
  end
  else
  begin
    Modern := TXLSXWorkbook.Create;
    try
      Modern.StreamingWrite := True;     // 将工作表 XML 写入 zip
      if Modern.Open(FileName) = 1 then
        Modern.SaveAsCSV(ChangeFileExt(FileName, '.csv'), 0, ',');
    finally
      Modern.Free;
    end;
  end;
end;
上面的循环也展示了 OOXML 侧的吞吐量杠杆。把 StreamingWrite 设为 true 会把工作表 XML 直接流式写入输出包,而不是作为一整块巨大字符串暂存在内存中,这正是文件达到数十万行时一次舒适运行与内存溢出崩溃之间的差别。该模式的内存占用与行为在我们关于服务器批处理流式写入的文章中专门讨论。对于一个想用满每个核心的批处理,还有一项属性很重要:两套门面都不是线程安全的,但也不共享全局状态,因此并行转换受支持的模式是每个工作线程一个工作簿实例,它们之间不加锁
密码文件以及如何处置它们
存档中的锁定文件按格式干净地拆分,而这个拆分决定了它们去往哪里。遗留的 .xls 加密,无论是 RC4、基于 CryptoAPI 的 RC4,还是旧的 XOR 混淆,都是可读的:把密码传给 Open,文件就像任何其他文件一样转换。加密的 .xlsx 包则是另一回事。HotXLS 用 CanReadEncrypted 检测它们,但无法解密,所以唯一诚实的做法是把它们引导到一个队列,由人在 Excel 中打开并重新保存每一个,然后让它重新加入流水线。这种不对称性值得在设计之初就考虑进去,因为加密的 XLSX 文件最有可能正是某人真正关心的记录
用校验闭合回路
第三阶段是最容易被跳过的,而跳过它正是把一次批量转换变成隐患的原因。HotXLS 中没有任何保存路径会求值公式。Excel 在打开文件时会重新计算,所以 XLSX 到 XLSX 的转换保持正确,但 CSV 目标会原样收到公式文本,除非流水线先对单元格运行 Calculate 并把结果写回。事先知道这一点,就是一个满是数字的 CSV 与一个满是 =SUM(...) 字符串的 CSV 之间的差别——后者直到某个下游导入被它噎住才有人察觉
校验本身的成本低到没有任何借口把它省掉。用同一个库重新打开每个已转换文件,重新运行审计计数器,并把它们与清点那一遍已记录的转换前数字相比较。一个下降了的工作表计数、一个源文件有三张图却归零的图表计数、一个断崖式下跌的单元格计数:每一个都是一次以第二次打开为代价捕获到的静默丢失。在此基础上抽检一部分在 Excel 或 LibreOffice 中用肉眼复核,这种组合能在绝大多数转换损坏出厂前将其捕获。这正是清点阶段把数据喂给校验阶段的全部理由。没有转换前的数字,转换后的数字什么也证明不了
一个以审计为先的工作台把一次有风险的批量转换变成了一个可度量的流程,并为无法干净通过的文件准备了一条隔离通道。此处展示的所有探测、统计和转换调用都属于 HotXLS Delphi Component,它在进程内原生运行这些调用,无需 Excel 自动化