HotXLS 通过 TXLSCalculator.GetCompiledFormulaR1C1 编译以 R1C1 引用记法书写的公式,它接受 R2C3(绝对)、R[-1]C[2](相对偏移)和 RC(当前单元格)这类形式,按公式所在单元格的行列把它们转换成 A1 记法,再把结果喂给处理普通 A1 公式的同一个编译器。对于要在数百行上生成同一条公式的 Delphi 与 C++Builder 代码,这一个方法就消除了一整类字符串拼接 bug
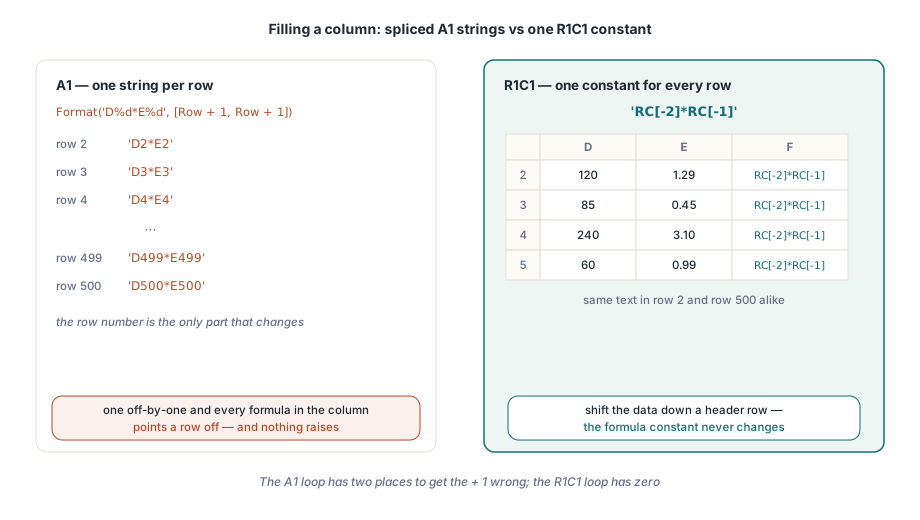
凡是用程序填过一整列的人都熟悉这类 bug。你在行上循环,每一行都用 Format('D%d*E%d', [Row, Row]) 拼出一条 A1 公式字符串。每次迭代都往文本里塞行号,而行号是唯一变化的部分。只要有一次把偏移搞错,把从 0 起的循环计数器和从 1 起的 A1 行号混在一起,或者数据块被一行表头顶下去了,整列公式就都差了一行。什么都不会报错;数字就是错的。你真正想表达的那条公式 —— “把我左边那两个单元格相乘” —— 根本不提任何行号,而 R1C1 记法正好让你这么写
什么是 R1C1 记法,什么时候该用它?
R1C1 记法用行号加列号来寻址单元格,而不是列字母加行号,并把相对引用标记成相对公式所在单元格的显式偏移。R2C3 是第 2 行第 3 列的绝对单元格,A1 里写作 $C$2。R[-1]C[2] 是公式所在位置上方一行、右侧两列。RC 就是公式单元格本身。方括号偏移正是要点所在:R1C1 中的相对引用无论落在哪个单元格里读起来都一样,而同一个引用的 A1 写法会随每一行改变
这套记法只在一个场景里挣得回票价,而那正是一个常见场景:模板生成 —— 同一条相对公式必须被种进数据区的每一行。用 A1,你必须逐行重新渲染公式文本。用 R1C1,那段文本是个常量。这也更接近电子表格文件格式内部的思考方式:共享公式记录把相对引用存成相对宿主单元格的行列偏移,因此你逐行合成出来的 A1 字符串,只是让解析器再把它拆回偏移量而已。R1C1 省掉了这趟往返。对于交互式、由人书写的公式,A1 仍是自然之选,这也是它在 HotXLS 各处保持默认的原因
HotXLS 怎样编译一条 R1C1 公式?
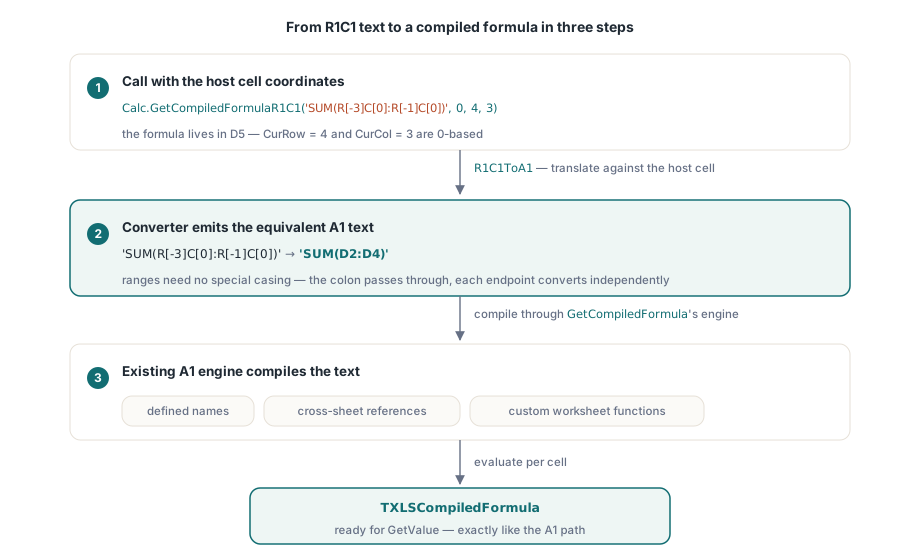
HotXLS 在两个层次上暴露这项功能,于 v2.175.0 加入。TXLSCalculator.GetCompiledFormulaR1C1(UncompiledFormula: String; SheetID, CurRow, CurCol: Integer): TXLSCompiledFormula 是大多数代码会调用的那个:它返回一条可供求值的已编译公式,与它的 A1 同胞 GetCompiledFormula 完全一样,只是多了两个参数,用来指明公式所属单元格从 0 起的行和列。在它之下,TXLSFormula.GetCompiledR1C1 产出原始语法树,而独立函数 R1C1ToA1(const AFormula: String; CurRow, CurCol: Integer): String 执行真正的记法转换。这条流水线被有意做得很简单:用宿主单元格坐标把 R1C1 文本翻译成等价的 A1 文本,再让现有引擎编译这段 A1 文本 —— 也就是那个解析定义名称与跨表引用、分派自定义工作表函数的同一个引擎
由于转换发生在编译之前,下游的一切行为都像是你自己写了那条 A1 公式。R1C1ToA1('R2C3', 4, 3) 无论宿主单元格是哪个都返回 '$C$2',因为两个坐标都是绝对的。R1C1ToA1('SUM(R[-3]C[0]:R[-1]C[0])', 4, 3) —— 一条住在 D5 的公式,因为 CurRow = 4 和 CurCol = 3 是从 0 起的 —— 返回 'SUM(D2:D4)':偏移是按第 5 行、D 列解析的,并作为普通的相对 A1 引用输出。区间不需要特殊处理;冒号原样通过,两个端点各自独立转换
// 公式位于 D5:CurRow = 4,CurCol = 3(两者都从 0 起)
S := R1C1ToA1('R2C3', 4, 3);
// S = '$C$2'  (行与列均为绝对)

S := R1C1ToA1('SUM(R[-3]C[0]:R[-1]C[0])', 4, 3);
// S = 'SUM(D2:D4)'  (偏移按 D5 解析)

S := R1C1ToA1('ROUND(R[-1]C[0], 2)', 4, 3);
// S = 'ROUND(D4, 2)'  (ROUND 里的 R 原封不动)
用一条相对公式填满整列
回报体现在循环里。把 A1 版本与 R1C1 版本对比一下:前者每次迭代都要重新渲染公式文本,后者的公式是个常量,变的只有宿主坐标。两者都经 TXLSCalculator 编译,并用 GetValue 求值;计算器在构造时接受一个单元格提供者回调,好让求值器从你的数据源取单元格值
// A1 风格:每一行都是一条不同的公式字符串
for Row := 1 to 500 do
begin
  FormulaText := Format('D%d*E%d', [Row + 1, Row + 1]);  // A1 行号从 1 起
  Compiled := Calc.GetCompiledFormula(FormulaText, 0);
  // ... 求值、存储、释放 ...
end;
const
AmountFormula = 'RC[-2]*RC[-1]'; // 同一行,左边两个单元格
var
Calc: TXLSCalculator;
Compiled: TXLSCompiledFormula;
Value: Variant;
Row: Integer;
begin
Calc := TXLSCalculator.Create(nil, Provider.GetValue);
try
for Row := 1 to 500 do
begin
Compiled := Calc.GetCompiledFormulaR1C1(AmountFormula, 0, Row, 5);
try
if Calc.GetValue(0, Compiled, Row, 5, Value, 1) = lxOk then
StoreResult(Row, 5, Value);
finally
Compiled.Free;
end;
end;
finally
Calc.Free;
end;
end;R1C1 版的循环里,公式文本中完全没有行运算。'RC[-2]*RC[-1]' 在第 2 行和第 500 行里同样意味着“同一行、左边两列,乘以同一行、左边一列”,而若数据块日后被一行表头顶下去,这条公式常量不必改 —— 要改的只有循环边界。A1 版有两处地方能把 + 1 调整搞错;R1C1 版一处都没有
转换器接受哪些 R1C1 形式?
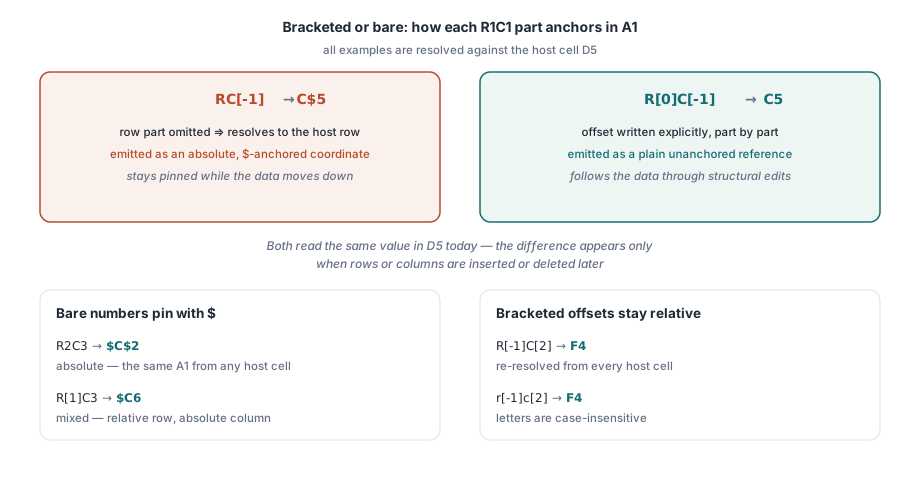
R1C1ToA1 转换器识别 v2.175.0 文档所载的这些形式:两个方向的相对偏移 R[n]C[m]、行列均绝对的 RnCm、带负偏移的 R[-n]C[m]、代表公式单元格本身的裸 RC,以及 R1C1:R3C3 或 R[-1]C:R[1]C 这样的区间。行部分和列部分各自独立解析,因此像 R[1]C3 这样的混合形式 —— 相对行、绝对列 —— 同样可用,而且字母不区分大小写,所以 r[-1]c[2] 和它的大写孪生编译结果相同。带方括号的部分变成不带锚定的(相对)A1 坐标;裸数字则变成带 $ 锚定的绝对坐标
有意思的问题是转换器如何避免把公式里的其他一切都搞乱,因为 R 和 C 都是常见字母。它的甄别规则是基于词法单元的:只有当一个 R 前面不是另一个字母时,才会被视为引用的开头,而且候选串随后必须完整解析成功 —— 可选的行部分、必需的 C、可选的列部分 —— 否则文本原样恢复。这正是 ROUND(R[-1]C[0], 2) 只转换内层引用的原因:ROUND 里的 R 后面跟的是 O,而不是数字、方括号或 C,因此解析失败,函数名原样通过。同样的逻辑保护了 ROW(),而以 C 开头的函数名根本就不会成为候选,因为只有 R 才能开启一个引用。v2.175.0 的发布说明称字符串字面量和标识符同样会被跳过;即便如此,若你公式里某个带引号的字面量恰好含有形状与 R1C1 引用一模一样的文本,在投入生产前值得先检查一次编译输出
值得知道的坐标基与锚定细节
有两套约定在这个 API 内部相遇,把它们分清楚就能避开唯一真正的陷阱。GetCompiledFormulaR1C1 的 CurRow 和 CurCol 参数从 0 起,遵循计算器 API 的惯例;而记法内部的数字从 1 起,与 Excel 显示的一致:R2C3 是第 2 行第 3 列,也就是 $C$2,而不是 $D$3。如果你的循环计数器本来就从 0 起,直接把它作为 CurRow 传进去就行;那个 + 1 住在转换器内部,不在你的代码里
如果已编译的公式要比它编译时所依附的单元格活得更久,还有一个细节要紧。当你省略行部分或列部分时 —— 也就是 RC[-1] 或 R[2]C 这类形式 —— 被省略的坐标解析成宿主单元格,并在转换出的 A1 文本中输出为带 $ 锚定的绝对坐标。求值时这是看不见的,因为两种写法的值都一样。但相对还是绝对的锚定,决定了日后插入或删除行列时引用如何位移,这一点见关于公式引用调整的姊妹篇。如果你需要某个坐标在结构性编辑中保持相对,就把偏移显式写出来 —— 用 R[0]C[-1] 而不是 RC[-1] —— 好让转换器输出不带锚定的 A1 引用
R1C1 编译是 HotXLS Delphi Excel Component 中公式引擎的一部分,与 A1 编译器、重算依赖图以及上面展示的求值 API 并肩。如果你的代码是靠沿列循环公式来搭建电子表格的,把那些循环从字符串拼接的 A1 换成一条 R1C1 常量,是能拿到的最便宜的可靠性升级之一