LibreOffice 和所有自产阅读器都毫无怨言打开的 XLSX,Excel 却弹出「我们发现部分内容有问题」,因为 Excel 强制两件这些阅读器不理会的事:schema 要求的属性和 Open Packaging Conventions 的唯一性规则。其中三条规则,任何把生成的部件与保留部件混在一起的写出器都容易踩:一个 <phoneticPr> 需要它的 fontId;每个部件名在 [Content_Types].xml 里只能有一个 Override;两个根关系绝不能共用 rId4 这样的标识符。本文逐条讲清楚,以及 HotXLS——面向 Delphi 和 C++Builder 的原生 Excel 电子表格组件——如何写包来满足它们
为什么别的阅读器都接受的包,Excel 却拒绝?
因为修复提示是 schema 与包验证器的产物,不是解析失败。一个工作簿可以在你自己的库、LibreOffice 和 XML 验证器之间来回穿梭,并且在XLSX OPC 关系解析一文所用的 OPC 意义上结构健全:每个部件可达、每个目标可解析。在一个 DisplayAlerts 关闭的隔离 COM 实例里走 Workbooks.Open,调用仍然可能直接失败。交互式打开同一个文件,则会出现那个熟悉的、提议修复的对话框;而修复日志——如果 Excel 肯写的话——只给出部件名,不给规则。多个互相独立的违例可以躲在同一个提示背后,Excel 不会一条条报;它直接拒收工作簿,把查找和分析留给你。下面是每条规则、违反它的自然写法,以及 HotXLS 的替代写法——因为每一条都是任何 Delphi XLSX 写出器都可能绊倒的规则
规则一:phoneticPr 的 fontId 必填,值为零也一样
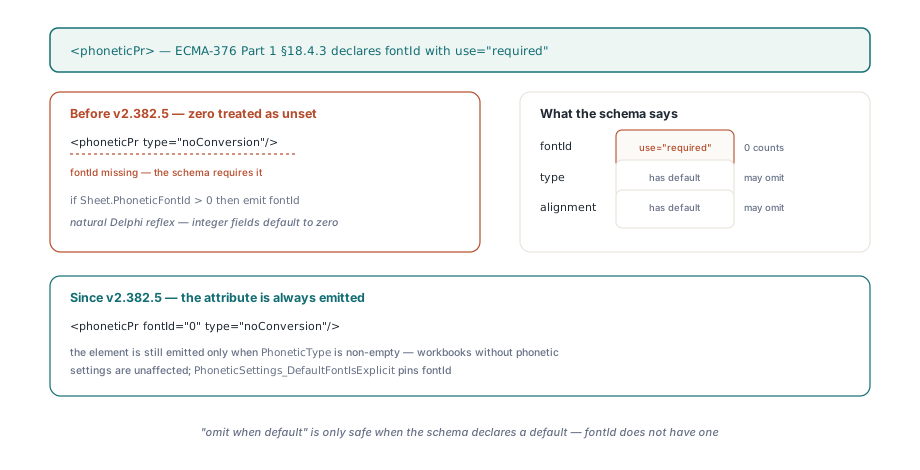
<phoneticPr> 元素携带一个在 ECMA-376 Part 1 §18.4.3 里声明为 use="required" 的 fontId 属性,值 0 是合法的字体下标,不是缺省。把零当「未设置」、只在 Sheet.PhoneticFontId > 0 时才输出该属性的写出器,遵循的是一种很自然的 Delphi 反射——整数字段默认为零嘛——但只要某个工作簿的语音字体恰好是 styles.xml 里的第一个字体,它就会产出 <phoneticPr type="noConversion"/>,而下标 0 就是第一个字体,这个场景很容易撞上。于是 Excel 在回读时拒绝了它自己写出的值
// 自然的反射:零当未设置,fontId 被丢掉
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas,工作表写出器——属性必填,零也要输出
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS 只在 TXLSXWorksheet.PhoneticType 非空时才输出该元素,所以从未带过语音设置的工作簿不受影响。在一张新表上把 PhoneticFontId 设为零、保存,xl/worksheets/sheet1.xml 就带着 <phoneticPr fontId="0"。更宽的教训是:「默认即省略」只有在 schema 声明了默认值时才安全;该元素里 type 和 alignment 有默认值,fontId 没有
规则二:[Content_Types].xml 里每个部件名一个 Override
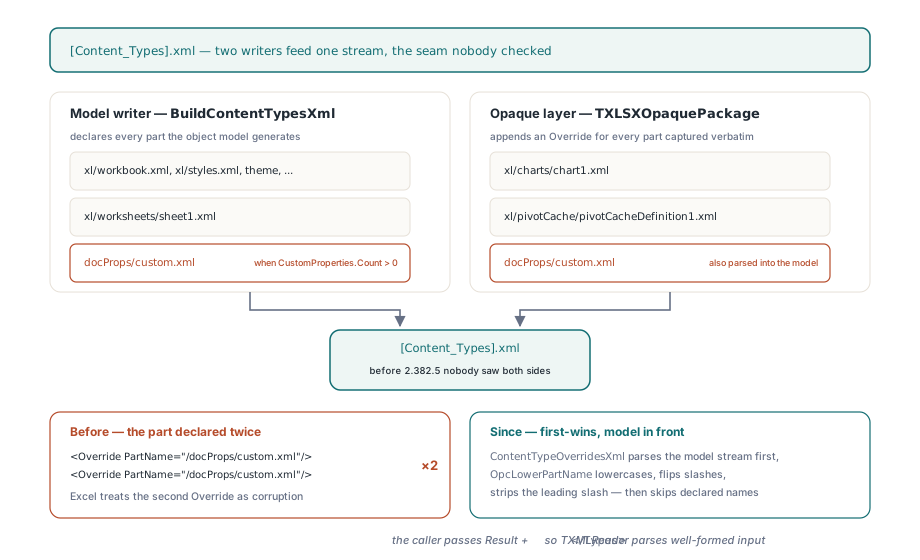
内容类型流对每个部件名最多声明一次,同一 PartName 出现第二个 Override 时,即使两条目的 ContentType 相同,Excel 也当作损坏。HotXLS 有两个写入方在喂这条流。BuildContentTypesXml 声明对象模型生成的每个部件:workbook、styles、shared strings、theme、worksheets,以及当 TXLSXWorkbook.CustomProperties.Count > 0 时的 /docProps/custom.xml。PreserveUnsupportedParts 打开时,TXLSXOpaquePackage 再为它从源包原样捕获的每个部件追加 Override,让这些字节在输出时仍有声明。冲突就出在两边都有的部件上。自定义文档属性已解析进模型,但源包的 docProps/custom.xml 也被不透明层捕获,于是天真的合并会声明它两次;当模型重新生成不透明层也保留的部件时,chart 和 pivot cache 部件也可能撞在同一个位置。看不到模型已写过什么的不透明写出器无从知晓,这正是要让 ContentTypeOverridesXml 拿到那份视图的原因
<!-- What a naive merge produces -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS 把生成的 XML 传给 ContentTypeOverridesXml,让不透明写出器在输出任何东西之前先解析它。两个细节承载正确性。OpcLowerPartName 在比较前小写化、把反斜杠翻成正斜杠、剥掉前导斜杠,因为 OPC 部件名按大小写不敏感比较,而模型带前导斜杠书写、不透明层存的 ZIP 项名没有。而 BuildContentTypesXml 里的调用方传入 Result + '</Types>',把未闭合的文档收口,让 TXMLReader 看到的是良构输入而非截断流。由此形成的规则是「模型优先的先到先得」:对象模型声明的一切都是权威,不透明回放只填空缺
// lxOpcPackage.pas——TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // 解析模型生成的流,收集所有已声明的 PartName。
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // 已经声明过,或者是 rels 部件
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
规则三:关系 Id 在一个关系部件内必须唯一
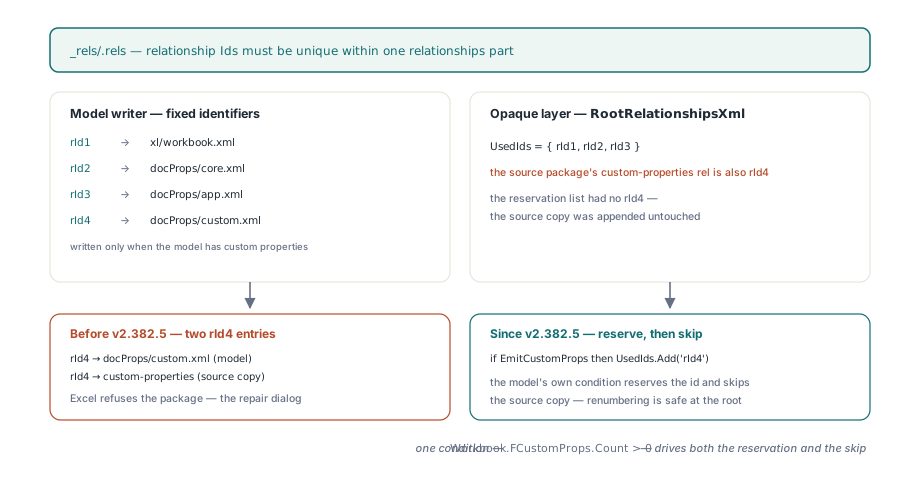
.rels 部件里的每个 Relationship 都需要一个在该部件内唯一的 Id,两个共用一个时 Excel 拒收整个包。HotXLS 用固定标识符写包级 _rels/.rels:rId1 给工作簿,rId2 和 rId3 给 core 和 extended 文档属性,模型有自定义属性时再给 rId4。不透明包随后追加它从源包保留的根关系,并对已在 UsedIds 列表里的标识符重新编号。如果这个列表只知道 rId1 到 rId3、不知道模型即将发出自己的自定义属性关系,那么源包的自定义属性关系恰好也是 rId4——Excel 默认就这么写——输出就会有两条指向同一目标的 rId4。因此,只要模型发出自定义属性,RootRelationshipsXml 就预留 rId4 并跳过源副本。调用方 BuildRootRelsXml 把 Workbook.FCustomProps.Count > 0 作为第二个参数传入,于是预留与跳过由同一个条件驱动——正是决定模型是否发出 rId4 的那个条件。在包根重新编号是安全的,因为工作簿内部没有东西按名字引用根关系标识符;同一手法放到下一层就错了,那里 workbook.xml 的 r:id 属性绑定的是工作簿关系部件里的标识符,这正是 MergeWorkbookRelationshipsXml 维护一份独立标识符映射的原因
// lxOpcPackage.pas——TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // 模型写出器预留
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // 自定义属性归模型所有;不要回放源副本。
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // 最小的空闲 rIdN
  UsedIds.Add(String(Id));
  ...
end;
这三条规则的共同点是什么?
三条都在防同一种写出器:有两个数据来源、却没有人对包不变量负全责。对象模型生成它理解的部件;不透明层回放它不理解的部件,让一次往返保住图表、pivot 缓存、自定义 XML 以及theme、extLst 和 calcChain 无损往返笔记里描述的其他一切。每一侧单独看都可以自洽。OPC 施加在整个包上的约束——唯一的 Override 部件名、每个部件内唯一的关系标识符——只存在于两者拼接的接缝上,所以必须有人管这条接缝。fontId 规则在低一层也是同一个形状:写出器可以只顾自己想省略什么,从不咨询那个说它不许省略的 schema。HotXLS 用固定优先级而不是合并启发式来解决这个问题:模型先写,不透明层看到已写内容并在任何碰撞上让位。这些不变量从外部检查也很便宜:读保存包里的 [Content_Types].xml 和每个 .rels 项,任何重复的 PartName、Extension 或 Id 都判失败。这个检查不需要 Excel,覆盖两条唯一性规则;fontId 规则仍需要 schema 验证器
打印区域是公式而不是区域时
打印区域是 Excel 在保存副本上比较的另一件事:一个 _xlnm.Print_Area 被 Excel 报告为 $A$1:$J$29 的模板,往返一次后必须原样报告。背后有两个陷阱。导入时,一个剥到第一个未加引号 ! 为止的前缀剥离,会把 OFFSET('Print Data'!$A$1,0,0,2,2) 这样的动态打印区域变成 $A$1,0,0,2,2),还会让 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 这种带限定名的并集只丢掉第一段的前缀。导出时,把表名一次性前缀到整段存储的 PrintArea,会给普通并集 $A$1:$B$2,$D$1:$E$2 造出一个带限定的第一段和一个裸的第二段,而 ECMA-376 Part 1 §18.2.5 下 Excel 不接受这样的 _xlnm.Print_Area 定义
// 导入:只有剩下的部分本身是纯 sqref 时才剥掉前缀
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) 原样返回

// 导出:要么给每个逗号分隔的片段都加上限定,要么一个都不加
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // 是公式:原样输出
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;两侧的判定规则相同:只有每一段都解析为裸区域时打印区域才是裸区域,否则它是公式、原样传输。有了这条规则,命名基、带表名限定的基和并集都能在一次又一次保存重开循环中存活。打印区域与页面设置及打印模型其余部分的互动,见工作表保护、页面设置与打印一文
怎么找出 Excel 到底在反对哪条规则?
先假设是你自己的验证器错了——毕竟它通过了。Open XML SDK 验证器会点名像缺失 fontId 这样的 schema 违例,给出部件和 XPath,它底下的打包层干脆拒绝打开内容类型条目重复的包,所以先跑它。它沉默而 Excel 仍要修复时,对包做二分:解压、删掉一个部件及其关系及其 Override、重新压缩、再打开,每次把候选集减半,直到提示消失。上面三个违例就按这个顺序浮出,而且没有一个会在 Excel 提议保存的修复版文件里可见,因为修复会悄悄丢弃或重编号有问题的条目。HotXLS 写出器里有两个设计选择值得知道。去重是模型优先的先到先得,所以源包对模型也会生成的部件声明了不同内容类型时,模型的声明获胜、源的被丢弃——这对 HotXLS 重新生成的部件是正确行为,不是通用合并。还有,启用 PreserveUnsupportedParts 时,对生成内容类型流的额外一次 TXMLReader 解析在每次保存都会运行——相对一条很少超过几 KB 的流,这点开销不算什么。有了这些规则,一个 4805 条公式的贷款模板经 Win32 和 Win64 两个构建保存后,在 Excel 里打开无提示、重算零失配,报告的打印区域与原件一致
如果你自己用 Delphi 写 XLSX,清单很短:schema 标为必填的属性,不管值是多少都要输出;每个部件名只声明一次;对每个关系部件,所有会碰它的写入器共用同一份已用标识符列表。如果你希望这份列表已经存在,并且是对着 Excel 而不只是对着你自己的阅读器测过的,本文描述的这个包写入器就在 HotXLS Delphi 电子表格组件里交付,连同那个让这道缝值得守护的不透明部件往返机制