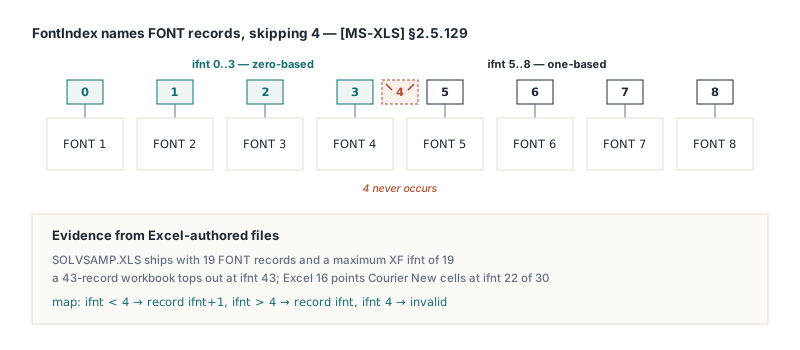
一个有八条 FONT 记录的 BIFF8 工作簿里,有一条 XF 记录的字体字段写着 8。从零数起这是表末尾之外的一格,Excel 却毫无怨言地用第八个字体渲染那个单元格。这个值是合法的:[MS-XLS] §2.5.129 把前四条 FONT 记录编号为 0 到 3,完全跳过 4,其后的每条记录按从一数起的位置编号
所以第五条 FONT 记录是 ifnt 5,格式良好的文件永远不需要超过其 FONT 记录数的值。这条规则读起来像规范里的笔误,恰恰因此总有人去“纠正”它;又因为单元格格式、共享字符串富文本和批注 run 带的都是同一个 FontIndex 类型,各路径解读不一就会让一些字体绑定正确、另一些偏一条记录。它与解码 BIFF8 XLUnicodeString 的 cch 与 fHigh里那些长度和编码怪癖是同一族——文件没问题,是读它的方式出了问题
[MS-XLS] §2.5.129 说了什么,如何在真实文件上验证
[MS-XLS] §2.5.129 把 FontIndex 定义为一个带洞的记录位置。小于 4 的值从零数起,大于 4 的值从一数起,值 4 不得使用(MUST NOT)。XF 记录用它指向字体,富共享字符串的 FormatRun 条目用它,§2.5.272 描述的 TXO 格式 run 同样如此
规范的话你不必全信。用任意 BIFF 记录查看器打开一份 Excel 自己保存的 .xls,数一数 FONT 记录(记录类型 $0031),再扫描每条 XF 记录($00E0)开头的字体字段。最大值不会超出记录总数,列表里找不到 4。如果看到 4 或超过 FONT 数的值,文件是别的写入器产出的,它的字体编号值得细看。做诊断工具或测试时,整个映射就两个函数的事
// 你自己的辅助函数,不属于任何库
// [MS-XLS] 2.5.129 FontIndex:0..3 从零起算,> 4 从一起算,4 非法
function FontIndexToRecordNo(Ifnt: Word): Integer;  // 从一起算的 FONT 记录
begin
  if Ifnt < 4 then
    Result := Ifnt + 1
  else if Ifnt > 4 then
    Result := Ifnt
  else
    Result := -1;  // 4 不得出现
end;

function RecordNoToFontIndex(RecordNo: Integer): Word;
begin
  if RecordNo <= 4 then
    Result := RecordNo - 1
  else
    Result := RecordNo;
end;
HotXLS 如何在 XF 记录和富文本 run 里给字体编号
HotXLS 按规范编号读写每一个 BIFF8 字体引用。保存时字体表被压缩到实际被引用的字体,每个幸存字体的位置变成一个 FontIndex:位置 1 到 4 写成 0 到 3,位置 5 及以上原样输出。加载时反向变换,任何 5 以上的值减一去内存里找字体,低于 5 的保持不动。同一转换应用于 XF 记录、共享字符串表里的富文本 run、批注与文本框 run,以及经典图表记录里的字体引用
对应用代码来说,可见的部分是 TXLSComment 和 TXLSTextBox 上的 TextRuns。TextRuns.FontIndex[I] 返回的正是读到的文件编号,跳过 4。run 索引从 1 起算,CharIndex[I] 是 run I 起始字符的偏移。这里暴露文件编号而不是从零起算的表槽位是更好的默认:API 报告的与记录转储显示的一致。代价是在把该值当表位置用之前,先调用一次上面的辅助函数
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  I: Integer;
  Ifnt: Word;
begin
  Book := TXLSWorkbook.Create;
  if Book.Open('review-notes.xls') <> 1 then
    raise Exception.Create('Cannot open review-notes.xls');
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  if Note <> nil then
    for I := 1 to Note.TextRuns.Count do
    begin
      Ifnt := Note.TextRuns.FontIndex[I];   // 文件编号,跳过 4
      // 你自己的合理性检查:4 说明文件违反 2.5.129
      if Ifnt = 4 then
        raise Exception.CreateFmt('Run %d uses invalid ifnt 4', [I]);
      Writeln(Format('run %d at char %d: ifnt %d = FONT record #%d',
        [I, Note.TextRuns.CharIndex[I], Ifnt, FontIndexToRecordNo(Ifnt)]));
    end;
end;
保存之后,run 存储的编号可能与你读到或设置的不同。保存把 run 和压缩后的字体表一起重新编号,编号变了,它指向的字体没变
为什么一个从零起算的“修复”会挪偏每个自定义字体
陷阱通常始于一份看起来很有道理的缺陷报告。有人转储一个八条 FONT 记录的工作簿,看到某个 XF 指向字体 8,断定写入器产出了越界索引,于是把写入器和读取器都改成朴素的从零起算算术。往返测试照样通过,因为打完补丁的写入器和读取器互相一致。Excel 不一致。那样写出的文件把第一个自定义字体存成 ifnt 4——Excel 把它解析成默认字体——其后每个自定义字体都提前一条记录落地。读 Excel 自己的文件则反过来:每个字体都晚绑一条记录
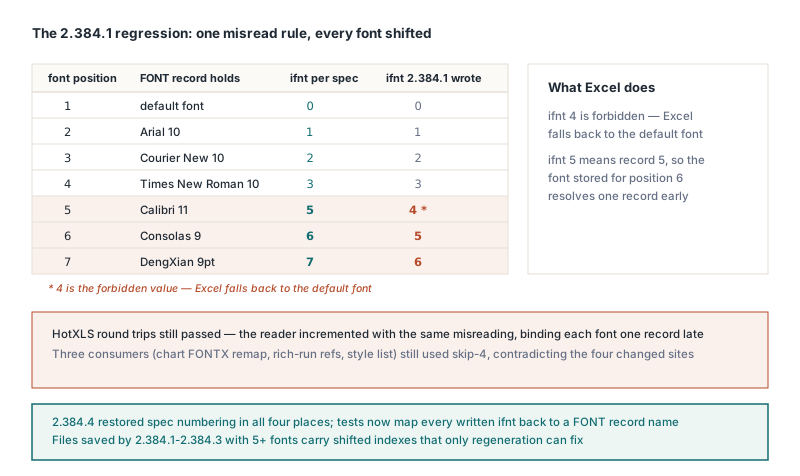
两个信号能在误读上线前把它暴露出来。其一是断言 ifnt < FontCount 的测试——看着像边界检查,实际是把误读写成了需求。按规范公式把每个写出的 ifnt 映射回 FONT 记录名字的测试,第一次运行就能抓住偏移
另一个信号是自相矛盾的代码。完整的 BIFF8 读取器和写入器要在多处应用跳过 4 的规则:XF 输出、XF 输入、共享字符串 run 重映射、批注 run、图表字体记录。当一次改动把其中几处改成从零起算而放过其余时,未动的位置就是证据——先怀疑改动,再怀疑它们。不完整的改动能潜伏很久,因为富文本里用的字体通常同时被某个单元格格式引用
为什么批注字体 run 只在第二次保存时坏掉?
当两种写入习惯相遇,批注和文本框 run 能挺过一次保存、坏在下一次。第一种习惯是不对称修剪:无条件保留前 N-1 条 FONT 记录,只在没有 XF 引用时丢弃最后一条。第二种是把 TXO 格式 run([MS-XLS] §2.4.329)逐字节写回而不重新编号。每种习惯单独都能通过单次保存的测试;合在一起,它们布下了一场等待一代的字体丢失
原因藏在 Excel 写出的东西里。Excel 生成的 .xls 文件末尾常带一条无引用的尾部字体;中文区域系统上是一条 9 磅 DengXian。第一次保存时,只被批注 run 使用的字体因此永远不会排在最后,看不出任何东西移动。但那次保存丢掉了尾部字体,把只被批注引用的字体顶到最后一位。第二次保存发现最后一条字体没有 XF 引用,将其丢弃。run 的 ifnt 从此指向表外,Excel 回退到默认字体。如果工作簿中间恰好新增了一个字体,run 反而会绑到新来的那个。被反复打开、标注、再保存的批注——比如搭建批注与超链接评审工作流里那种——正是最先踩中这里的地方
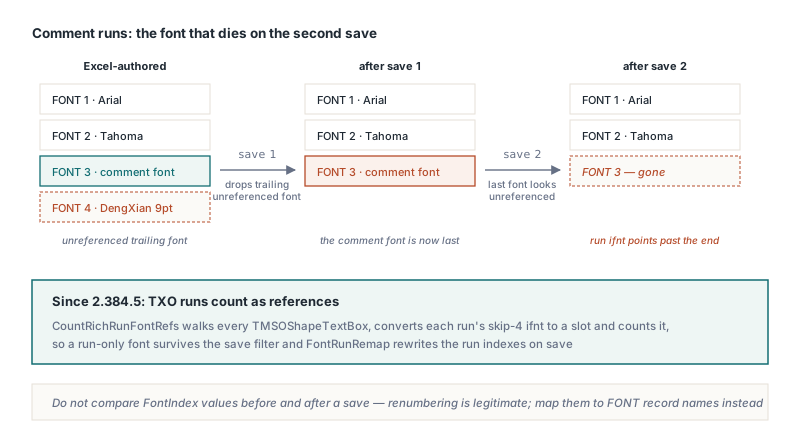
HotXLS 对待批注与文本框 run 的方式与对待共享字符串 run 相同。字体表压缩之前,每张工作表上的每个 run 都从跳 4 的 FontIndex 换算成表槽位并计为一次引用,只被 run 使用的字体因此得以保留。输出途中,run 走与 XF 记录重编号相同的槽位到保存索引映射表。收尾的 TxOLastRun 条目不带字体,按读取时的原样写出。正因为有这层重编号,保存前后比较 FontIndex 值说明不了任何问题;要比较的是它们解析到的字体名
复制、插行与跨工作簿的 run
在经典引擎里,Range.Copy、CopyRange、Sheets.AddCopy 以及 Range.Insert 和 Range.Delete 背后的单元格位移,全都走同一条单元格复制路径;位移不过是复制加清除。如果复制只带批注文本和作者,一次插行就能把两 run 的批注变成单字体批注——用户根本没碰过那条批注
HotXLS 复制每个 run 的起始偏移和字体,连同文本一起。同一工作簿内 FontIndex 原样复用;跨工作簿时字体按值迁移:跳 4 编号换成槽位,字体按属性在目标字体表里匹配或新增,得到的槽位再换回文件编号。Sheets.AddCopy 把一张工作表复制进另一个工作簿时,共享字符串里的富文本也走同一转换,两种 run 因此不会漂移分开。字体表一侧遵循与公式侧相同的按值方式,见跨工作簿复制与公式重绑
为这些行为写测试时,有两个边界情况值得知道:
- 源与目标解析到同一条批注的原地粘贴会保留自己的 run;在读到它们之前什么都不清空
Sheets.AddCopy还会复制附着在没有存储单元格记录的单元格上的批注——只遍历已存储单元格的循环会漏掉它们
XLSX 引擎上,复制按值克隆批注 run,批注部件以 rFont、strike、u 和 vertAlign 读写。run 的字体名、删除线、下划线与上下标设置因此在保存再重开之后原样回来
一个能扛住重编号的回归测试
本文的每个陷阱都能通过内存测试。从零起算的误读住在一对配套的写入器和读取器里,批注字体的丢失需要两次保存,XLSX 上丢失的批注 run 只有重开之后才现形。所以测试必须从磁盘重开、至少跑两代保存、检查 run 结构而不是原始字体编号。从一份 Excel 自己保存的工作簿出发,C2 上放一条两 run 的批注,第二条 run 用一个文件里其他地方都不引用的字体——那正是第二次保存本来会丢掉的那个字体
procedure CheckNoteAcrossTwoSaves(const SrcFile, Out1, Out2: string);
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  RunCount: Integer;
  SecondRunAt: Word;
begin
  // Assert 调用是你自己的测试检查
  Book := TXLSWorkbook.Create;
  Assert(Book.Open(SrcFile) = 1);          // Excel 保存的,C2 有两个 run
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  Assert(Note <> nil);
  RunCount := Note.TextRuns.Count;
  SecondRunAt := Note.TextRuns.CharIndex[2];

  Book.Sheets[1].Range['C2', 'C2'].Copy(Book.Sheets[1].Range['E5', 'E5']);
  Book.Sheets[1].Range['C1', 'C1'].Insert(xlShiftDown);   // C2 移到 C3
  Assert(Book.SaveAs(Out1) = 1);

  Book := TXLSWorkbook.Create;               // 第二代
  Assert(Book.Open(Out1) = 1);
  Assert(Book.SaveAs(Out2) = 1);

  Book := TXLSWorkbook.Create;               // 重开,永远别信内存
  Assert(Book.Open(Out2) = 1);
  Note := Book.Sheets[1].Range['C3', 'C3'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
  Assert(Note.TextRuns.CharIndex[2] = SecondRunAt);
  Assert(Note.TextRuns.FontIndex[2] <> 4);
  Note := Book.Sheets[1].Range['E5', 'E5'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
end;
run 数和起始偏移能抓住被压平的批注。字体本身还需要测试之外的一步:在记录查看器里打开 Out2,把每个 run 的 ifnt 过一遍 FontIndexToRecordNo,确认落点 FONT 记录带的字体名与源文件一致。在 Excel 里,丢失的字体表现为 C3 批注第二条 run 上的默认字型
经典 XLS 仍出现在大量 Delphi 和 C++Builder 项目里,而 BIFF8 文件里每一个字体消费方都必须就 §2.5.129 达成一致,输出才能在 Excel 里正确打开。HotXLS,Delphi 电子表格组件在单元格格式、共享字符串、批注、文本框和图表之间贯彻跳过 4 的编号,每次保存都重编号 run、跨工作簿按值迁移,并且无需 Excel 或 OLE 自动化即可读写 XLS 和 XLSX